Kotlin 2.4.20のJVM、coroutine、Wasmの変更
whenのtype switch、例外を複製するStackTraceRecoverable、新しいcollection API、Swift exportとWasmのbuild方式を解説します。
Kotlin 2.4.20は2026年9月7日に公開されました。 JVM 21以降のwhenに対するinvokedynamicの利用がstableになり、既定で有効になります。 標準libraryの追加APIにはexperimentalの機能もあり、個別のopt-inが必要です(Kotlin 2.4.20の公式リリースノート)。
whenの型判定をJVMのtype switchへ渡す
複数の型を調べるwhenでは、対象の値にinstanceofを繰り返すbytecodeを生成できます。 2.4.20は条件を満たすwhenについて、JVMのSwitchBootstraps.typeSwitch()を使うinvokedynamicを生成します。 対象の値と型の組み合わせをtype switchで選び、選ばれた分岐へ移る形です(JVMでのbytecode生成)。
sealed interface DeepEvent
data class DataEvent(val count: Int) : DeepEvent
data object EndEvent : DeepEvent

fun eligible(event: DeepEvent): Int = when (event) {
    is DataEvent -> event.count
    is EndEvent -> -1
}
Kotlin 2.4.20で-jvm-target 21を指定すると、eligibleへinvokedynamicとtableswitchを生成します。 分岐が返す値は、元のwhenと同じです。
println(eligible(DataEvent(2))) // => 2
println(eligible(EndEvent))     // => -1
適用には、else以外の条件がisかnullの判定であることなどの条件があります。 guardのifを含まず、else以外に少なくとも2つの条件が必要です。 mutable collectionやfunction typeのように、単純な型判定だけでは区別できない型も対象外です(invokedynamicを使う条件)。
is EndEventを値との比較であるEndEventへ変えると、適用条件から外れます。 値を比較する版はinstanceofとareEqualを使い、typeSwitchを生成しません。 JVM 21を対象にするだけで、任意のwhenがtype switchへ変わるわけではありません。
type switchは、対象の値から分岐のindexを求める
eligibleのbytecodeは、対象のobjectと整数0をstackへ積み、invokedynamicでtype switchを呼びます。 返り値は分岐を示す整数で、後ろのtableswitchが実際の処理へ進みます。 0がDataEvent、1がEndEventに対応し、DataEventの分岐ではcastしてcountを取得します。 型の選択は、JVMのbootstrapが設定するcall siteへ渡します。 sourceからJavaのreflection APIを1個ずつ呼ぶ実装ではありません(SwitchBootstraps.typeSwitch)。
tableswitchへ置き換えた後も、各分岐のbodyはKotlinの元の処理です。 最適化は、型に対応する分岐を選ぶbytecodeの形を変更します。 sealedな型の宣言をJavaのenumへ変換したり、DataEventのfieldを整数のtagへ置き換えたりする機能ではありません。 元のobjectを選択した型として扱うcastと、fieldを取得する呼び出しは残っています。
SwitchBootstraps.typeSwitchはJVM 21以降を対象にした入口です。 compilerを新しくしただけで、JVM target 17へ同じ呼び出しを出すわけではありません。 -jvm-target 17では、eligibleにもinstanceofを繰り返すbytecodeを生成します。 -jvm-target 21ではinvokedynamicとtableswitchです。 同じKotlin 2.4.20のcompilerでも、生成先のJVM targetが選択を変えています。
guardと値の比較が、型だけの選択から外れる理由
whenのguardは、型に一致した後で値の条件も検査します。 is DataEvent if event.count > 0は、同じDataEventでもcountによって分岐を変えます。 JVM target 21でも、guardedはinstanceof、countの取得、整数の比較を使い、type switchにはなりません。 型が分かっただけでは分岐先が1個に定まらないため、今回の適用条件からguardを除いています(whenのguardとbytecode生成)。
EndEventという値を直接caseに書く形では、Kotlinの等価比較の規則で判定します。 is EndEventは型の検査です。 EndEventを使う両方の条件で同じ分岐へ進めても、sourceで要求するoperationの種類は異なります。 値を直接比較する版のbytecodeには、EndEvent.INSTANCEを取得してIntrinsics.areEqualを呼ぶ処理が残ります。 compilerは、型を並べる構文と、任意の値の等価性を求める構文を、無条件に同じtype switchへまとめてはいません。
mutable collectionの型判定も、JVMのinstanceofだけでは完了しない場合があります。 Kotlinがread-onlyとmutableを区別する型を、JVMの同じinterfaceへ対応付けるため、Kotlin側の型の意味を保つ追加の判定が関係します。 function typeでも、単純なclassの一致だけで必要な型検査を完了できるとは限りません。 条件がすべてisに見えても、直接type switchへ渡せる型に限るという制約が残ります。 2.4.20でstableになるのは適用条件を満たす生成方式であり、任意の型検査を同じ1命令へ変える規則ではありません(KotlinのJVM向け生成条件)。
whenにelse以外の条件が少なくとも2個必要で、すべて同じsubjectを検査する条件もあります。 subjectを持たず、各行へ異なるBoolean式を書くwhenは、type switchへ変換する対象ではありません。 別のobjectを調べる条件や、値の計算を伴う条件を混ぜた場合には、各式の意味を保存する必要があります。 bytecodeを短くする変換と、sourceに書いた判定の意味を変える変換を、同じ最適化として扱うことはできません。 JVM targetとcaseの型判定、値の比較、guardの有無が、type switchを生成する条件になります。
coroutineの例外を、追加fieldを保ったまま複製する
coroutineのstack trace recoveryでは、例外が発生した場所と、別のcoroutineへ伝播した場所を結ぶstack情報を持たせます。 kotlinx.coroutinesは元の例外を複製しますが、line番号やerror codeをconstructorに要求する例外は、messageとcauseだけから複製できません。 新しいStackTraceRecoverableを実装すると、例外自身が複製方法を定義できます(StackTraceRecoverableのAPI)。
import kotlin.coroutines.ExperimentalStdlibCoroutineSupportApi
import kotlin.coroutines.debug.StackTraceRecoverable

@OptIn(ExperimentalStdlibCoroutineSupportApi::class)
class ParseFailure private constructor(
    val offset: Int,
    cause: Throwable?,
) : IllegalStateException("Invalid token at $offset", cause),
    StackTraceRecoverable<ParseFailure> {
    constructor(offset: Int) : this(offset, null)

    override fun copyForStackTraceRecovery(): ParseFailure =
        ParseFailure(offset, this)
}
copyForStackTraceRecovery()の直接呼び出しでは、offsetと元の例外への参照を引き継ぎます。
val original = ParseFailure(17)
val recovered = original.copyForStackTraceRecovery()
println(recovered.offset)           // => 17
println(recovered.cause === original) // => true
元の例外をcauseにしながら固有のfieldを引き継ぐ実装なので、複製時に追加情報を失いません。
copyForStackTraceRecovery()は、複製しない場合にnullを返すこともできます。 interfaceは全targetに存在しますが、kotlinx.coroutinesがstack trace recoveryに使うのはJVMです。 APIはexperimentalで、宣言と利用の両方にopt-inが必要です(stack trace recoveryの適用範囲)。
messageとcauseだけでは復元できない例外を扱う
JVMの例外のstack traceは、通常、例外objectを作った実行経路に対応します。 例外を別のcoroutineが受け取り、後から再送出すると、受け取った側の論理的な呼び出し経路は、元のstackへ自動で追加されません。 stack trace recoveryは、例外を複製し、受け取った側の経路を含むstackへ置き換えるための規約です。 例外objectのidentityを保存したまま、元のstackだけを読む動作とは、保持する情報が異なります(StackTraceRecoverableが扱う伝播)。
従来のheuristicな複製では、既知の形のconstructorを探せます。 messageとcauseを受け取る形、片方だけを受け取る形、引数なしの形などです。 しかし、ParseFailure(offset: Int)は、整数の位置を必要とします。 messageの文字列からoffsetをparseし直す方法は、例外固有の書式を知らないframeworkへ一般化できません。 追加したinterfaceのmethodでは、例外自身がoffsetを読み、同じclassの新しいinstanceを作ります。 frameworkが例外固有のfieldやconstructorの意味を推測する代わりに、型を定義した側が必要な状態を引き継ぎます。
ParseFailureのprivate constructorは、offsetとcauseを両方受け取れます。 通常の呼び出し元にはoffsetだけを受け取るconstructorを公開し、複製するmethodからは元の例外をcauseとして渡します。 したがって、例外を最初に作るAPIと、recovery用に複製するAPIで、渡す情報が異なります。 同じmessageを持つだけの別の例外へ置き換えた結果ではなく、業務上の位置情報と原因の連鎖を両方引き継いでいます。
copyを拒否する結果と、copyに残す情報
copyForStackTraceRecoveryの返り値はnullableです。 例外を複製したくない場合はnullを返し、複製をしない方針を明示できます。 適切なconstructorが見つかる例外であっても、固有のidentityや内部状態を保存したい場合に、heuristicなcopyから外す入口になります。 nullを返しても、例外を握り潰して処理を成功へ変える意味にはなりません。 recoveryのためのcopyを拒否する結果です(copyForStackTraceRecoveryの契約)。
copyのstack traceは、後続のrecovery機構がThrowable.setStackTraceで上書きします。 copyを作るmethodの中で独自にstackを設定しても、後から上書きされます。 元の例外をcauseへ残せば、作成時の経路と、recovery後の経路を別の例外として追えます。 一方、元のsuppressed exceptionsを無条件にcopyすると、例外の循環を作る可能性があります。 APIの契約は、suppressed exceptionsをcopyしないことも推奨しています。
messageを変更したcopyも許可されますが、copyした例外がさらに別の伝播でrecoveryされる場合があります。 呼ぶたびに同じprefixを加える実装なら、伝播の回数だけmessageが伸びる結果になります。 元のmessageを別に保存するなど、再度copyされる入力も扱える設計が必要です。 ParseFailureはoffsetからmessageを組み立て直すため、元のmessageへprefixを重ねません。 fieldの保存と、messageの表示を、複製のたびに同じ規則へ対応付けています。
interfaceは標準libraryの宣言ですが、stack traceを再構成するのは非同期framework側です。 copyForStackTraceRecovery()が担うのは、固有のfieldとcauseを保存した例外の複製です。 coroutine間の伝播に対応するstackを組み立てる処理は、framework側に残ります。 JVM以外にもinterfaceの型は存在しますが、kotlinx.coroutinesの当該recoveryはJVM向けです。 同じmethodを実装した事実だけから、すべてのtargetで同じstack情報が付くとは言えません(標準libraryのinterfaceとJVMのrecovery)。
全要素の一致と重複を直接検査する
allDistinctはすべての要素が異なるか、allEqualはすべての要素が等しいかを返します。 選択したkeyで比べるallDistinctByとallEqualByもあります。 collection、sequence、arrayに対応します。 比較にはstructural equalityを使います(allDistinctのAPI、KEEP discussion)。
@OptIn(ExperimentalStdlibApi::class)
fun main() {
    println(listOf("A", "a").allDistinct())
    println(listOf("A", "a").allDistinctBy { it.lowercase() })
    println(emptyList<Int>().allEqual())
    println(sequenceOf(3, 3, 3).allEqual())
}
出力はtrue、false、true、trueです。 文字列を直接比べると"A"と"a"は異なりますが、lowercase()をkeyにすると同じ値になります。 空のcollectionへ適用したallEqualも、trueを返します。 APIはexperimentalで、ExperimentalStdlibApiへのopt-inが必要です(collection APIの追加)。
Booleanを返すために、反例を見つけた時点で列挙を止める
allDistinctは、全要素を新しいcollectionへ変換して返すAPIではありません。 1を2回返すsequenceでは、2個目で重複が確定します。 3個目を要求しないため、重複の後に置いた例外も発生しません。
@OptIn(ExperimentalStdlibApi::class)
fun distinctExample() {
    var reads = 0
    val duplicate = sequence {
        reads++
        yield(1)
        reads++
        yield(1)
        error("read after duplicate")
    }
    println("${duplicate.allDistinct()}/$reads") // => false/2
}
distinct().count() == count()のように全体の列挙を必要とする構成とは、処理を止められる位置が異なります(allDistinctの早期終了)。
allEqualでも、最初と異なる要素を見つけた時点でfalseになります。 1、2、例外というsequenceも、2個目で相違が確定し、例外の位置へ到達しません。 反対に、すべて同じ値だったと結論するには、有限のsequenceを最後まで読む必要があります。 無限に同じ値が続く入力では、相違を発見せず、終端にも到達しないため、trueを返す時点がありません。 早期終了できる反例と、入力全体を読む成功条件を別に持つterminal operationです(allEqualのsequence API)。
allDistinctの汎用的なIterable実装は、すでに現れた値をHashSetへ保存します。 先頭から読むたびにsetへ追加し、すでに存在する値ならfalseを返します。 空か1要素なら、setを作らずtrueにする経路もあります。 allEqualの実装は、先頭の値と後続の値を順に比較するので、過去の値すべてを保存する必要はありません。 同じBooleanを返す検査でも、重複を検出する条件と全一致の条件では、保持する状態が異なります(Kotlin 2.4.20のIterable実装)。
allDistinctByは、要素にselectorを適用し、返されたkeyを保存して比較します。 たとえば大小文字を区別しない名前なら、lowercase()で作ったkeyの重複を検出します。 ただし、入力の文字列を小文字へ置き換える処理ではありません。 元のcollectionを変更せず、検査する同一性の条件だけをselectorへ移します。 selectorが高価な計算や副作用を持つ場合には、早期終了した位置までの呼び出しだけが実行される操作になります(allDistinctBy)。
NaNと符号付きzeroは、genericな等価性の規則で比較する
listOf(Double.NaN, Double.NaN).allEqual()はtrueです。 listOf(-0.0, 0.0).allDistinct()もtrueです。 浮動小数点の要素については、NaN同士を等しい値として扱い、負のzeroと正のzeroを異なる値として扱います。 比較はDouble.equalsと同じ規則です。 浮動小数点の式として直接比較するIEEE 754の結果とは異なります(allDistinctの浮動小数点の契約)。
listOf<Int?>(null, null).allDistinct()はfalseです。 nullも要素として扱われ、2回現れれば重複になります。 一方、空のlistでは両方の検査がtrueになります。 1要素の場合にも、異なる2要素や相違する後続要素が存在しないためtrueになります。 空の入力を未判定の状態やerrorとして扱う契約ではなく、Booleanとしてtrueを返す条件が定められています。
allEqualByでは、最初の要素から得たkeyと、後続の要素のkeyを比較します。 たとえば同じ拡張子のpathだけかを検査する処理では、pathの全文が違っても、keyが等しければtrueになり得ます。 要素の等価性と、選択した属性の等価性を、異なるAPI名で表しています。 返り値がtrueでも、元のobject同士が同じinstanceであることや、すべてのfieldが同じであることまで意味しません。 selectorが捨てた情報は、Booleanの判定条件へ含まれません(allEqualBy)。
kotlin.testのassertionには、失敗messageをlambdaで渡すoverloadが追加されています。 成功時にはmessageを組み立てず、失敗時にだけlambdaを実行します。 対象はassertTrue、assertEquals、assertContentEqualsなどです。 ExperimentalKotlinTestApiへのopt-inが必要です(lazy assertion messageのKEEP)。
assertionが成功した経路では、messageの計算を呼ばない
従来の文字列の引数では、assertionを呼ぶ前にmessageの式を評価します。 大きいcollectionを文字列へ変換したり、診断用のobjectを組み立てたりする処理も、成功するtestで実行されます。 lambdaを受け取るoverloadでは、失敗したときにだけmessageを作ります。 成功するassertionでは、messageのlambdaを呼びません。
@OptIn(ExperimentalKotlinTestApi::class)
fun lazyMessageExample() {
    var messages = 0
    assertTrue(true) { messages++; "unexpected failure" }
    println(messages) // => 0
    try {
        assertEquals(1, 2) { messages++; "different values" }
    } catch (failure: AssertionError) {
        println(failure.message?.contains("different values")) // => true
    }
    println(messages) // => 1
}
messageを遅延しても、比較対象のexpectedとactualを計算する処理は必要です。 assertion全体を実行しない機能ではなく、失敗時にしか使わないmessageの計算を分離します。 lambda内の副作用も成功時には発生しないため、testに必要な状態の更新をmessageへ置く構成は、文字列を先に作る構成と同じ実行順序にはなりません。 messagesの加算をlambdaへ置くと、失敗したassertionだけがcounterを増やします。 診断の構築を遅らせても、assertionの判定条件や実行時点は変わりません(KEEP 465のlazy messageの意味)。
Swift exportはsealed hierarchyをSwift enumへ対応付ける
Kotlin/NativeのSwift exportでは、sealed classとsealed interfaceの対応が加わりました。 exportされた値のsealedType()が、直接の派生型に対応するcaseを持つSwift enumを返します。 Swift側のswitchでcaseを列挙し、処理の不足を検査できます。 Kotlinで派生型を追加すると、対応するcaseも変わります(Swift exportのsealed class)。
sealedType()で直接の派生型をSwiftのcaseへ渡す
Kotlinでsealed interfaceを宣言しても、以前のSwift側の型だけでは、派生型の集合を列挙できませんでした。 Swiftのswitchへdefaultを置いた場合、新しい派生型をKotlin側へ追加しても、defaultへ入り処理の不足を検出できない場合があります。 新しいexportでは、直接の派生型に対応するcaseを持つenumを生成し、sealedType()から取得します。 Swiftのcompilerでenumのcaseを列挙できるため、defaultでまとめずに分岐を書けます(sealed hierarchyのSwiftへの対応)。
公式の例では、Shapeを直接実装するCircleとRectangleが、Swift側の.circleと.rectangleへ対応します。 caseに関連付いた値から、対応するKotlinの型の値へ進めます。 型を判定するためにSwift側で文字列のclass名を比較する処理ではありません。 Kotlinの継承関係をexport時にenumのcaseへ反映し、Swiftが扱う分岐の集合として公開します。 sealedType()は、元のKotlin objectのすべてのfieldを別のSwift structへcopyするためのmethodではなく、型の選択を表す入口です。
多段のhierarchyでは、1回のsealedType()がすべての末端を平らに列挙するわけではありません。 直接の派生型へ分岐した後、派生型もsealedなら、さらにsealedType()を呼んで次の階層へ進みます。 したがって、階層の途中を追加する変更と、途中の型の下へcaseを追加する変更は、Swift側で不足が現れるswitchの位置が異なります。 基底型から直接派生する型の集合を渡すという契約が、入れ子の分岐にも保存されます。 defaultで未知の末端を一括処理する構成とは、型の追加を検出する範囲が異なります。
cross-language inheritanceでは、Kotlin側で宣言したbase classをSwift側で継承し、KotlinのinterfaceをSwiftで実装できます。 Swift objectをinterface型の引数としてKotlinへ戻すと、KotlinからSwift側の実装を呼び出せます。 Swiftのlibraryを使う処理をinterfaceの背後に実装するreverse importの形です(Swift exportとcross-language inheritance)。
Swiftの実装をKotlinのinterfaceへ戻す呼び出し経路
reverse importの構成では、Kotlin側が必要な操作をinterfaceとして宣言します。 Swift側は、exportされたKotlinのbase classを継承し、同時にinterfaceの操作を実装します。 Swiftで作ったobjectを、Kotlinのinterfaceを受け取るfunctionへ渡します。 Kotlin側からinterfaceのmemberを呼ぶと、Swiftで書いた実装へ処理が戻ります。 呼び出しの経路は、SwiftからKotlinへ入った後、同じ契約を通じてSwiftへ戻る形です。 SwiftだけからKotlinのfunctionを一方向に呼ぶexportとは、値が戻る向きと実装の所在が異なります(Swift exportのcross-language inheritance)。
たとえばKotlin側が文字列のdigestを求めるinterfaceを持ち、Swift側がSwiftの暗号libraryを使って実装する構成にできます。 KotlinからSwiftのlibraryの宣言を直接importできなくても、Kotlinが定めた引数と返り値の契約を通じて処理を呼べます。 Kotlinが知るのはinterfaceで、platform固有のlibrary名や呼び出し方はSwift側にあります。 新しい継承対応が可能にするのは、境界を通るobjectがKotlinのinterfaceとして振る舞う入口です。 任意のSwift型のすべてのAPIを、Kotlinの型systemへ自動で公開する機能ではありません。
exportされるmodule名やpackageの対応も、Swiftの呼び出し元が名前を解決する条件になります。 Kotlinのmoduleは個別のSwift moduleへ対応し、設定ではroot moduleやexportするdependencyのmodule名を指定できます。 flattenPackageを指定すると、選んだpackageのprefixを生成するSwift側の名前から外せます。 interfaceを渡す経路が正しくても、Swift側がimportするmoduleと、生成された宣言の名前が合わなければ、sourceの名前解決は成立しません。 cross-language inheritanceと名前の生成は、同じexport工程の異なる出力です(Swift exportのmodule設定)。
Swift exportは2.4.20でもAlphaで、Objective-Cのheaderを経由する従来のexportとは別の生成経路です。 現在の統合では、Xcode側からembedSwiftExportForXcodeを使って生成したmoduleを取り込みます。 sealed hierarchyの新機能が加わった事実だけで、既存のObjective-C向けframeworkを再buildせずに同じSwift enumが現れるわけではありません。 Kotlin側の宣言、Swift exportの生成、Xcodeが参照する生成物という連なりで、Swiftから見えるAPIが決まります(Swift exportとXcodeの統合)。
Nativeのklibに対するincremental compilationはBetaになり、kotlin.incremental.native=trueで有効にできます。 変更のない部分を再利用するbuild機能であり、アプリケーション実行時の処理を変える設定ではありません(Kotlin/Nativeのbuildに関する変更)。
klibのincremental compilationは、Kotlin 1.9.20で導入された機能の安定性と性能を改善した段階です。 2.4.20ではBetaになりましたが、有効化するpropertyは引き続き明示します。 debug buildで変更のない入力を再利用することで、開発時のcompile量を減らす対象になります。 Swift exportの新しいcaseは、API生成の変更です。 incremental compilationの有効化によって、exportの公開範囲が広がるわけではありません。 生成するAPIの意味と、同じ意味の生成物へ到達するまでに再利用するbuild状態が、別に変更されています(klib incremental compilationのBeta化)。
Wasmはbuildの単位を選べる
Kotlin/Wasmの既定のmonolithは、projectと依存先をまとめて1つのbinaryへcompileします。 全体の到達可能性を使って不要な宣言を取り除けますが、moduleを独立したbinaryとして更新する方式ではありません。 2.4.20には、moduleごとに再compileしbinaryを分割するmodeが追加されています(Wasmのcompilation mode)。
multimodule-open-worldはmoduleを独立してcompileし、独立したbinaryを生成します。 変更したmoduleだけを再compileできますが、moduleをまたぐ最適化は行いません。 multimodule-closed-worldは全moduleを1回の起動で処理します。 変更したmoduleを再compileし、互いに依存するbinaryを出力します(multi-module modeの違い)。
moduleを個別にcompileできる条件と、全体を最適化できる条件
monolithは、projectとdependencyをまとめて扱い、最終的に1個のbinaryを生成します。 全体の到達可能性を判定できるので、使わない宣言を除くdead code eliminationを広く適用できます。 一方、UIの小さい変更でも、配布する単一binaryを作る工程にはproject全体の情報が関係します。 binaryを1個へまとめる範囲と、moduleを1個だけ再compileする範囲は異なります。 開発中の更新量を減らす要求が、複数moduleのmodeを追加した背景になります(Kotlin/Wasmのcompilation mode)。
open-worldでは、moduleを独立にcompileします。 独立したbinaryを作るため、他のmoduleの実装へ踏み込む最適化は行いません。 たとえばcore、UI、applicationに分けた構成で、公開する契約を変えずにUIの実装だけを変更するなら、UIを独立した再compileの単位として扱う方式です。 単一binaryの全体最適化を維持したまま、任意の部分だけを入れ替える機能ではありません。 独立性を得る代わりに、moduleをまたいだ最適化の範囲を制限します。
closed-worldは、全moduleを1回のcompiler起動で扱います。 変更したmoduleを再compileしてから、相互に依存するbinaryを分けて出力します。 moduleごとのbinaryは、open-worldのような独立した生成物ではありません。 最適化は生成するbinaryの単位で適用するため、出力が複数になっても、すべての最適化がmonolithと同一になるという契約ではありません。 入力をまとめて把握する範囲、再compileする単位、生成するbinaryの関係が、modeごとに変わります。
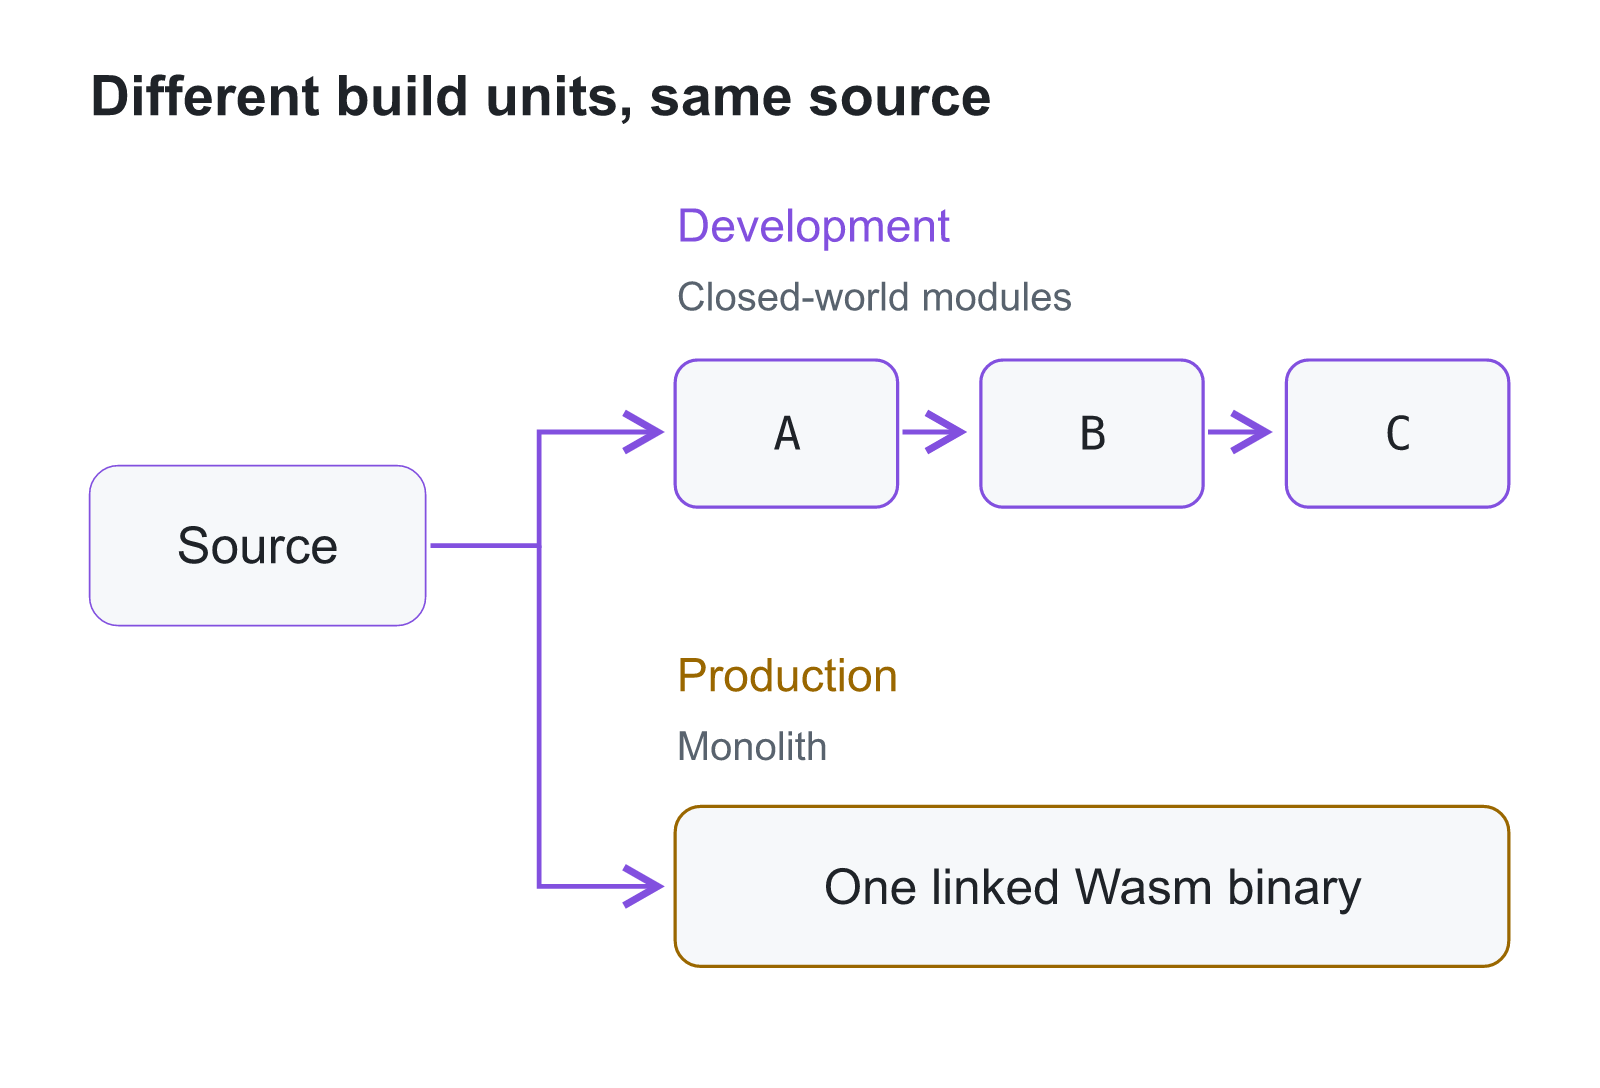
kotlin.wasm.compilationModeにはmultimodule-closed-world-only-in-devも指定できます。 開発buildはclosed-world、配布buildはmonolithになります。 開発時の再compileの単位と、配布するbinaryの構成を別に選ぶ設定です。 lambdaとfunctional interfaceの実装も変わりました。 個別のanonymous classを作らず、functionと共有base classを使います(Wasmのbinary生成)。
multimodule-closed-world-only-in-devを指定した場合、開発用と配布用で同じbinary構成を使う前提にはなりません。 開発中はmoduleを分け、配布時にはmonolithへ戻します。 開発時の変更を反映する工程と、最終的に配るbinaryのsizeを抑える工程を、別の設定に対応付けられます。 ただし、開発時のbinary分割は、production buildで同じ形のcacheや生成物を再利用できる保証ではありません。 modeを選ぶpropertyは、compilerへの入力だけでなく、生成物の構成を変える設定です。
lambdaの実装の変更も、binaryへ含める構造を減らす対象です。 従来の方式では、lambdaやfunctional interfaceの実装ごとにanonymous classを生成していました。 新しい方式はfunctionを生成し、共有base classを使うため、個別のclassの構造を繰り返し含める量を減らします。 公式のKotlinConf applicationの比較では、Wasm binaryのsizeが約5〜10%減ったと報告されています。 同じ割合が任意のprogramへ適用されるという値ではなく、lambdaやfunctional interfaceを使う構成に対する実装変更の測定です(Wasmのlambda生成の変更)。
共有する実装へ移すことで、dynamicな呼び出しが増える面もあります。 したがって、binaryのsizeが小さくなった事実だけから、すべての処理が同じ割合で速くなるとは言えません。 sizeに影響するのは生成するclassやfunctionの構成で、実行時間には実際の呼び出し経路とruntimeの最適化も関係します。 compilation modeの選択によるbuild時間の差とも、測定する工程が違います。 2.4.20のWasmの変更では、開発時のcompile量と、配布するbinaryの構造に対する操作を個別に追加しています。
Wasmの相互運用では、@JsFun内のtop-levelのrequire()がerrorになりました。 従来compilerが生成していたrequireの公開をやめたためで、静的なmodule読み込みには@JsModuleを使います。 companion objectの初期化順も、superclassをsubclassより先に初期化する順へ揃っています。 WASI targetにはWasmtimeを使うwasmWasi { wasmtime() }も追加されています(Kotlin/Wasmの相互運用と実行環境)。
compiler内部のrequireを、公開された読み込みAPIとして使わない
以前は、compilerが生成するimport-object.mjsにrequire変数があり、@JsFunから参照できました。 しかし、生成したfileの内部変数を、利用側へ公開するAPIとして定めたものではありませんでした。 2.4.20は生成する宣言を取り除き、top-levelのrequire()を使う@JsFunへerrorを出します。 生成物の内部に存在した名前を使うsourceでは、読み込みの経路を変更する必要があります(top-levelのrequireの削除)。
静的に読み込むmodule名が分かっている場合には、@JsModuleで外部moduleの宣言へ対応付けます。 dynamicな読み込みではJavaScriptのimport()を使う経路があります。 静的なdependencyを宣言することと、実行時の条件で読み込むことは、同じ文字列の呼び出しへ置換するだけの変更ではありません。 bundlerによるdynamic importの解析も関係するため、公式の例にはwebpackの解析から外す指定が含まれています。 Kotlinのannotation、JavaScriptの読み込み構文、bundlerが解析する入力の3段階へ影響する移行です。
companion objectの初期化順は、superclassをsubclassより先にする順序へ揃います。 中間のclassにcompanion objectがない場合にも、上位のclassの初期化を省略してよい条件にはなりません。 たとえば上位のcompanionが設定値を初期化し、下位のcompanionが設定値を読む構成では、読む側より先に上位の初期化を行います。 JVMとWasmで異なっていた順序を揃える変更です。 companion内の表示や登録など、副作用の順序も変わり得ます(companion objectの初期化順の変更)。
Wasmtimeの追加は、wasmWasiの実行先をKotlin Gradle pluginから選ぶ入口です。 browser向けのwasmJsをWASIのprogramへ変換する設定ではありません。 browserのDOMやJavaScriptのmoduleを使う構成と、WASIのhost機能を使う構成では、実行時に用意する依存が異なります。 生成するWasm binaryのtargetと、起動するruntimeを対応付けるために、wasmWasi { wasmtime() }を使います。 moduleの分割modeとは、選択する対象が異なるGradleの設定です(Wasmtimeの実行設定)。
Kotlin/JSとbuild toolの変更
Kotlin/JSでは、suspending lambdaをJavaScriptのasync functionとしてexportできます。 有効化するcompiler optionは-Xsuspend-lambda-exportingです。 data classのconstructorやpropertyに付けた@JsExport.Ignoreの扱いも修正されました。 生成されるcopyやcomponentNが、非公開にした型に対する不要な警告を出さなくなります(Kotlin/JSのexport)。
suspending lambdaをJavaScriptのasync functionとして受け取る
Kotlin側のAPIがsuspend () -> Stringをparameterに持つ場合、通常のfunctionを受け取るAPIとは継続の規約が異なります。 新しいexportでは、JavaScript側のasync functionを、Kotlinのsuspending lambdaへ対応付けます。 公式のTaskRunnerの例では、TypeScript側がasync () => "done"を渡し、await runner.runTask(...)で文字列を取得します。 callbackの中で非同期に処理する契約と、戻り値を待つ契約を、JavaScriptのasyncとawaitで表せる入口です(suspending lambdaのexport)。
有効化には-Xsuspend-lambda-exportingをcompiler optionへ追加し、公開する宣言へ@JsExportを付けます。 Kotlinのすべての内部lambdaを、無条件にJavaScriptへexportする設定ではありません。 exportするclassやmemberのsignatureが、JavaScript側の公開APIへ変換されます。 Kotlin内部でsuspendを使う事実と、境界を越えるsuspendingなfunction typeを公開することを区別します。 2.4.20が追加するのは、以前exportできなかったsuspending lambdaを含む宣言のbridgeです。
data classのexportでは、手で宣言したmember以外も公開する型の検査へ関わります。 たとえば接続objectを保持するpropertyを@JsExport.Ignoreで外した場合です。 compilerが生成するcopyやcomponentNは、同じ内部型をsignatureへ含める場合があります。 以前は、constructorやpropertyを除外した意図が生成memberへ十分に反映されず、exportできない型のwarningが残っていました。 2.4.20は、生成memberについてもIgnoreの条件を考慮します。 classをexportする判断と、classから自動生成するAPIの範囲を整合させる修正です(synthetic functionのexportabilityの修正)。
browser testには、Playwrightをbrowser driver、Mochaをtest runnerとして使うexperimental DSLが加わりました。 Gradleのbrowser内にtestを宣言して使い、ExperimentalJsTestDslへのopt-inが必要です。 Karmaを使う従来の仕組みから移るための機能として導入されています(Kotlin/JSのbrowser testing)。
browser driverとtest runnerを別の役割として設定する
新しいDSLのPlaywrightは、browserの起動と配布を管理します。 Mochaはtestを実行するrunnerで、2.4.20時点のbundlerはwebpackです。 browser testでは、KotlinをJavaScriptへcompileして実行用fileをまとめます。 browserを起動するdriverと、testの成功や失敗を記録するrunnerは別の役割です。 DSLが増えたことを、test frameworkの名前1個だけを置き換える変更として説明すると、管理する依存の範囲を取り違えます(新しいbrowser testing DSLの構成)。
chromium()、firefox()、webkit()で実行するengineを選びます。 新しいDSLでは、初回の実行時にPlaywrightが必要なbrowserをinstallし、配置を管理します。 systemへ普段使うbrowserが入っていることだけを前提にする構成とは、binaryの取得と選択の条件が異なります。 Karmaを使うtestTaskと、新しいDSLのtestは別のblockであり、設定の名前も同じではありません。 ExperimentalJsTestDslのopt-inは、新しい入口へ指定します(browserの設定とinstall)。
共通のtimeoutやheadlessの設定を持たせ、個別のrunnerで上書きする構成もできます。 たとえば全runnerへ共通の期限を設定し、Chromiumだけ別の期限へ変更する指定です。 Kotlin側のassertionのmessageを遅延する変更とは、testの異なる段階を扱います。 assertionの成否を決める処理はtestの中で動き、browser runnerのtimeoutは実行を待つ側の条件です。 新DSLが一括して管理する設定の中でも、対象のscopeが共通か個別かによって有効な値が変わります。
build tool側では、Gradle Problems APIの診断が問題のIDでgroup化されるようになりました。 Build tools APIにはJS、Wasm、metadataのtargetがexperimentalとして追加されています。 compilerの配布にはnative imageが追加され、実行用commandにはツール名の衝突を避けるkotlinrが導入されています(build toolとcompilerの変更)。
compilerのdiagnostic IDで、Gradleの問題をgroup化する
GradleのProblems APIは、build中の問題を構造化して報告する入口です。 2.4.20のKotlin Gradle pluginは、compilerのdiagnostic IDも情報へ含め、同じIDのdiagnosticをgroup化します。 単に表示messageの文字列が同じかを比較する方式より、compilerが分類した問題を追うための識別情報が残ります。 sourceの位置やmessageが違う複数の報告でも、同じdiagnosticの種類として関連付ける対象になります。 型検査の規則は変わらず、compilerからbuild systemへ伝える報告に識別情報を追加します(Problems APIへのdiagnostic IDの追加)。
Build tools APIは、build systemとKotlin compilerの間へ共通の入口を用意するAPIです。 2.4.20では、従来のJVMに加えてJS、Wasm、metadataのtargetへexperimentalな対応を追加します。 有効化するpropertyは、JSがkotlin.js.runViaBuildToolsApi=true、Wasmがkotlin.wasm.runViaBuildToolsApi=trueです。 metadataにはkotlin.metadata.runViaBuildToolsApi=trueを使います。 同じcompilerを呼ぶための統合経路を選ぶ設定であり、targetをJSからWasmへ変更する設定ではありません(Build tools APIのtargetごとの有効化)。
kotlinrは、Kotlin runnerのcommand名です。 kotlincというcompilerの名前を、同じ意味で改名する変更ではありません。 従来のkotlinはKotlin Toolchainのcommandと名前が衝突するため、runnerをkotlinrへ分け、旧名で実行した場合には新しい名前を案内するwarningを出します。 sourceをcompileする入口と、compileしたKotlin programを起動する入口を、呼び出すtoolの役割に合わせて区別する変更です(runner commandの変更)。
native imageは、compiler自身をnative executableとして配布するexperimentalな方式です。 通常のkotlincの代替として起動時間を短くする対象ですが、Kotlin/JVMのアプリケーションをKotlin/Nativeへ変更する設定ではありません。 compilerを実行する形式と、compilerが生成するtargetは別です。 配布するnative imageにはcompiler pluginも同梱されます。 Serialization、Compose、All-open、No-argのほか、SAM with receiver、Assignment、Lombok、Power-assertです。 pluginを指定する入口には-Xpluginまたは-Xcompiler-pluginを使います(compiler native imageの配布範囲)。