C# 15を.NET 11 RC2で動かす
unionとclosed hierarchyの網羅性、collection expressionへの引数、extension indexer、memory safetyの変更を解説します。
.NET 11 RC2は2026年10月13日に公開されました。 2026年10月24日時点では正式公開前のSDKであり、C# 15の新機能を含んでいます。 net11.0を対象にするとC# 15が既定で選ばれ、memory safetyに関する追加機能には別途previewの指定が必要です(RC2の公式発表、C# 15の新機能)。
unionは既存の型をcaseとして組み合わせる
unionでは、値として受け付けるcase typeを宣言します。 たとえば検索結果をFoundかMissingに限る場合、共通のinterfaceを実装する代わりに、2つの型をunionへ登録できます。 case typeからunionへのimplicit conversionが生成されるため、呼び出し側で明示的な包装処理を書く必要はありません(unionの宣言と変換)。
public record Found(string Text);
public record Missing;
public union Lookup(Found, Missing);
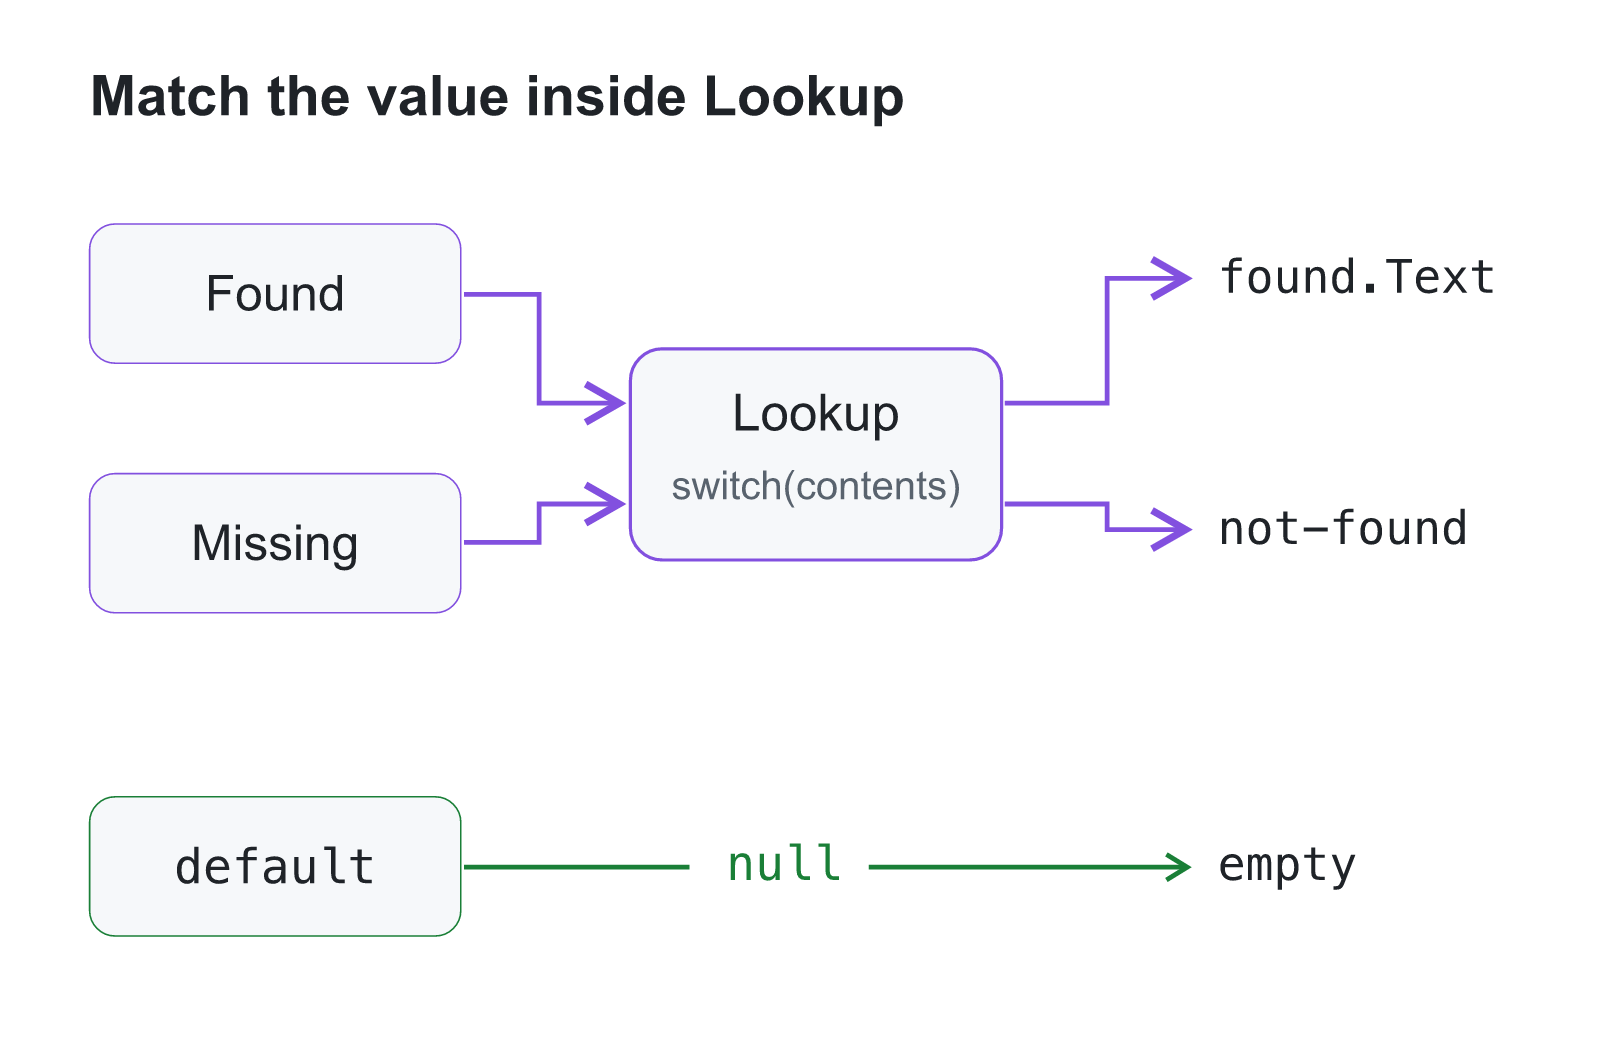
Lookup result = new Found("ready");と代入した値は、type patternで中身を調べられます。 Found foundが取り出すのはunion自体ではなく、保持しているFoundの値です。 switchの網羅性もcase typeを基準に検査されます(unionのpattern matching)。
static string Describe(Lookup result) => result switch
{
    Found found => found.Text,
    Missing => "not-found",
    null => "empty"
};

Lookup result = new Found("ready");
Console.WriteLine(Describe(result)); // => ready
Console.WriteLine(Describe(default)); // => empty
SDK 11.0.100-rc.2.26504.105で実行すると、Describe(new Found("ready"))はreadyを返します。 一方、Describe(default)はemptyです。 生成されるunionは既定値の状態で中身がnullになるため、case typeをすべて書いたことだけでは、既定値まで処理できるとは限りません(unionのnullと既定値)。
生成されたunionは、値をobject?の参照として保持します。 したがってunion Number(int, double)のようにvalue typeをcaseにするとboxingが発生します。 unionを宣言しただけでallocationを避ける専用layoutになるわけではなく、独自の格納方式が必要な場合はcustom unionの実装が別に必要です(unionの格納方式)。
共通の継承関係を作らず、受け付ける型を宣言する
LookupのcaseにしたFoundとMissingは、共通の基底classを持つ必要がありません。 既存のlibraryから受け取る型でも、unionのcaseとして列挙できます。 interfaceへmarkerを追加する方式では、対象の型の宣言を変更できるかが条件になりますが、unionは受け付ける側で型の集合を宣言します。 共通のmemberを呼ぶinterfaceと、結果の型を区別するunionでは、APIに表す情報が異なります。 unionを使う呼び出し側は、caseごとに別のmemberへアクセスできます(unionとinterfaceの役割)。
caseにはclassやstructだけでなく、interface、type parameter、nullable type、別のunionも指定できます。 ただし、格納する値をobjectへ変換できる型である必要があります。 Span<T>のような任意の値を、通常のreferenceとして保持できるわけではありません。 受け付ける型の集合と、値の保存に使えるmemory layoutには別の制約があります。 生成されたunionは単一のobject?を保存するため、value typeの値にはboxingが伴います(case typeとして許可される型)。
整数42をNumberへ変換すると、保持する値のruntime typeはInt32です。
public union Number(int, double);
Number number = 42;
Console.WriteLine(number.Value?.GetType().Name); // => Int32
intとdoubleを同じ大きさのinline領域へ重ね合わせた結果ではなく、保持する値のruntime typeがInt32として残っています。 Cのunionのように、同じbyte列を別のfieldから読み直す意味の構文ではありません。 値の属するcaseを型として扱うための仕組みであり、格納済みの整数のbit列を浮動小数点数として再解釈するAPIにはなりません。
caseからのimplicit conversionは、対応するconstructorを呼ぶ処理です。 ただし、同じ型についてuser-definedなimplicit conversionがあれば、user-definedな変換を優先します。 複数のcaseが同じsourceの値へ同程度に適用できる場合には、compilerが都合のよいcaseを勝手に選ぶのではなく、曖昧さをerrorにします。 たとえばinterfaceをcaseへ含める構成では、sourceが複数のcaseを実装する可能性も型の集合の一部です。 列挙した型が互いに排他的であるという条件を、union宣言が自動的に作るわけではありません(union conversionの優先順位)。
patternの形によって、中身を調べるか、union自身を調べるかが変わる
result is Foundは、保持する値がFoundかを調べます。 result is Found { Text: "payload" }なら、Foundに一致した後、保持するFoundのTextを調べます。 一方、result is { Text: "wrapper" }のように型を指定しないproperty patternは、union自身のTextを読みます。 Lookup自身のTextを"wrapper"、保持するFoundのTextを"payload"にします。 異なる値への2個のpatternが、両方とも成立します(unionに対するpatternの適用対象)。
public union Lookup(Found, Missing)
{
    public string Text => "wrapper";
}
Lookup result = new Found("payload");
Console.WriteLine(result is Found { Text: "payload" }); // => True
Console.WriteLine(result is { Text: "wrapper" });       // => True
var capturedは、中身を取り出すpatternではありません。 入力されたunion自身を変数へ束縛するため、capturedを使ってValueを読む経路になります。 discardの_も、case typeを絞り込む操作ではなく、入力全体へ一致します。 list patternの場合も、保持するcaseのindexerへ自動で切り替えるのではなく、union自身のcountやindexingのmemberを使います。 pattern matchingの構文を短くした結果、常に自動で中身を取り出すという説明では、property patternやlist patternの対象を取り違えます。
空のproperty patternである{ }は、特にnullとの違いが現れます。 nonnullableなstruct union自身は存在するので、Lookup empty = default;に対するempty is { }はTrueです。 一方、empty is not nullはunionの中身を調べるため、結果はFalseです。 通常のreferenceに対して使うと似た条件に見える2つのpatternでも、unionへ適用した場合には同じ意味になりません。 中身の有無を条件にしたい処理で{ }へ書き換えると、既定値のunionを通過させる結果になります(空のproperty patternとnull pattern)。
logical patternを組み合わせた場合にも、各patternの対象は保存されます。 var value and not nullでは、var valueがunionを束縛し、not nullが中身の有無を検査します。 型を指定したFound and { Text: "payload" }では、型の判定後のFoundへproperty patternを適用します。 andを加えるだけで、後ろのpatternが必ずunionの中身へ変わるわけではありません。 前段の型patternが何を絞り込むかに応じて、後段が参照するmemberの対象も決まります。
nullable wrapperがない状態と、空のunionを区別する
生成されるunionはstructなので、Lookup?にはnullable wrapperも加わります。 HasValueはnullable wrapperの有無を返しますが、unionのnull patternは内側の空の状態も受け付けます。
Lookup? absent = null;
Lookup? wrappedEmpty = default(Lookup);
Console.WriteLine(absent.HasValue);       // => False
Console.WriteLine(wrappedEmpty.HasValue); // => True
Console.WriteLine(absent is null);        // => True
Console.WriteLine(wrappedEmpty is null);  // => True
wrappedEmptyにはstructの値が存在していても、値が保持するcaseはnullです。 unionのnull patternは、nullable wrapperの不在だけでなく、中身がnullである状態も受け付けます(nullable unionのnull matching)。
Lookup[]を作った直後の各要素も、structの既定値です。 すべてのcase typeをnonnullableに宣言していても、配列の初期状態で保持する値が自動的にFoundやMissingになるわけではありません。 fieldや配列を通じて既定値が渡るAPIでは、caseの集合だけからruntimeの入力を復元できません。 null armを明示したDescribeは、caseの成功状態と空の状態を別に処理します。 空の状態をMissingと同じ業務上の意味へ対応付けるかは、呼び出し側が定めるAPIの契約です。
nullable analysisが追跡する状態と、runtimeで到達し得るすべての状態も同じではありません。 case typeがすべてnonnullableなら、追跡上は中身がnot-nullとされ、null armの省略を必ずwarningにするわけではありません。 ただし、defaultによる中身のnullは存在します。 したがって、warningがないことだけを、生成されたunionが空にならない証拠にはできません。 defaultが流れる経路を持つ場合には、null patternの意味を使って空の状態を受け取ります(unionのnullable analysisと既定値)。
caseを追加したときに、処理漏れを残さないswitch
DescribeからMissingのarmを削除すると、CS8509を出します。 warningsをerrorにするbuildでは、処理漏れがあるまま成功しません。
static string Describe(Lookup value) => value switch
{
    Found found => found.Text,
    null => "empty"
};
// CS8509: Missing
Foundとnullを処理していても、宣言されたcaseの集合を満たしていないためです。 診断には不足したcaseのMissingが現れるため、nullの扱いとcaseの不足を区別できます。 caseが増えた場合も、個別のarmを列挙したswitchは、不足したcaseを検出する対象になります。
最後のarmを_へ変えると、将来加わるcaseも同じarmへ入ります。 空の状態だけを受け付けたい場合には、null armを使えば、宣言されていない別のcaseまで無条件に受け付ける動作を避けられます。 _を加えればwarningが消えることと、すべてのcaseを意図した処理へ割り当てたことは、異なる結果です。 新しいcaseをAPIの返り値へ追加したとき、switchの最後のarmによって、呼び出し元で受け付ける入力が変わります(caseの網羅性とnull arm)。
custom unionでは、pattern matchingの読み出し経路も実装する
独自のclassやstructへUnionAttributeを付ける場合は、caseごとの生成処理と、保持する値を返すValueを用意します。 単に属性を付けた型の任意のfieldを、compilerがcaseとして探す方式ではありません。 基本のpatternでは、1個の引数を取るpublicなconstructorのparameterからcase typeを定めます。 publicなValueは、object?として中身を返します。 生成されるunionとは異なる格納方式を選べますが、compilerが使う入口の形は規則で決まっています(custom unionの基本pattern)。
value typeをboxingせず取り出す経路には、caseごとのTryGetValue(out T value)を使います。 中身の有無を調べるHasValueも加えられます。 type patternではTryGetValue、null patternではHasValueというように、対応するpatternの種類が異なります。 片方を実装すればもう片方の代わりにもなる、という規則ではありません。 TryGetValueがなければ、type patternでValueを使います。 HasValueがなければ、null patternでValueを使います(non-boxing access pattern)。
Taggedへ整数用field、bool用field、caseを示すbyteのtagを保存すれば、boxingせずに値を取り出す経路を定義できます。 TryGetValue(out int)はtagが整数なら成功し、TryGetValue(out bool)はboolなら成功します。 Valueのgetterには、呼び出し回数を増やすcounterも置いています。
[System.Runtime.CompilerServices.Union]
public struct Tagged : System.Runtime.CompilerServices.IUnion
{
    private readonly int _integer;
    private readonly bool _boolean;
    private readonly byte _tag;
    public static int ValueReads { get; private set; }

    public Tagged(int value) { _integer = value; _tag = 1; }
    public Tagged(bool value) { _boolean = value; _tag = 2; }
    public bool HasValue => _tag != 0;
    public object? Value
    {
        get
        {
            ValueReads++;
            return _tag switch { 1 => _integer, 2 => _boolean, _ => null };
        }
    }
    public bool TryGetValue(out int value) { value = _integer; return _tag == 1; }
    public bool TryGetValue(out bool value) { value = _boolean; return _tag == 2; }
}
整数42から作った値を、int、bool、nullのarmを持つswitchへ渡すと、整数用のTryGetValueを使います。 Valueからobject?を取得して型検査する経路は、実行されません。
Tagged tagged = 42;
Console.WriteLine(tagged switch
{
    int value => $"tagged={value}",
    bool value => $"tagged={value}",
    null => "tagged=empty"
}); // => tagged=42
Console.WriteLine(Tagged.ValueReads); // => 0
読み出し経路を自分で提供する場合には、各memberが同じ内容を表す必要があります。 Valueが整数を返すのに、TryGetValue(out bool)が成功する実装なら、patternが選ぶcaseは矛盾します。 HasValueがfalseなのにValueがnon-nullを返す実装も、中身の有無を一貫して表せません。 compilerはcustom unionが契約を守る前提で網羅性や変換を扱います。 属性の宣言だけで、各memberの実装の一致まで検証するわけではありません(custom unionのsoundness)。
structの既定値についても、custom unionは契約を定めます。 生成されたunionのように必ず空にする方式だけでなく、既定値を有効なcaseとして表す設計も可能です。 ただし、既定値に対するValue、HasValue、TryGetValueの結果を合わせなければなりません。 独自のlayoutを選ぶ利点と、defaultを含めた状態の解釈を実装する責任が、同じAPIの境界にあります。 ValueReadsが数えるのはgetterの呼び出しであり、Tagged以外の処理を含むallocationの個数ではありません。
生成するunionのbodyへは、保持したcaseを使うmethodや計算したpropertyを追加できます。 一方、独自のinstance field、auto-property、field-like eventは追加できません。 格納方式を生成する構文へ、別のinstance状態を自由に混ぜる形ではなく、追加の状態が必要ならcustom union側で設計します。 publicで引数が1個のconstructorも、compilerがcaseごとに生成するconstructorと重なるため、自由に追加する入口ではありません。 独自に宣言するconstructorには、生成したconstructorへ直接または間接に委譲するthis(...) initializerが必要です。 caseの生成経路を使わず、不整合な内部状態を作るconstructorを通常のbodyへ追加する構文にはなっていません(union bodyのmemberとconstructorの制限)。
closedはassemblyの外からの直接継承を止める
unionが既存の型を列挙するのに対し、closedは継承関係を使う型に適用します。 closedなclassは暗黙にabstractとなり、直接継承できる型を同じassemblyに限定します。 compilerが直接の派生型を把握できるため、派生型をすべて扱うswitchにdefault armを書く必要がなくなります(closedの規則)。
public closed record State;
public sealed record Running(int Count) : State;
public sealed record Stopped : State;
派生型を列挙したswitchでは、絞り込んだ型のpropertyを読み取れます。
State state = new Running(3);
Console.WriteLine(state switch
{
    Running running => $"running={running.Count}",
    Stopped => "stopped",
    null => "missing"
}); // => running=3
ただし、継承の制限は自動で子孫すべてに及ぶわけではありません。 直接の派生型を通常の非sealed classにすると、外部assemblyが派生型をさらに継承できます。 末端のRunningとStoppedはsealedです。 中間の階層まで網羅性を保つ場合は、中間の型もclosedにします(closedの継承範囲)。
直接の派生型を閉じても、子孫は自動では閉じない
library側にclosed class Stateと通常のclass OpenState : Stateがあれば、外部assemblyはOpenStateから継承できます。 外部projectからExternalState : OpenStateを宣言するbuildは成功しています。 一方、外部assemblyから直接ExternalState : Stateを宣言すると、CS9382になります。 同じ外部projectでも、直接の基底型がStateかOpenStateかによって、継承の可否が変わります。 closedは、assembly内で派生した後の型を、暗黙にすべてsealedへ変える指定ではありません(closedの直接継承の制限)。
OpenStateを扱うtype patternは、外部assemblyで加わったExternalStateも受け付けます。 したがって、直接の派生型をすべて扱うswitchが網羅的であることと、末端のclass名をすべて知っていることは同じ条件ではありません。 直接の派生型が開いていても、派生型のpatternで子孫を覆います。 末端ごとに処理を分けたいAPIでは、中間の型もclosedにして子孫を列挙するか、sealedで継承を止めます。 型の修飾子によって、許可する拡張の範囲が変わります(closed hierarchyのpattern規則)。
closedなclassは暗黙にabstractです。 基底型のinstanceを直接生成できないため、派生型をすべて覆う条件から、基底型の値の集合を扱えます。 closed abstractのように同じ性質を重ねる指定や、sealed、staticとの組み合わせは許可されません。 closedをclassの修飾子以外でidentifierとして使う場合は、contextual keywordとして通常の名前にもなります。 宣言位置で意味が衝突する場合には@closedとしてidentifierを明示できます(closedの宣言規則)。
genericな派生型にも、可能な型の集合を確定できる条件があります。 たとえばLeaf<T> : Tree<T>では、派生型のparameterが基底型の構成に現れます。 一方、Constant<U> : Tree<int>のように、基底型の構成に現れないUを追加する直接継承は許可されません。 Tree<int>から見たときに、Uへ何を代入した派生型が存在し得るかを基底型から決められないためです。 closedという修飾子だけでなく、genericな型の構成にも、網羅性を検査するための制約があります(closedとgenericな派生型)。
nullableなState?を受け取るswitchでは、派生型のほかにnullも入力になります。 直接の派生型をすべて書いても、nullableな基底型についてnullを覆ったことにはなりません。 unionの空状態と同じ構文でnullを書けますが、closedなclassの場合は、reference自体がnullである条件です。 型の集合を閉じる機能と、nullを許す型の指定は、別の型情報として検査されます(closedのnullableなswitch)。
collection expressionからcomparerを渡す
collection expressionの先頭にwith(...)を書くと、元になるconstructorやfactoryへ引数を渡せます。 HashSet<string>ならcomparerを指定でき、要素の同一性をcollection expression内で決められます。 要素を追加した後でcomparerを変更する処理ではありません(collection expression arguments)。
HashSet<string> names =
    [with(StringComparer.OrdinalIgnoreCase), "Ada", "ada"];
Console.WriteLine($"unique={names.Count}");
出力はunique=1です。 OrdinalIgnoreCaseをconstruction時に渡したため、大小文字だけが異なる2つの要素は同一の値として扱われます。 List<T>のcapacityのような引数にも使えますが、with(...)は任意の位置へ挿入する要素ではなく、先頭に置く引数指定です(collection expressionの引数と適用条件)。
collectionの型を決める段階と、constructorを選ぶ段階
with(...)の引数は、collection expressionのtarget typeが決まった後で、constructorやcollection builderの選択に使われます。 外側のmethodのoverloadを選ぶ際に、引数の内容を手掛かりとしてtarget typeを決める仕組みではありません。 List<string>とHashSet<string>を受け取る2個のUseがある場合、comparerを渡した事実だけでHashSet<string>のoverloadへ確定しません。 comparerを引数に書いても、Useのtarget typeを決められません。 compilerは、曖昧な呼び出しを示すCS0121を出します(collection expression argumentsのoverload解決)。
Use([with(StringComparer.OrdinalIgnoreCase), "one", "ONE"]);
// CS0121
HashSet<string> value = [...]といった変数への代入なら、target typeは宣言から決まります。 代入先の型が決まった後に、comparerを受け取るHashSetのconstructorを選べます。 先に明示した型へ代入してからUse(value)を呼ぶ構成では、外側のoverloadにも引数の型が現れます。 引数を受け付けるconstructorを探して、外側のoverloadを逆算する規則ではありません。 type inferenceとconstructorの選択を別の段階として扱うため、負例は曖昧になります。
容量指定も、要素の型の推論を代替しません。 Use<T>(List<T> values)へ[with(10)]だけを渡しても、10はconstructorのcapacityであり、Tを決める要素ではありません。 要素がない入力からTを推論できない場合には、Use<int>のように型を指定する必要があります。 capacityの数値をintとして書いたことから、collectionの要素もintになる規則ではありません(constructor引数とtype inference)。
容量と要素数は、同じcollectionの別のpropertyです。
List<int> reserved = [with(capacity: 8), 1, 2];
System.Console.WriteLine(reserved.Count);    // => 2
System.Console.WriteLine(reserved.Capacity); // => 8
8個の要素を作って後ろ6個を既定値で埋める構文ではなく、2個の要素を入れる容器に容量の引数を渡しています。 arrayの長さを指定する構文とも異なります。 with(...)はarrayやSpan<T>、ReadOnlySpan<T>をtargetにするcollection expressionでは使えません。 引数があるなら任意のcollection風の型へ適用できるという拡張ではなく、対応する構築経路を持つ型が対象です(constructor引数の適用対象)。
collection builderを持つ型では、with(...)の引数がcreate methodへ渡ります。 要素をまとめたReadOnlySpan<T>は最後のparameterで、追加の設定用引数はspanより前です。 comparerを受け取るfactoryなら、比較規則と要素列を同じ生成処理へ渡せます。 通常のconstructorを呼ぶ型と、builderのcreate methodを呼ぶ型では、同じcollection expressionでも選ばれる入口が異なります。 compilerはtarget typeの構築規則に従って引数を割り当てます(collection builder arguments)。
評価順序では、with(...)の引数を先に評価し、要素の式は左から右へ1回ずつ評価します。 ただし、spreadに渡すGetItems()の呼び出し時点と、返されたsequenceの列挙時点は同じとは限りません。 compilerは後ろの要素式を評価した後で、spreadを列挙する場合があります。 要素式を左から右へ評価する規則だけでは、iteratorの副作用まで同じ順で発生するとは言えません。 構築に渡す値の評価と、値を取り出す列挙を別の操作として扱います(collection expression argumentsの評価と列挙)。
extension indexerはreceiverの機能を呼び出す構文を増やす
C# 14のextension blockに、instance indexerを宣言できるようになりました。 receiverの値を使うため、extension blockには名前付きのreceiver parameterが必要です。 IEnumerable<int>にindexerを加える場合は、取得処理をElementAtへ委譲できます(extension indexer)。
public static class SequenceIndex
{
    extension(IEnumerable<int> values)
    {
        public int this[int index] => values.ElementAt(index);
    }
}
追加したindexerは、通常のmemberと同じ呼び出し構文を持ちます。
IEnumerable<int> values = new[] { 10, 20, 30 };
Console.WriteLine(values[1]); // => 20
indexerの実装はElementAtなので、元のsequenceを配列へ変換したり、結果を自動でcacheしたりしません。 indexerという構文を追加しても、呼び出される処理の内容はextension側に書いた実装のままです(extension memberの解決とreceiver)。
indexerの追加は、receiverの型を作り替える操作ではない
extension blockはreceiverを引数として受け取り、追加のmemberを呼べるsource上の入口を定義します。 既存のIEnumerable<int>というinterfaceへ新しいinstance memberを追加する変更ではありません。 interfaceを実装する既存の型へ、indexerの実装を追加し直す必要はありません。 逆に、extensionを宣言した事実だけで、元の型のmetadataに同じindexerが現れるという動作でもありません。 呼び出し元のscopeで利用できるextensionと、receiver自身が持つmemberをcompilerが解決します(extension declarationとreceiver)。
IEnumerable<int>をreceiverにするindexerでは、要素を列挙して指定位置へ進む実装も定義できます。 values[1]の見た目がarrayと同じでも、arrayの直接参照へ自動で変わる契約ではありません。 yield returnを使うsequenceでは、indexerを呼ぶたびに、先頭から必要な要素を列挙します。
int steps = 0;
IEnumerable<int> Sequence()
{
    for (int index = 0; index < 4; index++)
    {
        steps++;
        yield return index * 10;
    }
}
IEnumerable<int> sequence = Sequence();
Console.WriteLine(sequence[2]); // => 20
Console.WriteLine(sequence[2]); // => 20
Console.WriteLine(steps);       // => 6
ElementAt(2)は各呼び出しで3要素を要求するため、2回分の列挙でcounterは6になります。 indexerを追加する構文には、列挙した値を保存するcacheは含まれません。
ElementAtの実装は、receiverが持つ別のindexing経路を使える場合もあります。 したがって、IEnumerable<T>というstatic typeだけでは、すべての呼び出しの列挙回数を確定できません。 Sequence()のiteratorはindexerを持たず、要素を得る経路はyield returnによる列挙です。 新構文ではextension indexerの呼び出しを表現できます。 任意のsequenceに対する一定時間のrandom accessを保証する拡張ではありません(Enumerable.ElementAtの動作)。
getterへ書いた処理が例外を送出すれば、indexer経由でも同じ処理の失敗を受けます。 負のindexや範囲外のindexに対する規則も、extension indexerを宣言しただけでは別の規則に変わりません。 たとえば範囲外を既定値として扱うAPIへ変えるなら、getterの実装を変更する必要があります。 呼び出す構文を増やす変更と、失敗時の返り値や計算量を変える変更は、実装上の変更箇所が異なります。 元の型へ追加できない操作を、元の型のinstance操作に似た構文で公開できることが、extension indexerの範囲です。
入れ子のloopから名前で移動先を選ぶ
breakとcontinueに、外側のloopなどに付けたlabelを指定できるようになりました。 内側のloopで条件を満たした時点で、外側のloopの次の反復へ進む場合はcontinue outer;と書けます。 従来のようにflagを保存し、loopを抜けた後でflagを再検査する必要がなくなります(labeled jump statements)。
int visits = 0;
outer:
for (int row = 0; row < 2; row++)
{
    for (int column = 0; column < 3; column++)
    {
        visits++;
        if (column == 1)
            continue outer;
    }
}
Console.WriteLine($"visits={visits}"); // => visits=4
各行でcolumnが0と1のときだけ訪問し、1に達すると外側のforの更新処理へ進みます。 labelなしのcontinueなら内側のloopを続けるため、2行ともcolumnが2まで進み、訪問回数は6になります。
labelへのgotoと、label付きloopへのcontinueは移動先が異なる
continue outerは、labelが付いたloopの継続処理へ進みます。 outer:という行へ戻って、forの初期化をもう一度実行する操作ではありません。 continue outerではrow++を実行し、外側の継続条件を検査してから次の行へ進みます。 goto outerへ置き換えると、labelが付いたstatementの入口へ移動するため、同じrowの更新規則を表すことにはなりません。 移動先の名前を指定する点は似ていても、loopを継続する構造を保持しているかが異なります(labeled continue)。
break outerなら、labelを付けたloop全体の後ろへ進みます。 内側のswitchから外側のloopを終了する場合も、通常のbreakがswitchだけを終了する動作と区別できます。 continueの対象はloop、breakの対象はloopまたはswitchであり、任意のstatement名を同じように指定できるわけではありません。 対象はjumpを含む外側の構造である必要があるため、関係のない後続statementへ移動するgotoの代替構文ではありません(labeled break)。
label付きのjumpでも、抜ける範囲にあるfinallyは実行されます。 外側の各反復でtryへ入り、内側の2個目の要素でcontinue outerを実行すると、各行の終了時にfinallyを実行します。 各行の途中から次の行へ進むたびに、tryを抜ける終了処理が実行されています。 labelで外側のloopを選ぶことによって、途中の終了処理を飛び越えて消してしまう機能ではありません(jumpとtryの終了処理)。
複数のloopを抜けるために保存していたflagは、以前の反復の状態を後の条件が読むための値です。 break outerを使う構成では、終了条件を満たした位置から、対象のloopを直接終了できます。 ただし、flagを後段の処理でも結果として使っていた場合には、jumpへ置き換えるだけで同じ返り値や後処理を保存できるとは限りません。 control flowだけを表していたflagと、検索結果などの値を運んでいたflagでは、置き換える対象が異なります。 visitsは要素の訪問回数を数える値で、loopの継続先はouterのlabelが指定します。
pointerの保持とmemoryへのアクセスを分けるpreview
memory safetyのpreviewでは、pointer typeの宣言や&によるaddressの取得だけなら、unsafe contextを必要としなくなります。 fixed、pointerへのstackalloc、unmanaged typeのsizeofも対象です。 一方、*p、p[i]、p->member、function pointerの呼び出しは、指しているmemoryへアクセスするためunsafe contextが必要です(pointerの規則)。
新しいunsafe(expression)は、式1つにunsafe contextを設けます。 field initializerのようにblockを置けない位置でも使えます。 新構文とpointerの規則にはLangVersionのpreviewと、AllowUnsafeBlocksの有効化が必要です(C# 15のmemory safety preview)。
int number = 42;
int* pointer = &number;
System.Console.WriteLine(unsafe(*pointer)); // => 42
RC2のprojectでも、両方の設定が必要です。 pointerの宣言とaddressの取得は通常のcontextに置き、値を読み出す*pointerだけをunsafe(...)で囲んでいます。
さらにupdated-memory-safety-rulesを有効にすると、unsafeを付けたmemberの呼び出し側にもunsafe contextを要求します。 assemblyには適用した規則を示すMemorySafetyRulesAttributeが記録されます。 safe contextual keywordは、extern memberや特殊なlayoutのfieldに安全性の契約を表します(memory safetyの規則)。
pointerを保存できる範囲と、pointerを使って読む範囲
従来の規則は、pointer typeの宣言と、指しているmemoryの読み出しの両方にunsafe contextを要求していました。 C# 15のpreviewでは、pointerの存在と、pointer経由のmemory accessを分けています。 int* pointer = &numberはaddressを保持するだけなので通常のcontextへ置けますが、*pointerは参照先を読む操作なのでunsafeが必要です。 同じpointer変数を扱っていても、値を保持する操作とdereferenceする操作の境界がsourceへ現れます(updated modelのrelaxed operations)。
fixedを通常のcontextで使える変更も、pinした領域への任意の読み書きをsafeにする変更ではありません。 managedな配列をpinし、先頭addressを保存する処理は通常のcontextへ置けます。 pinした後のp[i]はpointer経由のelement accessなので、引き続きunsafe contextが必要です。 pinningはGCによる移動を止める条件であり、indexが範囲内であることまでcompilerがpointerから復元する保証ではありません。 操作の許可を細かくした結果、fixedのscope全体へ一律にunsafeを広げる必要が減ります。
unsafe(...)を省いたpointerのdereferenceには、RC2のcompilerもCS9360を出します。
Console.WriteLine(*pointer); // CS9360
pointerの宣言とaddressの取得は受け付けられ、dereferenceを含む出力の行だけが拒否されています。 LangVersion=previewを指定していても、memory accessの許可まで省略されるわけではありません。 逆に、AllowUnsafeBlocksはunsafeな構文をcompileするためのproject設定であり、個々の式のcontextを自動的にunsafeへ変える設定ではありません。 projectが構文を受け付ける条件と、式が置かれたcontextの条件を両方満たす必要があります。
stackallocをpointerへ代入する操作と、Span<T>へ代入する操作も、型としての契約は残ります。 pointerへした値には、参照先の長さをindexingで検査する仕組みが付いていません。 previewで宣言のためのunsafeが不要になっても、Span<T>が持つ長さの情報までpointerへ移るわけではありません。 同じstack上の領域を使っていても、アクセスに使う型によって、保持する情報と許可する操作が異なります(pointer typeとstack allocation)。
unsafe(expression)は括弧の中だけへcontextを作る
unsafe(*pointer)は、括弧内のdereferenceへ許可を限定します。 外側のmethod全体や、同じstatementに含まれる別の式へまでcontextを広げません。 field initializerやconstructor initializer、catchのwhen句のように、通常のblockを置けない位置でも式を囲めます。 1個のoperationだけを監査対象として示し、周囲の通常の処理からsource上で区切る構成が可能です(unsafe expressions)。
await unsafe(CreateTask())なら、unsafeなcontextはtaskを作る呼び出しだけです。 awaitはunsafe contextの外にあります。 method全体をunsafeにしてasyncな処理をまとめて包む形とは、contextの範囲が異なります。 ただし、括弧で囲んだ事実が、呼び出すoperationの安全性を検証する証拠になるわけではありません。 source上で許可する範囲を明示する構文と、実際にpointerの寿命や境界が成立する条件を分けて扱います(unsafe expressionとawaitの位置)。
unsafeなmemberの契約を、呼び出し側へ伝える
updated-memory-safety-rulesを有効にした規則では、memberに付けるunsafeと、body内のunsafeが異なる役割を持ちます。 signatureのunsafeは呼び出し側に条件を課し、body内のblockやexpressionは実際のmemory accessを許可します。 signatureへ付けたmodifierだけで、body全体がunsafe contextになる従来の読み方とは異なります。 呼び出し元が守る条件をAPIの宣言へ表し、実装内部で許可するoperationの範囲は別に記述します(requires-unsafe members)。
projectのFeaturesへupdated-memory-safety-rulesを指定すると、呼び出すmemberの契約も適用されます。 public static unsafe int Read(int* pointer)のbodyは、return unsafe(*pointer);としています。 呼び出す側にもunsafeが必要で、省略するとNative.Read(int*)にCS9362を出します。
int number = 42;
int* pointer = &number;
Console.WriteLine(unsafe(Native.Read(pointer))); // => 42
public static class Native
{
    public static unsafe int Read(int* pointer)
    {
        return unsafe(*pointer);
    }
}
呼び出す側がpointerを直接dereferenceしていなくても、memberの宣言にある契約が呼び出し位置へ伝わっています。
APIを通常のcontextから呼べる形へ公開したい場合は、実装側で条件を満たすboundaryを作ります。 たとえばmanagedなbyte配列を受け取る実装です。 nullを検査して配列をpinし、長さ未満のindexだけを読めば、呼び出し元へ未検証のpointerを要求せずに値を計算できます。 内部にunsafeがあっても、signatureをunsafeにせず、内部の検査とscopeで条件を満たす構成です。 反対に、任意の外部pointerを受け取り、有効な長さや寿命を検証できないAPIでは、長さや寿命の保証が呼び出し元へ残ります。 新しい規則は、内部で使う構文と、外部へ残る条件の違いを宣言へ反映します(requires-unsafeの条件を伝播または解消する規則)。
assemblyには、適用したmemory safetyの規則を示すattributeを保存します。 libraryとconsumerが別々にcompileされる場合、consumerは呼び出すmemberの契約をmetadataから判断する必要があります。 source fileにあるunsafeという表記だけでは、別のassemblyをcompileする側へ、modifierに適用する規則が伝わりません。 MemorySafetyRulesAttributeは、規則のversionをassemblyへ記録するための仕組みです。 既存のassemblyすべてへ新しい呼び出し条件を無条件に適用する説明では、異なる規則でcompileされた境界を表せません(updated rulesの有効化)。
safeは、任意のunsafeな実装へ付ければ検証済みになる一般的なmodifierではありません。 externのmemberや、explicitまたはextended layoutのfieldなど、規則が指定する位置で使うcontextual keywordです。 native側の実装や、memory layoutの重なりに関する条件を引き受ける境界が関係します。 通常のpointerのdereferenceへsafeを加えて、unsafe contextを省略する構文ではありません。 pointerを保存する許可、memoryへアクセスする許可、APIの呼び出し契約を、各構文が別々に扱っています(memory safetyのsafeの適用範囲)。
古いruntimeで使えるstatic interface memberの範囲
C# 15では、default interface implementationに未対応のruntimeでも、non-virtualなstatic interface memberを宣言して使えます。 interface自身に属するhelperを置き、IMeasurement.ToMeters(...)のように直接呼ぶ使い方が対象です。 instanceのdefault implementationには、引き続きruntimeの対応が必要です。 static abstract、static virtual、protectedなmemberも対象外です(runtimeの要件)。
non-virtualなstatic memberをinterface名から直接呼ぶ処理では、instanceの実装を探索するdispatchを必要としません。 interfaceに置いたhelperの本体を、特定の型名から呼び出せます。 一方、static abstractを使うgenericな処理では、type argumentに応じた実装を解決するruntimeの機能が関係します。 同じstaticという表記でも、固定したhelperの呼び出しと、型ごとに異なる実装を選ぶ操作を区別する必要があります。 C# 15が許可範囲を広げるのは、前者のnon-virtualなmemberです(static interface memberのruntime条件)。
default interface implementationを使うinstance memberは、既定の本体をinterfaceから利用する動作にruntimeの対応が必要です。 non-virtualなstatic memberを宣言できるようになった事実から、既存のinstanceの既定実装も同じtargetへ持ち込めるとは言えません。 language versionを15へ上げることと、runtimeが実装するdispatchの機能を増やすことは別の変更です。 libraryの公開APIを作る場合、helperをinterfaceの名前にまとめたい要求と、実装型へ契約を課したい要求で、使うmemberの種類が変わります。