Java 27の9つのJEPと、既定動作の変更
compact object headers、G1、hybrid TLSの既定化と、primitive pattern、LazyConstant、structured concurrencyをコードと図で解説します。
JDK 27は2026年9月15日にGAとなりました。 9つのJEPが含まれ、compact object headers、G1、TLS 1.3の鍵交換では既定動作が変わっています。 primitive patternなどの言語機能と一部のAPIはpreview、Vector APIはincubatorとして提供されています(OracleのJDK 27リリースノート)。
object headerを96 bitから64 bitへ
HotSpotのcompact object headersが、64-bit環境で既定になりました。 従来の96-bitのheaderを64 bitにまとめる変更であり、objectごとに保持する管理情報を減らします。 たとえば小さいobjectを大量に持つheapではheaderの割合が大きいため、objectの内容を変更せずに管理領域を縮められます(JEP 534)。
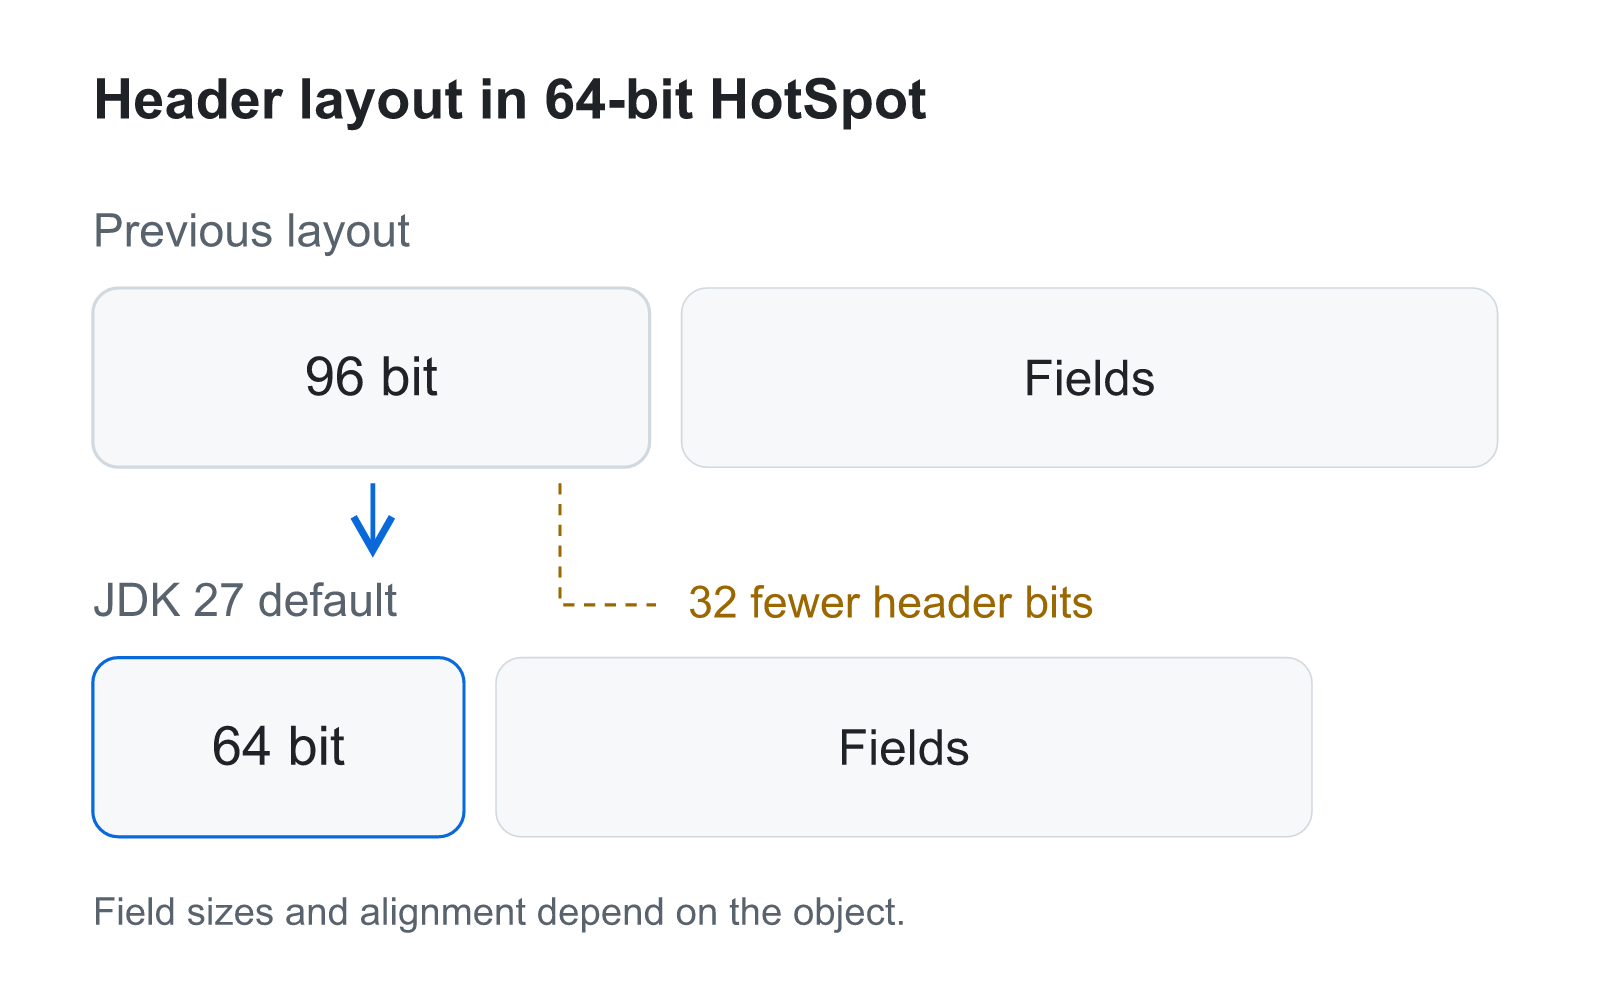
96 bitから64 bitへの変更は、アプリケーション全体のheapが3分の1減るという意味ではありません。 field、array、alignmentによるpaddingもobjectのsizeを決めるためです。 従来のlayoutも残っており、-XX:-UseCompactObjectHeadersで無効にできます(JEP 534の適用範囲と切り替え)。
Temurin 27+35、macOS/aarch64の起動flagでは、compact object headersとG1が有効です。
java -XX:+PrintFlagsFinal -version 2>&1 | rg 'UseCompactObjectHeaders|UseG1GC'
     bool UseCompactObjectHeaders                  = true                           {product lp64_product} {default}
     bool UseG1GC                                  = true                                      {product} {ergonomic}
G1も、JDK 27から環境による既定GCの違いを減らす変更の対象になっています。 以前は小規模な環境などでSerial GCを選択していました。 JDK 27ではG1が全環境の既定です(JEP 523)。
class pointerをheaderの中へ収める仕組み
従来のHotSpotのheaderは、mark wordとclass wordに分かれていました。 mark wordはGCのobject age、lockの状態、identity hash codeなどを保持し、class wordはobjectのclassを識別します。 64-bit環境でcompressed class pointerを使う構成なら、mark wordが64 bit、class wordが32 bitで、合計96 bitです。 compact object headersではclass pointerの圧縮表現をmark wordへ組み込み、合計64 bitへ収めます。 単にclassを識別する情報を削除したわけではありません(JEP 450の従来layoutとcompact layout)。
classの情報は、method呼び出し、型検査、reflection、GCがobjectのsizeを求める処理にも必要です。 class pointerをmark wordと共有するlayoutでは、lockやGCによるheaderの書き換え後もclassを識別できなければなりません。 従来のstack-lockingはheaderをstack上のcopyへのpointerで上書きするため、class情報まで同じ場所へ詰め込む方式とは両立しませんでした。 compact layoutに対応するlock処理は、header全体の上書きへ依存せず、状態を示すbitを使います(JEP 450のlocking)。
GCでobjectを移動するときにも、移動前の位置から新しい位置を示すforwarding情報が必要です。 objectをcopyできなかった場合に、元の位置を自分自身へのpointerとしてheaderへ書く方式では、class情報を失います。 compact layoutではself-forwardedな状態を専用のbitで示し、class情報を保存します。 GCがheaderの表現へ依存するため、headerを4 byte短くする変更は、allocation時のsize計算だけでは完結しません(JEP 450のGC forwarding)。
JDK 27で新しくなったのは、主に有効化の既定値です。 compact object headersはJDK 24でexperimentalとして導入され、JDK 25でproduct featureになっています。 JDK 27では、従来必要だった-XX:+UseCompactObjectHeadersを省略しても使われます。 一方、古いlayoutは削除されておらず、-XX:-UseCompactObjectHeadersを指定した比較も可能です。 headerの表現を前提とする診断やnative連携では、JDKのversionだけでなく、実際に選択したlayoutが入力になります(JEP 534の導入経緯と切り替え)。
object全体のsizeはalignmentによって変わる
headerを12 byteから8 byteへ短くしても、すべてのobjectが4 byte小さくなるとは限りません。 object全体のsizeには、fieldの配置とalignmentに合わせたpaddingが含まれます。 たとえば8 byte境界へ丸めるlayoutでは、headerとfieldの合計が16 byteへ収まるobjectは、headerの短縮前後で同じ16 byteになる場合があります。 逆に合計が境界をまたぐobjectでは、4 byteのheader短縮が8 byteのsize差になる場合があります。 アプリケーションが保持するobjectの型の分布によって、合計の差も変わります。
Instrumentation.getObjectSizeで返るのは、指定したobjectのshallow sizeです。 Java agentからInstrumentationを受け取り、同じ型のinstanceを2種類のlayoutで比較できます。 SizeAgent.javaには、JVMがagentの起動時に呼ぶpremainを置きます。
import java.lang.instrument.Instrumentation;

public class SizeAgent {
    private static Instrumentation instrumentation;

    public static void premain(String arguments, Instrumentation supplied) {
        instrumentation = supplied;
    }

    public static long size(Object value) {
        return instrumentation.getObjectSize(value);
    }
}
Size27.javaは、fieldのない型、整数fieldを1個持つ型、配列を同じ入口へ渡します。
class Size27 {
    static class Empty {}
    static class OneInt { int value; }
    static class OneLong { long value; }

    public static void main(String[] args) {
        System.out.println("empty=" + SizeAgent.size(new Empty()));
        System.out.println("one-int=" + SizeAgent.size(new OneInt()));
        System.out.println("one-long=" + SizeAgent.size(new OneLong()));
        System.out.println("int-array-one=" + SizeAgent.size(new int[1]));
    }
}
agentのmanifestは、premainを持つclassを指定します。 agent.mfの内容は、末尾の改行を含む次の1行です。
Premain-Class: SizeAgent
Temurin 27+35、macOS/aarch64でのcompileと起動は、次のcommandに対応します。
javac SizeAgent.java Size27.java
jar --create --file size-agent.jar --manifest agent.mf SizeAgent.class
java -javaagent:size-agent.jar Size27
# => empty=8
# => one-int=16
# => one-long=16
# => int-array-one=16
java -XX:-UseCompactObjectHeaders -javaagent:size-agent.jar Size27
# => empty=16
# => one-int=16
# => one-long=24
# => int-array-one=24
fieldのないEmptyでは8 byte、OneIntでは0 byte、OneLongでは8 byteの差になります。 header自体の差は4 byteでも、objectの末尾をalignmentへ丸めた後の差は一定になりません。
たとえば、示したlayoutのEmpty、OneInt、OneLongを1000個ずつ保持する場合を考えます。 object自身のsizeを足すと、従来layoutは56000 byte、compact layoutは40000 byteです。 3000個すべてへ一律に4 byteの差を掛けた12000 byteと異なり、差は16000 byteになります。 OneIntは縮まず、残る2種類は8 byteずつ縮むためです。 保持する型がOneIntだけなら、同じ個数でもobject自身のsizeは変わりません。 headerの短縮幅と、型ごとのpaddingを含む差を分ければ、型の個数から占有量を計算できます。 当該合計には、objectを参照する配列やcollection自身の領域を含めていません。 containerまで含むheapの差を求める場合は、containerの要素数とlayoutも加算の入力になります。
配列には、headerに加えて長さの情報と要素の領域があります。 要素が1個のint[]も、compact layoutで16 byte、従来layoutで24 byteになります。 要素数を増やした場合に、要素の値が圧縮される機能ではありません。 参照先のobjectまで加算するdeep sizeではなく、配列object自身の占有量です。 getObjectSizeは実装依存の近似値を返すAPIです。 測定値にはJVMとalignment設定の条件が含まれます(Instrumentation.getObjectSize)。
G1の既定化が変えるのは、明示していなかったGCの選択
以前のHotSpotは、CPU数や利用可能なmemoryからGCを選んでいました。 server向けの環境ではG1を選ぶ一方、単一CPUや物理memoryが1792 MB未満の環境ではSerialを選択する構成がありました。 同じcommand lineでも、配置先の資源制約によって異なるGCになる場合がありました。 JDK 27では、GCを明示しない場合の選択をG1へ統一します(JEP 523の従来の選択条件)。
CPU数とheapを制限した起動でも、GCの選択はG1です。
java -XX:ActiveProcessorCount=1 -Xmx64m -XX:+PrintFlagsFinal -version 2>&1 \
  | rg 'UseG1GC|UseSerialGC'
     bool UseG1GC                                  = true                                      {product} {ergonomic}
     bool UseSerialGC                              = false                                     {product} {default}
CPUを1個として扱い、最大heapを64 MBへ制限した起動でも、G1が選ばれています。 GCの指定を含まないcontainerの起動設定では、既定化の対象が以前のserver環境より広くなります。 すでに-XX:+UseSerialGCなどを指定していた起動は、既定値だけに依存する起動とは異なります。 Serialは削除されず、明示した選択の経路は残ります(JEP 523の適用条件)。
JEP 523では、G1の同期処理、throughput、native memory使用量などの改善を、既定化の理由に挙げています。 ただし、G1とSerialは同じ回収algorithmではありません。 headerの短縮によるheap使用量の減少と、GCの選択によるpauseや回収処理の変化も、異なる変更です。 JDK 27への更新でGC回数に差が出た場合には、layoutとcollectorの同時変更も比較の条件に含まれます。 getObjectSizeは経過時間を返さないため、同じsizeの差からcollectorのpauseやthroughputの差は求められません。
TLS 1.3でhybrid key exchangeを優先する
JDK 27のTLS 1.3実装は、X25519MLKEM768を既定のnamed groupの先頭に置きます。 従来型のX25519と、耐量子暗号のML-KEM-768を組み合わせるhybrid key exchangeです。 javax.net.sslを使い、named groupを独自に限定していないアプリケーションでは、対応する接続先とのhandshakeで利用できます(JEP 527)。
clientが送る最初のkey shareはX25519MLKEM768とx25519です。 接続先がhybrid方式に未対応でも、共通して対応するgroupを使って交渉します。 追加されるSecP256r1MLKEM768とSecP384r1MLKEM1024は既定では有効にならず、jdk.tls.namedGroupsなどで選択します。 鍵交換の変更であり、証明書の署名方式を一括で置き換える変更ではありません(JEP 527のnamed groupと既定の順序)。
hybrid方式でも、handshakeの相手との共通groupを選ぶ
TLS 1.3のclientは、最初のmessageで対応するnamed groupとkey shareを送ります。 JDK 27の既定の優先順位では、最初がX25519MLKEM768、続いてx25519、secp256r1、secp384r1、secp521r1です。 さらにx448と、2048、3072、4096 bitのFFDHE groupが続きます。 hybrid方式だけに限定する変更ではなく、対応する接続先との交渉で優先する方式を追加する変更です(JEP 527の既定のgroup一覧)。
key shareと、対応するgroupの一覧は同じ情報ではありません。 対応するすべてのgroupについて、最初からkey shareを送るわけではなく、既定ではhybridのX25519MLKEM768と従来のx25519を送ります。 handshakeの方式は、接続先との交渉で決まります。 JDK 27へ更新しても、hybrid方式に未対応の接続先との通信には従来方式を使います。 接続先の実装と設定も共通のgroupを決める条件になります。 従来方式を受け入れる相手との接続経路も、既定のgroup集合には残っています。
hybrid方式は、ECDHEとML-KEMの両方を組み合わせて鍵を導出する方式です。 従来型の方式だけ、またはML-KEMだけへ置き換える方式とは構成が異なります。 JEP 527は、ML-KEMだけを使うnon-hybrid方式を今回の対象に含めていません。 同じML-KEMという名前が現れても、TLSのnamed groupとして何を交渉するかが実際の機能です。 証明書が示すidentityや、署名algorithmの選択を一括して変更する指定ではありません(JEP 527の対象外となる方式)。
アプリケーションが独自にgroupを選ぶ場合には、SSLParameters.setNamedGroupsへ名前を渡し、socketへ設定を戻します。 たとえばnew String[] { "X25519MLKEM768", "x25519" }なら、hybrid方式と従来方式の2個を選ぶ指定です。 SecP256r1MLKEM768やSecP384r1MLKEM1024は実装に加わりましたが、既定で有効なgroupではないため、名前が存在することだけでは交渉候補へ含まれません。 process全体の既定にはjdk.tls.namedGroupsを使います。 接続ごとの設定にはSSLParametersを使います(SSLParameters.setNamedGroups)。
すでにjdk.tls.namedGroupsを固定している配置では、JDK側の新しい既定一覧を使いません。 たとえば従来のgroup名だけを列挙した設定を残せば、更新したJDKでもhybrid方式は候補に増えません。 反対に、hybrid方式だけを選ぶ設定は、従来方式も残す既定設定と同じ互換性の条件ではありません。 JDK 27が変更する既定順序と、アプリケーションが上書きしているgroup集合を合わせた結果が、実際のhandshakeの入力になります。
primitive patternで値を失わない変換を判定する
5回目のpreviewとなるprimitive patternでは、instanceofやswitchのpatternにprimitive typeを使えます。 単にcastできるかではなく、対象の値を正確に表せるかを判定します。 doubleからintへの判定なら、整数として表せる42.0と、小数部分を失う42.5で結果が変わります(JEP 532)。
double exact = 42.0;
double fraction = 42.5;
System.out.println("int=" + (exact instanceof int));       // => int=true
System.out.println("fraction=" + (fraction instanceof int)); // => fraction=false
対象はTemurin 27+35で、compile時と実行時の両方でpreviewを有効にする必要があります。 明示的なcastの(int) 42.5なら小数部分を切り捨てますが、patternの判定は値を失う変換を成功扱いにしません。 判定に成功した値を変数として束縛するinstanceof int valueも使えるため、変換可否の判定と値の取り出しを同じ条件に置けます(JEP 532のexact conversion)。
断片をclassのmainに置き、Release27.javaとして保存すると単一ファイルで実行できます。 実行commandはjava --enable-preview --source 27 Release27.javaです。 class fileへ分ける場合はjavac --enable-preview --release 27 Release27.javaでcompileします。 実行時にもjava --enable-preview Release27でpreviewを有効にします。
小数部分だけでなく、範囲と浮動小数点の値の区別も残す
doubleからintへの変換では、小数部分だけでなく、型の範囲と特殊値の規則も判定に含まれます。 intの最大値を越える2147483648.0も、整数の形をしていてもintで表せないため、patternに一致しません。 同じprimitive patternを、範囲と特殊値へ適用すると条件の差が現れます。
double[] numbers = {42.0, 42.5, -0.0, Double.NaN,
        Double.POSITIVE_INFINITY, 2147483648.0};
for (double number : numbers) {
    System.out.println("exact=" + number + "/" + (number instanceof int));
}
exact=42.0/true
exact=42.5/false
exact=-0.0/false
exact=NaN/false
exact=Infinity/false
exact=2.147483648E9/false
-0.0は整数の0へ変えると負のzeroという性質が失われるため、単なる切り捨ての可否とは違う結果になります(JEP 532のexact conversionと特殊値)。
明示的なcastは、変換先の型へ値を作る操作です。 一方、primitive patternは、元の値を失わずに変換できる条件を満たすかを調べ、成功した場合に値を束縛します。 したがって、(int) valueを先に実行して元の値と比べる処理を、無条件にpatternへ置き換えられるわけではありません。 特に無限大やNaN、符号付きzeroなどでは、通常の整数の範囲検査だけでは変換の意味を表し切れません。 値を拒否する条件をpatternへ含められることが、単に短いcast構文を増やす変更との違いです。
判定に使う式のstatic typeも動作を決めます。 入力の静的な型がdoubleかObjectかによっても、同じ数値の判定結果が異なります。
double primitive = 42.0;
Object boxed = Double.valueOf(42.0);
System.out.println(primitive instanceof int); // => true
System.out.println(boxed instanceof int);     // => false
数値として42でも、Objectから任意のwrapperを取り出して任意のprimitiveへ変換する判定ではありません。 primitiveからのexact conversionと、referenceからwrapperを扱う規則では、許可する変換経路が異なります。 static typeを含めてpatternの適用規則が決まります(JEP 532の型ごとの規則)。
switchへ適用する場合には、caseに一致する条件へexact conversionの条件が入ります。 狭いprimitive typeへ正確に収まる値を先に処理し、残りを広い型のcaseで処理する構成ができます。 入力を狭い型へcastしてからswitchする構成では、caseへ入る前に情報を失いますが、patternでは成功条件をcase側に置けます。 ただし、先のcaseが後のcaseの入力をすべて覆う組み合わせには、従来のpattern switchと同じくdominanceの制約があります。 caseの並びは、入力を受け取る条件の優先順位を表します。
LazyConstantは初回の計算結果を固定する
LazyConstantは、値を必要とする初回のget()で計算し、以後は同じ内容を返すpreview APIです。 Supplierのように呼ぶたびに計算するのではなく、複数threadが同時に初期化しようとしても、計算を担当するthreadは1つに限られます。 3回目のpreviewとしてJDK 27に含まれています(JEP 531、LazyConstantのAPI)。
JDK 27では、初期化状態を調べるisInitializedと代替値を返すorElseが削除されました。 collectionにはSet.ofLazyが加わり、List、Set、Mapの遅延初期化を表現できます(JEP 531の変更点)。
static final LazyConstant<String> CONFIG = LazyConstant.of(() -> {
    System.out.println("initialize");
    return "ready";
});
CONFIG.get()の結果を2回表示すると、出力はinitialize、ready、readyの順になります。 initializeは計算するlambda内にあるため、2回目のget()では表示されません。 値はLazyConstantから強く参照され続け、内容が固定された後に値を追い出すcacheではありません(LazyConstantの初期化と到達可能性)。
計算が例外を送出した場合は失敗状態になり、後続のget()で計算を再試行しません。 nullを返す計算や、自分自身のget()を呼ぶ再帰も失敗として扱います。 一度だけ初期化するAPIなので、一時的な通信失敗から自動で再試行する用途には別の制御が必要になります(LazyConstantのException handling)。
失敗した計算も、初期化の結果として固定する
initializerが例外を送出すると、最初のget()には元の例外をcauseに持つNoSuchElementExceptionを返します。 後続のget()もNoSuchElementExceptionになりますが、同じinitializerを再実行せず、causeも引き継ぎません(LazyConstantの失敗時の契約)。
var attempts = new AtomicInteger();
var failed = LazyConstant.<String>of(() -> {
    attempts.incrementAndGet();
    throw new IllegalArgumentException("unavailable");
});
for (int index = 0; index < 2; index++) {
    try {
        failed.get();
    } catch (Exception error) {
        System.out.println(error.getClass().getSimpleName()
                + "/" + (error.getCause() != null));
    }
}
System.out.println(attempts.get());
NoSuchElementException/true
NoSuchElementException/false
1
initializerがnullを返した場合も、値のない成功として保存するAPIではありません。 NullPointerExceptionが失敗の原因になり、値を取得する呼び出しは失敗します。 初期化の途中で同じLazyConstantのget()を再帰的に呼ぶ場合には、IllegalStateExceptionが原因になります。 たとえば設定Aの計算が設定Bを要求し、設定Bの計算が再びAを要求する依存関係では、単に初期化が遅延されるという説明だけでは不十分です。 値を固定する順序に循環があれば、取得できる値を完成できない経路になります。
値の取得に成功した後は、同じLazyConstantから同じ値を取得します。 複数のvirtual threadが同じget()を呼んでも、共有する初期化の結果を受け取ります。
var initialized = new AtomicInteger();
var lazy = LazyConstant.of(() -> {
    initialized.incrementAndGet();
    return new Object();
});
try (var executor = Executors.newVirtualThreadPerTaskExecutor()) {
    var first = executor.submit(lazy::get);
    var second = executor.submit(lazy::get);
    System.out.println(first.get() == second.get()); // => true
}
System.out.println(initialized.get()); // => 1
initializerの中で毎回new Object()を使っていても、呼び出し元ごとに新しいobjectを作る動作にはなりません。 値の共有と、計算を1回に限る制御をAPIが担当します。 一方、戻したobject自体がmutableなら、内容の変更はobject側の契約に従います。
初期化中のget()は、別のthreadが担当する計算を待つ場合があります。 待つ側の呼び出しにtimeoutやcancelを渡すAPIではありません。 initializerの中に外部I/Oを置けば、I/Oの完了まで値の取得も完了しません。 遅延初期化は、外部I/Oのtimeoutまで追加する仕組みではありません(LazyConstantのthread safety)。
static finalなfieldへLazyConstantを置く構成には、JVMが固定された値の取得を最適化しやすい利点があります。 ただし、get()が初回にも必ず単なるfieldのloadになるとは限りません。 初回にはinitializerを呼ぶ経路があり、失敗状態も表します。 通常のstatic final fieldは、classの初期化時に値を計算します。 LazyConstantは、最初のget()までinitializerを実行しません(JEP 531の最適化と遅延初期化)。
collection全体を作る時点と、各要素を作る時点
List.ofLazy(size, computingFunction)では、listの長さを先に決め、各indexの要素は利用時に計算できます。 要素を計算するfunctionへcounterの加算を置くと、容器の構築と要素の生成を区別できます。
var calls = new AtomicInteger();
var values = List.ofLazy(3, index -> {
    calls.incrementAndGet();
    return "item-" + index;
});
System.out.println("created=" + calls.get() + "/" + values.size()); // => created=0/3
System.out.println(values.get(1)); // => item-1
System.out.println(values.get(1)); // => item-1
System.out.println(calls.get());  // => 1
System.out.println(values);       // => [item-0, item-1, item-2]
System.out.println(calls.get());  // => 3
要素の個数は3と分かっていますが、要素を作るfunctionはまだ呼ばれていません。 listという容器の形を確定させることと、内容の生成を完了させることを分けられます(List.ofLazy)。
get(1)を繰り返しても、index 1の要素を再計算しません。 同じindexの要素を使うたびに再計算するviewではありません。 list全体の表示には、まだ初期化していなかったindex 0と2の値も必要になります。 表示のために全要素へアクセスすると、まだ計算していなかったindexも計算されます。 初期化を遅らせたcollectionでも、内容を列挙する操作を早い段階で呼べば、必要な計算は列挙時へ移ります。
遅延listはunmodifiableなlistです。 後から要素を追加し、削除し、別の要素へ置き換える用途にはなりません。 遅延なのは要素を計算する時点であり、collectionの構造を自由に変更できるという意味ではありません。 戻す要素はnullを許さず、同時に複数threadが利用する場合も、要素の遅延初期化をAPIが管理します。 値を固定した後に外側の入力が変わっても、要素を自動で作り直す仕組みではありません(Listのunmodifiableなfactoryの契約)。
Map.ofLazyではkeyの集合と、keyから値を計算するfunctionを渡します。 Set.ofLazyでは候補の集合とpredicateを渡すため、値を作るlistと同じ引数構成ではありません。 JDK 27が加えるSet.ofLazyを、任意のsupplierの配列からsetを作るAPIとして説明すると、実際の宣言と一致しません。 setに含める要素を遅延して決める操作と、indexからlistの要素を作る操作では、factoryの契約が異なります(JEP 531のcollection factory)。
以前のpreviewで使えたisInitializedやorElseを削除した変更は、既存のpreview利用コードのsource互換性へ直接影響します。 初期化済みの状態を見て処理を分岐するcodeは、単にJDKを差し替えるだけではcompileできなくなります。 値が必要ならget()で初期化の結果を取得する形へ、取得を避けたいなら値を要求しない処理へ、呼び出し側の契約を分ける変更になります。 isInitializedの返り値で処理を分岐していたsourceには、初期化状態を公開しないAPIへ合わせた制御の変更が必要です(JEP 531のJDK 26からの差分)。
structured concurrencyではjoin()の例外型まで表現する
7回目のpreviewとなるstructured concurrencyでは、scope内で起動したsubtaskの終了をscopeの生存期間内に収めます。 forkで起動し、joinで結果を受け取り、closeで全threadの終了を待つ流れです。 scopeを閉じた後までsubtaskを残す使い方にはなりません(StructuredTaskScopeのAPI)。
try (var scope = StructuredTaskScope.open(
        StructuredTaskScope.Joiner.<String>allSuccessfulOrThrow())) {
    scope.fork(() -> "profile");
    scope.fork(() -> "orders");
    System.out.println(scope.join());
}
join()の返り値は、起動した順序に対応する[profile, orders]です。 allSuccessfulOrThrowは全subtaskの成功結果を集め、失敗したsubtaskがあればscopeをcancelしてExecutionExceptionを送出します。 cancelで他のthreadにinterruptを要求しても、closeはthreadが実際に終わるまで待ちます。 interruptに応答しない処理があれば、scopeの終了も遅れます。 cancelは強制終了ではありません(StructuredTaskScopeの終了)。
JDK 27ではStructuredTaskScopeとJoinerに、join()から送出する例外の型を示す3個目のtype parameter、R_Xが加わりました。 例外を別の型へ変換するfactory overloadも追加されています。 以前のJoiner.awaitAll()は削除されました。 timeoutの処理もonTimeout()からtimeout()へ変わり、結果を返すか例外を送出します(JEP 533)。
subtaskの値とscope全体の結果は同じ型とは限らない
StructuredTaskScope<T, R, R_X>のTは、起動したsubtaskが成功した場合の値の型です。 Rはscope全体のjoin()が返す型なので、subtaskがStringを返しても、scopeの結果はList<String>にできます。 R_Xはjoin()が失敗を知らせる際の例外型であり、成功結果の型へerrorを混在させるためのparameterではありません。 成功値の集約方法と失敗の伝え方をJoinerで決めると、scopeの型へ反映されます(StructuredTaskScope.Joinerのtype parameter)。
allSuccessfulOrThrow()なら、すべての成功値をlistへ集めます。 awaitAllSuccessfulOrThrow()は全成功を待ちますが、join()で取得するnon-nullな結果は作りません。 anySuccessfulOrThrow()では、成功したsubtaskの値を取得できればよく、すべての成功値を集める条件とは異なります。 3つのfactoryは、結果の容器に加えて、scopeの処理結果を確定する条件を変えます。 1個の失敗で全体を失敗にするpolicyと、少なくとも1個の成功で処理を進めるpolicyを選べます。
例外を変換するoverloadは、失敗を呼び出し元のAPIが公開する例外型へ合わせる用途を持ちます。 Joiner.<String, IOException>allSuccessfulOrThrowへ、causeからIOExceptionを作るfunctionを渡せます。 subtaskのIllegalStateExceptionは、元の例外をcauseに持つIOExceptionへ変わります。 呼び出し元がcatchする型は、subtaskが送出した例外の型と同じである必要はありません。 新しいR_Xによって、factoryで選んだ変換後の型を、join()の宣言へ持ち上げられます(JEP 533の例外型を指定するfactory)。
cancelが発生した後も、scopeを閉じるまで所有関係が残る
兄弟subtaskの一方がCountDownLatch.await()で停止している場合、もう一方の失敗によるcancelが、停止中のthreadへinterruptを要求します。 開始の順序もlatchで揃えると、待機中の兄弟が必ず存在する状態で失敗させられます。
var entered = new CountDownLatch(1);
var interrupted = new AtomicBoolean();
try (var scope = StructuredTaskScope.open(
        StructuredTaskScope.Joiner.<String, IOException>allSuccessfulOrThrow(
                cause -> new IOException("lookup", cause)))) {
    scope.fork(() -> {
        entered.countDown();
        try {
            new CountDownLatch(1).await();
            return "unexpected";
        } catch (InterruptedException error) {
            interrupted.set(true);
            throw error;
        }
    });
    scope.fork(() -> {
        entered.await();
        throw new IllegalStateException("failed");
    });
    scope.join();
} catch (IOException error) {
    System.out.println(error.getClass().getSimpleName()
            + "/" + error.getCause().getClass().getSimpleName());
}
System.out.println(interrupted.get());
IOException/IllegalStateException
true
join()の失敗時点と、全subtaskの終了時点は、常に同じとは限りません。 cancelで結果を確定しても、interruptを受けたsubtaskの後処理は完了していない場合があります。 close()はsubtaskの終了を待ち、scopeの外へthreadを残さないようにします。 したがって、失敗直後に呼び出し元へ戻す構成とは、resourceの生存期間が異なります。 tryの外側で例外をcatchする時点には、scopeのclose()が完了し、起動した兄弟も終了しています(StructuredTaskScopeのclosing)。
scopeにはowner threadがあります。 fork、join、closeを任意の別threadから操作する、共有のtask managerとしてのAPIではありません。 親の処理がsubtaskを起動し、結果を待ち、同じ構造の範囲内で終了する関係をAPIが追跡します。 subtaskへ処理を渡すことと、scopeの管理権限をsubtaskへ移すことは異なります。 親が持つscopeの操作を無秩序に共有すると、APIが要求する所有関係に違反します(StructuredTaskScopeのownerと構造)。
timeoutはConfiguration.withTimeout(Duration)でscopeへ設定できます。 期限に到達するとscopeをcancelし、Joiner.timeout()がtimeout時の結果または例外を決めます。 期限を過ぎた処理へinterruptを要求しても、threadを強制的に破棄する機能ではないため、close()が待つ条件は残ります。 外部libraryがinterruptへ応答しない場合に、scopeのtimeoutだけを短くしても、scopeを閉じる総時間まで同じ長さへ制限されるとは限りません。 期限の到達を検出する条件と、起動した処理が終了する条件を、APIは別の段階で扱います(Joiner.timeout)。
Vector API、PEM、JFRの変更
Vector APIは12回目のincubatorです。 CPUのSIMD命令に対応するvector演算をJavaから表現するAPIであり、利用時には--add-modules jdk.incubator.vectorを指定します。 primitive patternやLazyConstantのpreviewを有効にする指定とは別に、moduleの追加が必要です(JEP 537)。 JDK 27ではVector API自体の変更はありません。 ARMとRISC-Vのvector mathに使う同梱SLEEFは、3.6.1から3.9.0へ更新されています(JEP 537の更新対象)。
Vector APIではlane数と配列の末尾を分けて扱う
Vector APIのvectorは、同じ演算を適用する複数のlaneをまとめた値です。 FloatVectorなら各laneがfloatを保持し、mul(2)は各laneへ2倍の演算を適用します。 VectorSpeciesは、要素の型とvectorのshapeに対応する組み合わせを表します。 SPECIES_PREFERREDを使うコードでは、実行環境に適したlane数を取得します。 source内へ特定のlane数を固定せずにloopを組めます(VectorSpeciesのshapeとlane)。
macOS/aarch64のTemurin 27+35では、preferred speciesのlane数は4です。 1から7までの7要素なら、先頭の4要素をvectorで処理し、残り3要素をscalarのloopで処理します。 vectorの反復上限にはspecies.loopBound(source.length)を使います。 配列の長さをvector loopの上限に使うと、最後の反復で配列の外まで読み込む場合があるためです。
var species = FloatVector.SPECIES_PREFERRED;
float[] source = {1, 2, 3, 4, 5, 6, 7};
float[] result = new float[source.length];
int i = 0;
for (; i < species.loopBound(source.length); i += species.length()) {
    FloatVector.fromArray(species, source, i)
            .mul(2).intoArray(result, i);
}
for (; i < source.length; i++) {
    result[i] = source[i] * 2;
}
System.out.println(species.length()); // => 4
System.out.println(Arrays.toString(result)); // => [2.0, 4.0, 6.0, 8.0, 10.0, 12.0, 14.0]
末尾を処理する別の方法には、indexInRangeで有効なlaneを示すmaskを作る方法があります。 maskは配列の範囲内にあるlaneだけを選ぶため、端数のある入力でも同じvectorのshapeを使う構成にできます。 ただし、すべての演算をmaskedな形へ変えれば必ず速くなるという関係ではありません。 targetの命令とJITが使える処理によって、scalarで末尾を扱う構成との性能差は変わります。 maskを使う構成では、indexInRangeが選んだlaneだけをloadとstoreの対象へ指定します(VectorSpecies.indexInRange)。
JDK 27のVector APIは、12回目のincubatorでもAPI自体を変更していません。 SLEEFの更新は、vector mathの実装が利用するlibraryの更新です。 Javaのsourceに新しいmethodが増えたことと、同じmethodがtargetで使う実装を更新したことは、別の差分になります。 incubator moduleの解決には、previewの有効化とは別の指定が必要です。 classのmainへ断片を置いたVector27.javaは、incubator moduleを指定して実行できます。
java --add-modules jdk.incubator.vector --source 27 Vector27.java
実行時のincubatorのwarningも、preview APIの有効化に関する診断とは異なるものです。
PEM encodingは3回目のpreviewとして、鍵や証明書などをPEM形式でencode、decodeするAPIを提供します。 -----BEGIN ...-----で囲まれたBase64表現を、Javaの暗号APIが扱うobjectと相互変換するための機能です。 文字列の区切りを手作業で切り出す処理と、暗号objectの変換を別々に実装する必要を減らします(JEP 538)。
JDK 27ではPEMがrecordから通常のclassへ変わり、Base64のbyte列を受け取るconstructorが加わりました。 DEREncodableはBinaryEncodableへ改名されています。 PEMDecoder.withFactoryもwithFactoriesOfへ変わり、providerから複数のfactoryを取得する動作を名前に表しています(JEP 538のAPI変更)。
PEMの文字列と暗号objectの境界をAPIで扱う
PEMには、PUBLIC KEYなどのtypeを表すlabelと、Base64で表現した内容があります。 区切り行を除いてBase64をdecodeしただけでは、JavaのPublicKeyやX509Certificateを作る処理は完了しません。 typeとbinary encodingに対応するfactoryを使い、暗号objectへ変換する段階が残ります。 PEMDecoderは、PEMのtypeに応じたobjectを返す処理まで含みます(PEMDecoderのtypeと返り値の対応)。
2048-bitのRSA key pairから公開鍵をencodeし、PublicKey.classを指定してdecodeできます。 鍵の値は生成するたびに変わりますが、encode前とdecode後のbinary encodingは一致します。
var generator = KeyPairGenerator.getInstance("RSA");
generator.initialize(2048);
var original = generator.generateKeyPair().getPublic();
var text = PEMEncoder.of().encodeToString(original);
var decoded = PEMDecoder.of().decode(text, PublicKey.class);
System.out.println(text.startsWith("-----BEGIN PUBLIC KEY-----")); // => true
System.out.println(Arrays.equals(
        original.getEncoded(), decoded.getEncoded())); // => true
戻り値のclassを指定するoverloadは、castを省略するためだけのものではありません。 たとえばkey pairの内容から、PrivateKey.classを指定してprivate keyだけを取り出せます。 内容と指定したclassが合わない場合にはClassCastExceptionになります。 名前のないBase64の塊を任意の暗号objectへ変換できるという契約ではなく、PEMの内容が要求した表現に対応する必要があります(PEMDecoder.decodeのclass指定)。
対応する暗号objectがないtypeでは、decoderはPEMを返します。 PEM.classを明示して、type、Base64の内容、headerより前のleading dataへアクセスする使い方もできます。 PEMを直接構築するconstructorは、指定したtypeと内容が意味的に一致することまで検査しません。 たとえばlabelをPUBLIC KEYにした事実だけで、内容が有効な公開鍵だと検証した結果にはなりません。 PEMの構造を保持するobjectと、鍵を解釈して生成したobjectには、成立している条件の違いがあります(PEMのconstructorの検証範囲)。
withFactoriesOf(provider)は、指定したproviderが提供するfactoryを使うdecoderを作ります。 PEMの構文を読み取る機能と、暗号algorithmごとに鍵や証明書を生成するproviderの選択が、API上で接続されます。 暗号化したprivate keyについては、decodeしてEncryptedPrivateKeyInfoを得る経路と、復号を設定してprivate keyへ進む経路があります。 Base64が読めたことと、暗号化した鍵を復号できたことは同じ成功条件ではありません。 JDK 27ではCryptoExceptionも加わり、暗号処理に関わる失敗の表し方が整理されています(JEP 538のdecoderと例外)。
JFRにはin-process data redactionが入り、記録がprocessの外へ出る前に機密情報を除く仕組みが加わりました。 対象にはcommand line引数、起動時の環境変数、system propertyなどが含まれます。 filterに一致した情報を、process外へ保存する前に除きます。 filterは-XX:FlightRecorderOptionsの追加optionで指定できます(JEP 536)。
JFRへ書き出す前に値を置き換える
従来のJFR記録には、環境や起動引数を記録するeventが含まれます。 jdk.InitialEnvironmentVariable、jdk.InitialSystemProperty、jdk.JVMInformationなどです。 起動時の環境や引数は障害調査の入力になりますが、起動設定に含まれたpasswordやtokenも同じ経路で記録され得ました。 JDK 27では、対象の引数や値をprocess内で[REDACTED]へ置き換えてから記録します。 保存したfileを後から編集する処理とは異なり、未加工の値を記録の一時fileやstreamへ出す前の段階で扱います(JEP 536の対象eventと処理の位置)。
redact-keyは、環境変数とsystem propertyのkeyへ照合するfilterです。 keyが一致した場合には、key自体ではなく対応する値を置き換えます。 redact-argumentはcommand line引数へ照合し、一致した引数を置き換えます。 照合は大文字と小文字を区別せず、*と?を使うglob patternです。 複数のfilterはsemicolonで区切るため、shellでcommandを記述する際には、option全体を1個の引数として渡す形になります(JEP 536のfilter構文)。
propertyをreport.secret=sample-valueとreport.label=publicにします。 redact-key=*secret*を適用すると、前者の値だけを置き換えます。
java -XX:StartFlightRecording=filename=redaction-code-review.jfr \
  '-XX:FlightRecorderOptions=redact-key=*secret*' \
  -Dreport.secret=sample-value -Dreport.label=public -version
jfr print --json --events jdk.InitialSystemProperty redaction-code-review.jfr \
  | jaq -c '.recording.events[].values | select(.key == "report.secret" or .key == "report.label") | {key, value}'
JSONから対象のpropertyを取り出すと、置換した値と保持した値が並びます。
{"key":"report.secret","value":"[REDACTED]"}
{"key":"report.label","value":"public"}
jdk.JVMInformationが保持するJVMの引数でも、-Dreport.secret=[REDACTED]となっています。 propertyのeventだけを加工し、同じ値が残るcommand lineを無加工で保存する動作ではありません。
command lineで--token sample-tokenのように名前と値を分けている場合、--tokenだけを隠しても値が残ります。 redact-argument=--token *は、名前と次の1個の引数をまとめて照合するfilterです。 javaArgumentsでは、名前と値の両方が[REDACTED]へ変わります。 filterにsecretの値を書かず、引数の形式から置き換える対象を選べます。 値が1個ではない形式なら、必要な引数の個数に合わせてpatternを指定します(JEP 536の複数引数の照合)。
既定のkey filterには、password、secret、token、credentialなどに対応するpatternがあります。 独自のfilterを指定するとき、通常の指定は既定のfilter一覧を置き換えます。 既定値へ追加する場合には、先頭の+を使います。 独自filterだけを指定した起動では、既定のfilterを置き換えた旨のwarningを出します。 独自の1個のkeyを隠す設定でも、置換の構文では従来のpasswordやtokenを隠すpatternが外れます。 追加と置換を区別するのは、既定の保護を維持する条件です(JEP 536の既定filter)。
filterをfileから読む場合には、redact-key=@keys.txtのように@を付けます。 fileはJVMの起動時に読み込み、1行に1個のfilterを記述します。 読み込めないfileを指定した場合は、file名を含むerrorを表示してJVMが終了します。 長いfilter一覧を複数の起動commandへ複製する代わりに、同じfileを配置して利用する経路です。 -Xlog:jfr+redact=debugは、filterに一致した引数やkeyをdebug logへ出力します(JEP 536のfilter file)。
redactionが対象にするのは、実装が指定するeventのfieldとfilterの条件です。 アプリケーションが独自eventのmessageへ書いた任意の内容を、すべて自動判定して除く機能ではありません。 既定で置き換えたfieldが増えるため、従来のJFR記録を解析する処理には、実値の代わりに[REDACTED]が入る差も生じます。 記録の構造が壊れた結果ではなく、対象の値を出さない処理の結果としてplaceholderが入ります。 機密値を除く条件を増やしつつ、調査に必要な非機密の起動設定を残すことが、event全体を無効にする構成との動作の差です。
filterの構文をglobにした理由には、JVM内部で照合する処理の制約もあります。 JEP 536では、C++の正規表現libraryが例外を送出し得る一方、HotSpot内部ではC++の例外を使わない規約を挙げています。 Javaの正規表現APIを呼ぶ案では、起動時間への影響や、JVMからJavaへ呼び戻せない位置への拡張が問題になります。 JEP 536では、引数やkeyの名前を選ぶpatternを、globとしてprocess内で扱う方式を採用しています。 filterの構文には、正規表現の量指定子やgroupを含みません(JEP 536で比較された照合方式)。