Python 3.15のlazy import、frozendict、起動処理の変更
lazy importの実行順、frozendictの浅い不変性、sentinel、UTF-8の既定化と、free-threaded build向けStable ABIを解説します。
Python 3.15.0は2026年10月9日に公開されました。 10月21日には最初のmaintenance releaseである3.15.1も公開されています。 3.15.1は、同梱するpipの証明書bundleを更新するため、通常より早い日程で公開された版です(3.15.0の公開記録、3.15.1の公開記録)。
lazy importはmoduleの実行を初回利用まで遅らせる
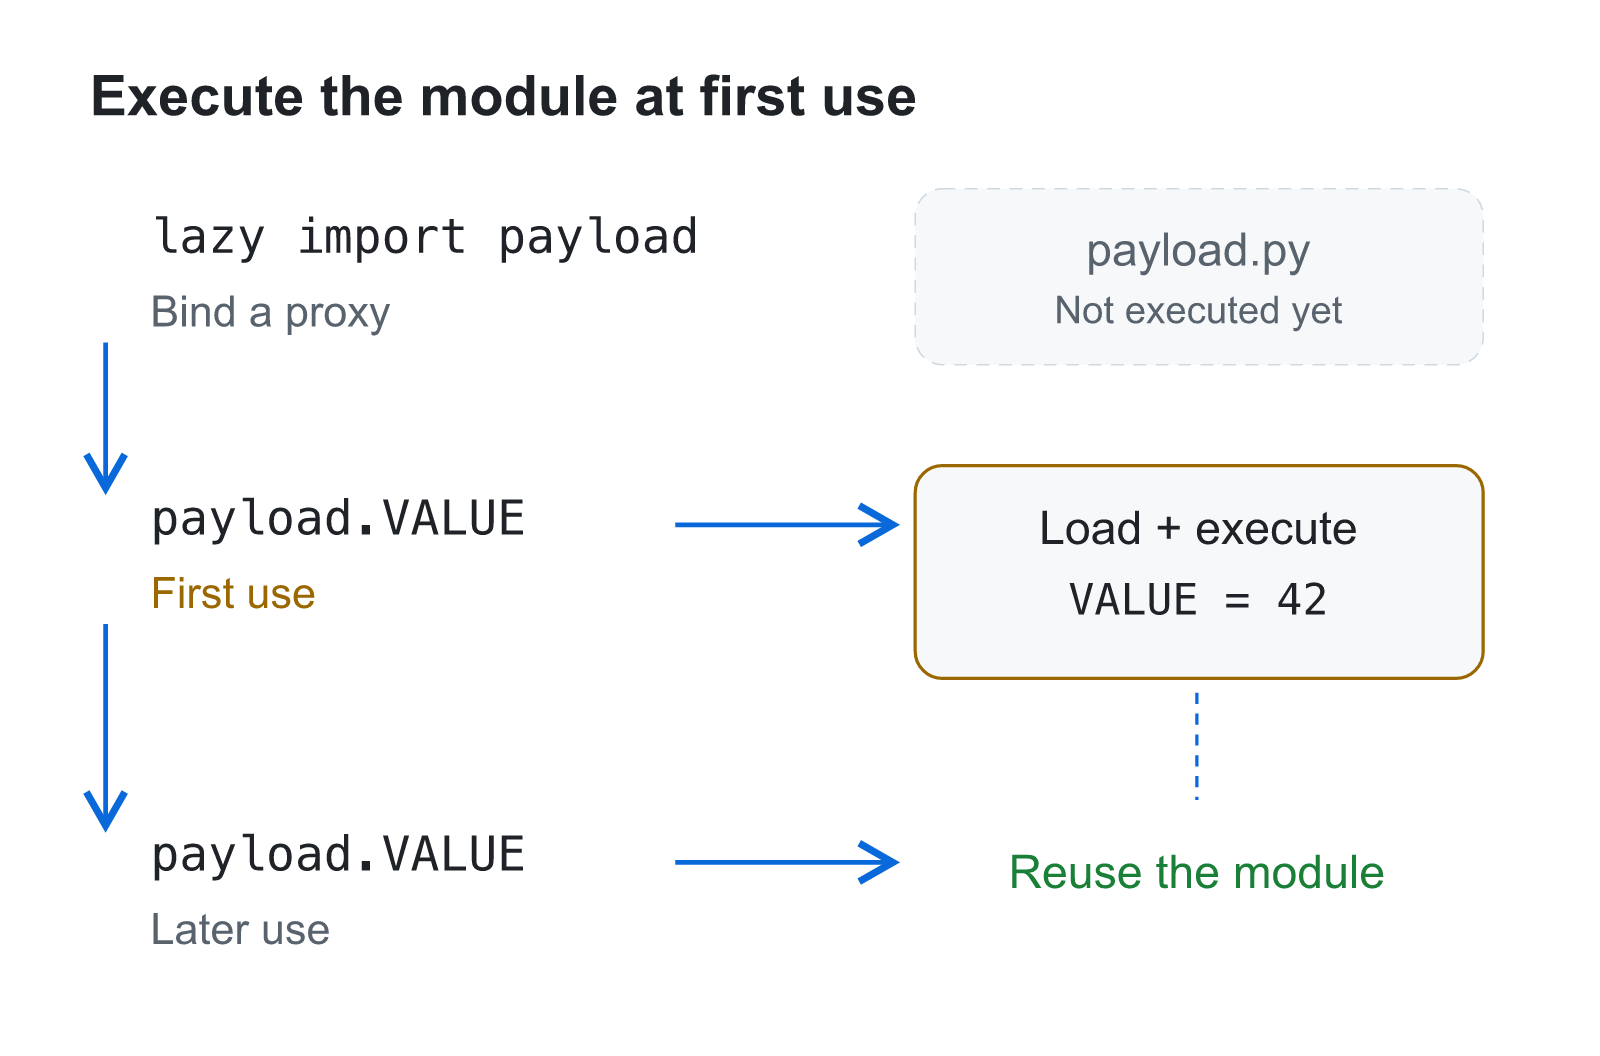
通常のimportは、moduleを読み込む際にtop-levelのコードも実行します。 lazy importでは名前をproxyに結び付け、名前が最初に使われた時点まで実際の読み込みを遅らせます。 起動時に宣言したmoduleのうち、使わない実行経路のmoduleを読み込まずに済む仕組みです(PEP 810)。
読み込む側のpayload.pyに、読み込み時の表示と値の定義を置きます。
print("payload loaded")
VALUE: int = 42
呼び出す側のlazy_demo.pyでは、宣言後にmessageを表示してからpayload.VALUEを読みます。
lazy import payload

print("before first use")
print(payload.VALUE)
print(payload.VALUE)
CPython 3.15.0、macOS/aarch64でのstdoutは、名前の初回利用と読み込みの順序を表します。
before first use
payload loaded
42
42
lazy import payloadの行ではpayload.pyが実行されず、最初のpayload.VALUEでpayload loadedが表示されます。 2回目の参照では読み込み済みのmoduleを使うため、top-levelの表示は繰り返しません。 読み込み時に行っていたplugin登録などの副作用も初回利用へ移るので、moduleを宣言しただけで登録が済む前提のコードは動作が変わります(PEP 810の実行時の意味)。
読み込みが失敗する時点も変わります。 存在しないmoduleのlazy importは、初回利用時に例外を発生させます。 tracebackには利用箇所と元のimport箇所が含まれます。 全体へ適用する-X lazy_imports=allと、明示したlazyだけを尊重する既定値のnormalも用意されています(Python 3.15のlazy import設定)。
遅らせるのは名前の束縛後に行うmoduleの解決と実行
lazy importは、読み込んだmoduleの中で特定のfunctionの定義だけを省略する機能ではありません。 moduleの読み込み自体を名前の初回利用まで遅らせます。 lazy from package import operationでも、operationだけをmoduleから切り出して実行するのではなく、module全体を読み込み、要求した名前を解決します。 同じstatementで複数の名前をimportした場合は、名前ごとにproxyを持ちます。 先に使った名前でmodule全体を読み込んでも、未使用の名前はproxyの状態を保ちます。 proxyの置き換えは、名前を参照する時点で行います(lazy importの実行規則)。
moduleを実際に解決する処理をreificationと呼びます。 reificationでは、通常のimportと同じく__import__を使いますが、参照するsys.pathやimport hookはreification時点の状態です。 importを宣言した時点の探索経路を保存し、後から同じfileを必ず開く契約ではありません。 宣言と初回利用の間に探索経路を変更するプログラムでは、読み込みの対象を決める時点も移ります。 起動時の処理量に加え、moduleのtop-level codeと、読み込み済みmoduleを参照する処理の実行順序も変わります(PEP 810のreification)。
通常のimportでは、moduleのtop-levelで設定した状態を、importの直後から使える場合があります。 たとえばdecoratorがplugin registryへfunctionを登録するmoduleなら、importを実行したことが登録の契機でした。 lazy importへ変えると、名前を宣言しただけの経路では登録が実行されません。 registryを読む処理がlazyなmoduleの名前を使わないまま進むと、moduleが登録するはずのentryを取得できません。 moduleの名前を直接使わない副作用に依存していた経路は、名前の初回参照という新しい実行条件と一致しない場合があります(PEP 810のimport時の副作用)。
失敗したproxyは、次の参照で再試行する
broken_lazy.pyのtop-levelで例外を送出すると、名前の参照ごとにmoduleの読み込みを再試行します。
print("broken module entered")
raise RuntimeError("unavailable")
呼び出し側では、lazy importの宣言後に同じ名前を2回参照します。
lazy import broken_lazy

print("import declared")
for index in range(2):
    try:
        print(broken_lazy.VALUE)
    except RuntimeError as error:
        print("failed", index, type(error).__name__)
import declared
broken module entered
failed 0 RuntimeError
broken module entered
failed 1 RuntimeError
宣言だけではmoduleを実行せず、参照のたびに未解決のproxyから読み込みを始めます。 読み込みの失敗も、成功済みmoduleとしては保存しません。 失敗を初回だけで固定するmemoizationとは、再参照の結果が異なります。 moduleのtop-levelで例外の前に行った副作用も、再試行のたびに実行される可能性があります。 broken_lazyは、例外を送出するたびに同じmessageを再表示します。 外部への登録や書き込みを伴うmoduleでは、失敗前に実行した操作が残り得ます。 lazy importが失敗の時点を遅らせても、moduleの実行全体をtransactionとして巻き戻す機能を加えるわけではありません(PEP 810の失敗時のproxy)。
明示したlazyをtryの中へ置くことはできません。 try: lazy import optionalという形でimportの成否を囲んでも、例外が発生するのは名前の利用時なので、囲んだ範囲と失敗する範囲が一致しなくなります。 3.15はmodule scopeのlazyだけを許可し、function、class body、tryの中やstar importへの指定を拒否します。 function内にlazy importを置くと、parse時に拒否します。
def load():
    lazy import json
# SyntaxError: lazy import not allowed inside functions
functionを呼ぶ前にsourceの構文として拒否されるため、使わないfunction内なら許可されるという条件でもありません(lazy importの構文上の制限)。
全体のmodeとfilterは、lazyにできるimportの範囲へ適用する
既定のnormalは、明示的にlazyを付けたimportだけを遅延の候補にします。 allは通常のmodule-level importも候補にし、noneは明示したlazyも含めて即時に読み込みます。 ただし、function内やtry内、star importなど、lazyにできないimportの意味までは変わりません。 allでも、構文によって即時読み込みが残ります。 すべてのimportを無条件にproxyへ置き換える指定ではありません(PEP 810のglobal control)。
modeはPYTHON_LAZY_IMPORTS、-X lazy_imports=...、sys.set_lazy_imports()で指定できます。 runtimeのAPIによる指定が最も優先され、command line、環境変数の順に続きます。 sys.get_lazy_imports()は現在のmodeを返します。 複数の場所で設定する場合、環境変数の値だけから、実行中のmodeを確定できるわけではありません。 設定の優先順位は、moduleごとのimport宣言とは別に、processの動作を決めます。
sys.set_lazy_imports_filterは、遅延の候補を絞るAPIです。 importする側のmodule名、import対象の名前、fromlistをfilterへ渡します。 たとえば読み込み時の副作用が必要なmoduleだけを、全体のallから外す構成に使えます。 filterは、構文やmodeで遅延の候補になっていないimportを、無条件にlazyへ変更する機能ではありません。 明示したimportの形、全体のmode、filterの結果を経て、実際にproxyを作るかが決まります。 library内の通常のimportと、process全体のmodeやfilterを変更する操作では、影響するscopeが異なります(PEP 810のlazy imports filter)。
複数threadが同じmoduleを初めて利用する場合には、既存のimport lockとmodule cacheを使って読み込みを調整します。 すべてのmoduleをthreadごとに別々に初期化する機能ではありません。 読み込みが完了すれば、通常のimportと同じmoduleを利用します。 循環importでは、早すぎる名前の参照を遅らせて循環を避けられる経路もありますが、初期化途中のmoduleから未定義の名前を要求する経路まで消えるわけではありません。 必要な名前へ実際に到達した時点の依存関係が、読み込みを完了できるかを決めます(PEP 810のthread safetyとreification)。
frozendictは対応関係を固定し、値の内部までは固定しない
組み込み型のfrozendictは、作成後にkeyとvalueの対応を変更できないmappingです。 dictのsubclassではなく、Mappingとして読み取り操作を提供します。 dictから作る場合は浅いコピーであり、登録したvalueのobjectまで複製するわけではありません(PEP 814)。
source: dict[str, list[int]] = {"ports": [80]}
settings = frozendict(source)
source["extra"] = [443]
settings["ports"].append(8080)
print(list(settings), settings["ports"]) # => ['ports'] [80, 8080]
元のdictへ追加したextraはsettingsに現れませんが、共有しているlistの変更は現れます。 固定されるのはmappingの対応関係なので、設定全体を不変にしたい場合は、valueにもtupleなどの不変な値を使います(frozendictのshallow copy)。
keyとvalueがhash可能なら、frozendict自体もhash可能です。 一方、listをvalueに持つsettingsはhash可能にはなりません。 等価性とhashは挿入順に依存せず、frozendict(a=1, b=2)とfrozendict(b=2, a=1)の比較結果はTrueです(frozendictのhashと比較)。
読み取り専用viewではなく、対応関係のsnapshotを作る
types.MappingProxyTypeも書き込みを許可しないmappingを提供しますが、元のmappingのviewです。 元のdictへ別の場所からkeyを追加すると、viewにも新しいkeyが現れます。 frozendict(source)は作成時の対応関係を固定するため、元のdictへ追加してもkeyは増えません。 初期状態が{"a": 1}のdictへbを追加すると、snapshotとviewのkeyが異なります。
from types import MappingProxyType

source = {"a": 1}
snapshot = frozendict(source)
view = MappingProxyType(source)
source["b"] = 2
print(list(snapshot)) # => ['a']
print(list(view))     # => ['a', 'b']
書き込み用のmethodを公開しない性質だけでは、外部からの変更が見えるかまでは同じになりません(PEP 814のcopy、MappingProxyType)。
浅いcopyなので、valueとして同じobjectを保存する関係は残ります。 settingsからportsのkeyを削除したり、対応するlistを別の値へ置き換えたりはできません。 しかし、保存したlistへのappendでは、mappingの対応関係は変わりません。 設定のsnapshotがmutableなobjectを参照していれば、keyの集合を固定しても、参照先の内容は変化し得ます。 frozendictが提供する不変性の単位は、object graph全体ではなくmappingです。
既存のfrozendictを浅くcopyすると、元のobjectを返します。
import copy

left = frozendict(a=1, b=2)
print(copy.copy(left) is left) # => True
print(left.copy() is left)     # => True
同じ対応関係の不変なmappingを浅くcopyする際、別の容器を作る必要がないためです。 ただし、valueがmutableな場合に内容を独立させる要求を、浅いcopyで満たすことはできません。 元のdictから初めて構築する操作と、すでにあるfrozendictを浅くcopyする操作では、独立させる対象が異なります。 同じcopyという名前でも、参照先まで再帰的に複製する操作を意味しません(PEP 814のcopy規則)。
反復順序を保ちながら、等価性は対応関係で決まる
frozendictは挿入順を保って反復できます。 挿入順が異なる2個のfrozendictでも、対応関係が等しければ等価性とhashは一致します。
left = frozendict(a=1, b=2)
right = frozendict(b=2, a=1)
print(list(left))                 # => ['a', 'b']
print(list(right))                # => ['b', 'a']
print(left == right)              # => True
print(hash(left) == hash(right))  # => True
反復順序を保つ規則と、keyとvalueの対応で等価性を決める規則を、別に定義しています。 hashを使う容器へ入れた場合に、挿入順だけが異なる値を別のmappingとして扱う仕様ではありません(PEP 814のiterationとcomparison)。
hashを計算できる条件は、valueの型にも依存します。 listを含むfrozendict(ports=[80])へhashを適用すると、TypeErrorになります。 mappingへ書き込みできない事実だけから、任意のvalueのhashまで作れるわけではありません。 整数やtupleなど、hash可能な値から組み立てたmappingは、setの要素やcacheのkeyとして利用する条件を満たせます。 文字列などのhashはprocess間で同じ数値になる契約ではないので、hash値を保存して永続的な識別子にする用途とは異なります(PEP 814のhashing)。
mergeは既存の値を変えず、結果のmappingを作る
|ではmappingをmergeできます。 右側のmappingとkeyが重複すれば、右側のvalueを結果へ採用します。
left = frozendict(a=1, b=2)
merged = left | {"b": 3, "c": 4}
print(dict(merged))                 # => {'a': 1, 'b': 3, 'c': 4}
print(isinstance(merged, frozendict)) # => True
print(dict(left))                   # => {'a': 1, 'b': 2}
重複するbには右側の値が入り、左側の元のfrozendictはa=1, b=2のままです。 dictを右側へ渡したからといって、既存の不変なmappingがmutableな容器へ変わる動作ではありません(PEP 814のunion operators)。
dictのsubclassではないため、isinstance(value, dict)を前提にしたAPIでは、同じ型として受け取れません。 読み取り操作だけを要求するAPIなら、Mappingとして扱う型の境界が対応します。 逆に、渡されたmappingへkeyを追加するAPIへfrozendictを渡せば、読み取り可能であるだけでは要求を満たしません。 新しい組み込み型を採用するときには、内容の型だけでなく、呼び出し先が変更操作を要求するかで互換性が変わります。 元のdictに対する変更を止めるだけのwrapperとして、無条件に置き換えられる型ではありません。
sentinelで未指定とNoneを分ける
sentinelは、未指定を表す専用の値を作る組み込み型です。 Noneが有効な入力であるAPIでも、引数を省略した場合と区別できます。 単純なobject()による代用と異なり、表示名、copy後の同一性、pickle後の同一性を扱う規則が用意されています(PEP 661)。
MISSING = sentinel("MISSING")

def describe(value: str | MISSING | None = MISSING) -> str:
    if value is MISSING:
        return "omitted"
    if value is None:
        return "null"
    return value

print(describe(), describe(None), describe("ready"))
出力はomitted null readyです。 判定にはisを使うため、通常の文字列の内容と衝突しません。 moduleに定義したsentinelは、copyやpickleの往復でも同一性を維持します(sentinelの同一性と型)。
sentinelの名前は、通常の入力値と同じ内容を比較するための名前ではない
sentinel("MISSING")の表示はMISSINGです。 単純なobject()の表示に現れるaddressとは異なり、default argumentや診断へ表示したときにも、未指定を表す名前を読めます。 ただし、文字列"MISSING"が入力されても、value is MISSINGには一致しません。 文字列の内容や、任意の入力の__eq__に依存せず、専用のobjectの同一性で未指定を判定します。 ユーザーが渡す文字列の集合と、未指定という状態が、同じ比較条件で衝突しない構成です(PEP 661のsentinelの表現と同一性)。
bool(MISSING)はTrueです。 したがって、if value:は未指定の検査を代替しません。 describeのNoneは明示的にnullを渡す意味、MISSINGは引数を省略する意味です。 さらに空文字列も有効な値なら、truthinessによる条件では空文字列とNoneを同じ分岐へ入れてしまいます。 is MISSING、is None、通常の値という分岐は、入力の状態を3種類に分けるAPIの契約を表します。
copyやpickleを通る処理では、未指定の判定に使うobjectが複製後も同じである必要があります。 moduleのtop-levelへMISSINGを束縛すれば、pickleの復元時も同じ名前からsentinelを解決できます。
import copy
import pickle
from sentinellib import sentinel

MISSING = sentinel("MISSING")
print(bool(MISSING))                              # => True
print(copy.copy(MISSING) is MISSING)               # => True
print(copy.deepcopy(MISSING) is MISSING)           # => True
print(pickle.loads(pickle.dumps(MISSING)) is MISSING) # => True
単に表示名だけを再現し、別のobjectを作る結果ではありません。 pickleが名前を解決できるよう、module内の名前として定義したsentinelを使っています。 任意のlocal変数へ一時的に作った値まで、別processから同じglobal名で解決できるという説明ではありません(PEP 661のserialization)。
型の表記では、sentinel自身を型式の一部として使えます。 str | MISSING | Noneは、文字列、専用の未指定値、nullの集合を表しています。 通常のobjectという型だけへ広げると、未指定以外の任意のobjectまで型上の候補になりますが、sentinelの型を使えば専用の状態を残せます。 is MISSINGで分岐した後の値をtype checkerが絞り込むための情報にもなります。 runtimeに専用の値を作ることと、annotationへ専用の状態を表すことを、同じ定義で接続する仕組みです(PEP 661のtype checking)。
comprehensionの各反復で展開する
comprehensionで*と**を使えるようになりました。 複数のlistを平坦化する場合、各反復で返すlistの要素を*groupで展開できます。 mappingなら**partでkeyとvalueを展開し、重複するkeyには後から現れるvalueが入ります(PEP 798)。
print([*group for group in [[1, 2], [3]]])
print({**part for part in [{"a": 1}, {"a": 2, "b": 3}]})
出力は[1, 2, 3]と{'a': 2, 'b': 3}です。 外側のlistの形を残す[group for group in ...]とは異なり、各反復が複数の要素を結果へ追加します。
comprehensionの1反復が、0個以上の要素を出力する
[*group for group in groups]では、外側の反復がgroupを1個選び、選んだ値を展開します。 空のgroupなら要素を追加せず、2個の要素を持つgroupなら2個追加します。 空のgroupを含む入力でも、出力するlistへ空の要素を追加しません。
groups = [[1, 2], [], [3, 4]]
print([*group for group in groups]) # => [1, 2, 3, 4]
外側の反復回数と、出力する要素数が一致する必要はありません。 別のforを重ねて各要素を取り出す構成と同じ平坦化を、反復結果の展開として直接表せます(PEP 798のlist comprehension)。
set comprehensionの展開では、追加する値がsetの要素として処理されます。 複数のgroupに同じ値があれば、重複はsetの規則で除かれます。 listの平坦化が順序付きで重複を保存することと、setへまとめることは、出力する容器の契約が異なります。 sortedで結果の集合を比較すれば、setの表示順へ依存せずに重複の除去を表せます。
groups = [[1, 2], [2, 3], [4]]
print(sorted({*group for group in groups}))  # => [1, 2, 3, 4]
展開する構文を共通に使えても、set自体へ挿入順の契約を追加する変更ではありません。
dict comprehensionの**partは、mappingのkeyとvalueを結果へ反映します。 function callのkeyword argumentでは、重複したkeyをerrorにする場面がありますが、dictを構築する展開では後のvalueが採用されます。 dict comprehensionの結果でaが2になるのは、2個目のmappingがaを上書きするからです。 **という同じ記号だけから、keyword argumentとdict構築の重複処理を同一視できません。 comprehensionへ追加した展開は、出力先のdictの構築規則に従います(PEP 798のdict unpacking)。
UTF-8の既定化とpackage startupの変更
UTF-8 modeが既定で有効になり、明示的なencodingがないtext file、標準入出力、pipeのencodingに影響します。 locale固有のencodingを使う必要がある場合はencoding="locale"で指定できます。 PYTHONUTF8=0または-X utf8=0による無効化も残っています(PEP 686)。
たとえば従来の既定encodingで保存したファイルをopen(path)で読むコードは、同じファイルでもUTF-8としてdecodeするようになります。 encodingを省略した読み書きが変更対象であり、すでにencoding="utf-8"やencoding="cp932"を指定した操作は指定したencodingを使います。 localeのencoding自体を調べるlocale.getencoding()は、UTF-8 modeに左右されません(PEP 686の互換性とlocale API)。
既定のencodingを変えても、既存fileのbyte列は変わらない
UTF-8 modeは、encodingを省略した操作が選ぶ規則を変えます。 保存済みのfileを探してUTF-8へ変換する移行処理ではありません。 CP932でencodeしたfileをUTF-8として読むと、decodeに失敗する場合があります。 encodingを明示すれば、元の文字列へ復元できます。
from pathlib import Path
from tempfile import TemporaryDirectory
import sys

with TemporaryDirectory() as directory:
    path = Path(directory) / "legacy.txt"
    path.write_bytes("日本語".encode("cp932"))
    print(sys.flags.utf8_mode) # => 1
    try:
        with path.open() as stream:
            stream.read()
    except UnicodeDecodeError as error:
        print(type(error).__name__) # => UnicodeDecodeError
    print(path.read_text(encoding="cp932")) # => 日本語
入力のbyte列は同じでも、decodeする規則の違いが成功と失敗を分けます。
すでにUTF-8を既定にしていたlocaleでは、3.14以前から同じencodingを選ぶ場合があります。 version番号の更新だけで、すべての環境の読み込み結果が変わるわけではありません。 変更が現れるのは、以前の既定値がUTF-8と異なり、かつencodingを明示していなかった操作です。 encoding="locale"は、UTF-8 modeの既定値とは別にlocaleのencodingを選ぶ指定として残ります。 外部fileの形式がCP932だと分かっている場合には、localeの値へ依存する指定と、形式を明示する指定でも意味が異なります(PEP 686の互換性)。
locale.getencoding()は、UTF-8 modeを反映したtext I/Oの既定値を返すためのAPIではありません。 OSのlocale encodingを調べるため、UTF-8 modeでもlocaleの値を返します。 一方、text I/Oが使うencodingは、明示した引数、UTF-8 mode、標準streamの設定などから決まります。 localeが返した名前だけを使って、encodingを省略したfileの動作を再現する処理は、新しい既定値とずれる場合があります。 PYTHONUTF8=0や-X utf8=0は、modeを無効にするprocessの設定です(PEP 686のlocale APIの区別)。
起動処理には.startファイルが加わりました。 既存の.pthがsys.pathの拡張とimport行の実行を兼ねていたのに対し、.startにはpkg.mod:callable形式のentry pointを記述します。 起動時には対応するcallableを引数なしで呼び出します(PEP 829)。
同名の.startがあれば、対応する.pth内のimport行は実行されません。 .pthのpath拡張は維持されるため、pathの登録と起動時のコード実行を別々に移行できます。 3.15で.pthのimport行が一律に動かなくなる変更ではありません(PEP 829のdiscoveryと互換性)。
pathの収集を終えてから、起動時のentry pointを実行する
.pthのimport行は、文字列をexec()へ渡して起動時のcodeを実行する形式でした。 .startは、moduleとcallableの名前を指定し、名前を解決して呼び出す形式です。 startup_hooks:bootなら、startup_hooksからbootを取得して引数なしで呼びます。 moduleだけの名前や、callableを省いた指定を、任意のPython sourceとして評価する形式ではありません。 fileの構文として許可する入口を、起動時のfunction呼び出しへ限定しています(PEP 829のentry point構文)。
複数のsite directoryがある場合、起動codeが必要とするmoduleのpathが、後で処理するdirectoryの.pthに書かれている場合があります。 directoryを1個ずつ即時に処理する構成では、先のentry pointが実行される時点で、後のpathがまだ登録されていません。 3.15のsite.StartupStateは、複数directoryの設定を集め、path拡張を先に適用してからcodeを実行します。 pathの探索に必要な入力を揃える段階と、起動codeを実行する段階を分けるための状態objectです(site.StartupState)。
site-aにdemo.start、呼び出すmoduleを別のextra directoryへ置く構成を考えます。 extraのpathは、後から読むsite-b/paths.pthにだけ記載しています。 state.addsitedirによるdirectoryの登録だけでは、startup_hooksを読み込みません。 state.process()を呼ぶと、先にpathが有効になり、demo.startのbootを実行します。
state = site.StartupState()
state.addsitedir(str(root / "site-a"))
state.addsitedir(str(root / "site-b"))
print("before", "startup_hooks" in sys.modules) # => before False
state.process()
# => new startup
print("after", "startup_hooks" in sys.modules)  # => after True
addsitedirで収集した設定は、process()を呼ぶまで適用しません。 一方、process()は同じinstanceに何度呼んでも同じ結果になる操作ではありません。 再び呼ぶと、entry pointや旧式のimport行をもう一度実行します。 設定を集めるAPIがあるからといって、処理済みかを自動で判定し、副作用を1回に抑える保証まで持つわけではありません。 1個の起動処理に対して収集を終え、実行を1回行う契約になります(StartupState.process)。
同じsite-aに旧式のdemo.pthもある場合、同名の.startがcode実行の入口として優先されます。 同名のdemo.startがあるため、legacy startupというmessageは出力されません。 .pth内のpathの行まで無効になる規則ではなく、同名fileがある場合のcode実行の入口を.startへ移します。 pathの拡張とcodeの実行を、別のfileへ段階的に移せる条件です。 prefixはpackage名と必ず一致する必要はありませんが、対応する.pthと.startを結び付ける名前になります(PEP 829のfile discovery)。
entry pointを実行して例外が出た場合は、errorを標準errorへ表示し、次のentry pointの処理を続けます。 構文として不正なentry pointはskipされ、読み込めないfileも後続のfileの処理へ進みます。 .startを置けば、起動時の任意の失敗がprocess全体の起動失敗になる、という契約ではありません。 fileをparseする際の失敗と、callableを実行した際の失敗には、報告の規則も違いがあります。 複数の起動処理を定義するpackageでは、前のentry pointが成功した状態だけを暗黙に前提とする依存関係に注意が必要です(PEP 829のerror handling)。
.startのencodingはUTF-8で、BOMも許可します。 通常のtext fileのencodingを省略する操作とは異なり、startup file自体の形式として定義されています。 file名がdotで始まるものや、OSのhidden属性が付いたfileはdiscoveryから除外します。 directory内のfileはアルファベット順で処理します。 起動処理の順序は、file systemが返す列挙順だけでは決まりません(PEP 829のencodingとdiscovery)。
profiling、typing、C extensionの変更
新しいprofiling packageでは、tracingとsamplingのprofilerを別のnamespaceに整理します。 tracingはfunctionの呼び出しとreturnを計測し、samplingは時点ごとのstackから実行時間の分布を推定します。 Tachyonのsampling profilerは複数thread、async、free-threaded build、実行中processへのattachを扱います。 既存のcProfileは残り、pure Python実装のprofileはdeprecatedです(PEP 799)。
samplingは、呼び出し回数ではなく時点ごとのstackを集計する
profiling.tracingは、functionの呼び出しとreturnに沿って記録する方式です。 profiling.samplingは、実行中のstackを時点ごとに読み、頻繁に現れる処理を集計します。 短いfunctionがsampleの間で実行を終えれば、1回もstackに現れない場合があります。 したがって、sampleに現れた回数を、functionの正確な呼び出し回数として扱うことはできません。 新しいnamespaceの整理は、同じ測定値を別名で提供するためだけの変更ではありません(profiling packageの構成)。
sampling profilerのcommandは、python -m profiling.sampling run script.pyで対象を起動する形です。 attachは実行中processへ接続し、dumpは現在のstackを取得し、replayは保存したbinary profileを別の形式へ変換します。 run --liveは収集内容を対話的に表示する入口ですが、保存した集計値と同じく、sampleから得た分布として読む必要があります。 profile fileはsampleを採った処理と条件へ対応し、別のworkloadの高速化率を表しません(profiling.samplingのcommand)。
wall-clock、CPU、GILなどのmodeも、集計する条件が異なります。 I/Oを待つ時間を含むstackの分布と、CPUで実行している時間の分布は、同じ処理へ同じ割合を割り当てるとは限りません。 asyncな処理では、taskの関係を考慮してstackを再構成する機能もあります。 threadのstackだけを並べる場合と、論理的なtaskの連なりを追う場合で、遅延の原因を割り当てる対象が変わります。 tracingとsamplingの選択に加え、samplingのmodeも結果の意味を決める入力です(sampling profilerのmode)。
typingでは、TypedDictの既知のkey以外に入るvalueの型を指定するextra_itemsが追加されました。 TypeFormはint | strのような型を表す式の値を受け取るAPIを記述します。 disjoint_baseは、無関係なdisjoint base同士を同時に継承できないとtype checkerへ伝えます(PEP 800)。
TypedDictで既知のkey以外の型も表す
TypedDictは、keyごとに異なるvalueの型を表せます。 3.15のextra_itemsは、名前を宣言していないkeyのvalueへ型を指定するためのparameterです。 たとえば既知のnameをstr、追加のkeyの値をintとすれば、固定fieldと追加の数値fieldを同じmappingの型へ表せます。 単にdict[str, object]へ広げると、既知のnameから取り出す型までobjectになります。 TypedDictでは既知のkeyの型を保存します(PEP 728のextra items)。
closed=Trueは、追加のkeyを許可しない型を表します。 total=Falseのように、宣言済みのkeyを省略できるかを変える指定とは異なります。 追加keyの許可と、既知のkeyの必須性を同じ条件へまとめると、入力として受け取るmappingの集合が変わります。 extra_itemsに指定する型は、既知のkeyすべての型と同じである必要はありません。 追加fieldを型付けする機能なので、既知のfieldを一律に同じvalue typeへ制限する変更ではありません(PEP 728のclosedとtotality)。
runtimeのTypedDictは、通常のdictを作るという性質を保ちます。 annotationを宣言しただけで、入力されたJSONの未知のkeyを実行時に削除したり、追加のvalueを検証したりはしません。 追加の型情報はtype checkerが扱う契約です。 外部入力を受け取るAPIでは、型として表現できる条件と、runtimeで検査した入力の条件を分ける必要があります。 3.15の型表現が増えた事実だけから、既存のvalidationの実装が不要になるわけではありません(PEP 728のruntime behavior)。
TypeFormはclass objectより広い型式を受け取る
type[T]は、class objectを受け取るAPIを表す型です。 TypeForm[T]は、int | strやlist[int]など、型式を評価して得た値まで扱います。 たとえばschemaから値を検証するfunctionが、受け取った型式に対応する型を返す場合、入力の型式と戻り値の型を同じTで結び付けられます。 型式を単なるobjectとして受け取る宣言では失われていた関係を、annotationに残すための機能です(PEP 747のspecification)。
TypeFormは、型式を解釈してvalidationを実行する実装を提供するものではありません。 union、generic alias、literal typeなどを実際の値へ照合する処理は、利用するlibraryの役割として残ります。 同様に、annotationへTypeForm[T]を書けば、任意のobjectを安全にTへcastできるという規則でもありません。 渡す型式の型と、検証後に返す値の型を結び付けるannotationです(PEP 747のconverterとassignability checker)。
disjoint_baseは、多重継承できる組み合わせへ別の情報を加えます。 CPythonには、MROやmetaclassの整合性とは別に、instance layoutの理由で同時に継承できないclassがあります。 非空の__slots__を持つclassや、多くのC実装の組み込み型が関係します。 type checkerは、無関係な2個のdisjoint baseを共通の派生型へ含められないと判断できます。 class宣言の不整合や、成立しない型の重なりを検出するための情報です。 単独のclassを一律に継承禁止へするfinalとは、制限する関係が異なります(PEP 800のlayoutとdisjoint bases)。
C extensionでは、free-threaded build向けのStable ABIであるabi3tが追加されています。 従来のabi3のbinaryを無変更で使えるわけではありません。 objectのinstance structやmoduleのexport hookなどの修正が必要です。 対応できないextensionは、従来のabi3と、free-threaded build用のversion固有のABIを分けてbuildします(Python 3.15のStable ABI)。
abi3tではPyObjectの内部layoutを固定しない
従来のStable ABIは、GIL-enabledなCPythonの複数のminor versionで同じextension binaryを使うための契約です。 free-threaded buildでは、reference countingなどに必要なobjectのlayoutが異なるため、従来のbinaryを無変更で適用する契約にはできません。 abi3tはPyObjectをopaqueにし、直接のstruct layoutへ依存しないAPIでextensionを作ります。 内部layoutを将来変更できる範囲を残しながら、free-threaded buildでも複数versionへ対応する境界を作る方式です(PEP 803のStable ABI)。
targetの指定には、既存のPy_LIMITED_APIに加えてPy_TARGET_ABI3Tを使います。 両方へ対応するextensionを明示的にbuildし、wheelのABI tagでabi3.abi3tと示す経路も定義されています。 tagの名前だけを変更して、従来のbinaryを両方へ対応したことにする移行ではありません。 sourceが使うAPIと、build時に選んだtarget ABIが条件になります。 Stable ABIが対象にする将来versionへの互換性と、異なるthreading build間の互換性を、別の軸として表します(PEP 803のtarget ABIの指定)。
staticなPyModuleDefも移行に関わります。 従来のmodule定義には、PyObjectを含むstructをstaticに置く形があり、opaqueなlayoutと両立しません。 新しいmodule export hookでは、moduleを構成するslotの配列を入口にでき、外側のPyModuleDefを必須にしません。 moduleを作る入口を内部objectの固定layoutから切り離す変更が、ABIの共有を妨げていた構造を取り除きます。 旧式のPyInit_*はsoft deprecatedで、3.15で直ちに削除される機能ではありません(PEP 793のexport hook)。
slotの表現もPySlotへ整理されます。 tagとflagsを持つunionにすることで、slotごとの型を区別し、将来追加されるslotを扱える形を用意します。 型の異なる値を、一律のpointerのように扱って渡す入口から、slotが要求する値を表現できる入口へ移します。 3.15で追加するmodule生成APIやexport hookも新しいslotを使います。 既存のslot structとAPIは、引き続き動くsoft deprecationの扱いです(PEP 820のslot system)。
実行環境側ではexperimental JITが更新され、frame pointerが既定で有効になりました。 公式Windows 64-bit binaryはtail-calling interpreterを使います。 公式macOS installerでは、free-threadingの構成が既定で入ります。 C APIにはbyte列を組み立てるPyBytesWriterが追加されました。 interpreterの終了処理に競合するthreadを扱う保護APIも加わっています(Python 3.15のC API)。
PyBytesWriterは構築途中の領域と完成したbytesを分ける
従来のC APIでは、PyBytes_FromStringAndSize(NULL, size)で未初期化の領域を持つbytesを作り、後から内容を埋める方法がありました。 Pythonから見るbytesは不変ですが、構築途中には内容を変更する特殊な状態を作る方式です。 PyBytesWriterは、書き込み中のbufferを管理するobjectと、完成後に返すbytesを分けます。 出力sizeが増える場合のoverallocationも扱い、増えるたびに必要なsizeだけへ再確保する実装を避けられます(PEP 782の構築途中のobjectとallocation)。
writerは生成し、内容を書き込み、成功時にfinishしてbytesを取得します。 失敗した経路ではdiscardして、構築途中のresourceを解放します。 bufferの成長後も、以前取得したpointerを使い続けられるとは限りません。 pointerを更新するAPIも用意されています。 完成した不変の値を外へ返す前に、可変な構築状態をwriterの生存期間へ閉じ込める契約です。 旧APIはsoft deprecatedで、warningを出して一律に拒否する移行ではありません(PEP 782のwriter API)。
interpreterの寿命と、thread stateのattachを別に管理する
native libraryが作ったthreadからPythonへcallbackする場合、callbackの開始時点でinterpreterが終了処理へ入る競合があります。 単にinterpreterのpointerを保存していても、終了済みのinterpreterへattachしてよい保証にはなりません。 PyInterpreterGuardは、保持している間にinterpreterがfinalizationへ入らないようにするguardです。 複数threadがguardを保持でき、finalizationはguardがすべて閉じるまで待ちます。 終了が始まった後には新しいguardを取得できません(PEP 788のinterpreter guards)。
PyInterpreterViewは、終了中または終了済みのinterpreterも参照できるopaqueなviewです。 viewからguardを取得する際に、まだ利用できるinterpreterかを判定します。 viewを保存すること自体と、interpreterの終了を止めるguardを保持することは同じ操作ではありません。 外部libraryへ長期間callbackを登録する構成なら、viewを登録情報として保存できます。 callbackの実行中だけguardを保持する構成とは、生存期間が異なります(PEP 788のinterpreter views)。
guardで保護したinterpreterへthread stateをattachする入口がPyThreadState_Ensureです。 成功時のtokenを対応するreleaseへ返すことで、以前attachしていた状態へ戻します。 対象のinterpreterを保護する条件と、現在のOS threadに適切なthread stateを用意する条件を別に扱います。 guardを閉じ忘れるとfinalizationが永久に待つため、保護するAPIを呼んだ事実だけでは終了処理の健全性を保証しません。 取得と解放を成功経路と失敗経路の両方へ対応させることが、新しいAPIの契約に含まれます(PEP 788のthread stateのattachとdetach)。
3.15.1は同梱pipの証明書bundleも更新する
3.15.1には約330件のbug fixが入り、同梱pipは26.2.2へ更新されました。 pipが使うcertifiは2026.10.19で、emSignのCAに関するincidentへの対応を含みます。 更新対象はinstallerに含まれるpipです。 既存のvirtual environmentのpipを自動更新する変更ではありません(Python 3.15.1の公開記録)。