Rust 1.99の変更をコードで追う
C variadic functionの定義、所有権を移すNonNull API、raw pointerからのlayout取得と、1.99.1のABI修正を解説します。
Rust 1.99.0は2026年10月1日、修正版の1.99.1は10月15日に公開されました。 1.99.0ではC variadic functionの定義がstableになり、VecやBoxの所有権をNonNullで受け渡すAPIも加わっています。 1.99.1では、Cとの境界に関わるboolのABIなど、3件のregressionが修正されています(1.99.0の公式発表、1.99.1の公式発表)。
Cの可変長引数をRust側で受け取る
従来のstable Rustでも、C variadic functionを宣言して呼び出すことはできました。 1.99ではextern "C"とextern "C-unwind"のfunctionをRust側で定義できるため、Cから呼ばれる可変長引数の処理もRustで実装できます。 引数の...に対応するVaListから、next_arg::<T>()で値を順に取り出します(VaListのAPI)。
unsafe extern "C" fn sum(count: u32, mut values: ...) -> i32 {
    let mut result = 0;
    for _ in 0..count {
        result += unsafe { values.next_arg::<i32>() };
    }
    result
}

fn main() {
    println!("sum={}", unsafe { sum(3, 4_i32, 5_i32, 6_i32) }); // => sum=15
}
コード例の対象はRust 1.99.1、darwin/aarch64です。 countは残りの引数の個数を示す独自の約束であり、VaListが残数や型を検査しているわけではありません。 呼び出し側が2個しか渡していないのに3個読み出したり、実際には整数の引数をf64として取り出したりすると、next_argの安全性の条件に違反します。
Cのdefault argument promotionにも従う必要があります。 たとえばfloatはdoubleに、小さい整数型は整数昇格後の型になります。 したがって、C側でfloatだった値をRust側でnext_arg::<f32>()として受け取る実装にはできません。 引数を渡した後のABI上の型に合わせて読み出します(VaList::next_argのSafety)。
VaListの初期化と終了処理はcompilerが用意し、複製にはCloneを使えます。 複製した値はva_copyに対応する独立した走査位置を持ち、破棄時にはva_endに対応する処理が行われます。 元の走査位置を保持したまま引数を2回走査する場合も、内部表現をコピーせずclone()を使います(VaListの複製と破棄)。
呼び出しの個数と型を、functionの型だけでは表せない
固定の引数だけを持つfunctionなら、引数の個数や型が宣言に現れます。 可変部分を...で受け取るfunctionでは、可変部分の型を宣言に列挙できません。 sumの第1引数が3であることと、後ろに3個の整数があることは、呼び出し側と実装側で共有する約束です。 compilerが3という値から後続の引数を検査する仕組みではありません。 したがって、Rustで定義できるようになった後も、Cの呼び出し規約に依存する境界は残ります(C variadic functionの規則)。
同じ理由で、next_argのtype argumentは、実装が次に読み出す値の解釈を決めます。 実引数を調べて適切な型を選んでくれる操作ではありません。 たとえば整数、浮動小数点数、pointerを受け取る独自の形式なら、実装も指定された順序を維持します。 順番を間違えた後で残りの引数の解釈を正しく戻せる保証はなく、不一致を通常のResultとして回収するAPIでもありません。 可変長引数を受けるfunction自身で、読み出す型の集合と順番を決めます(VaList::next_arg)。
sumを呼ぶ実引数と、next_argで取り出す型には、同じi32を指定しています。 単に4とだけ書いた値のtype inferenceへ依存せず、呼び出し規約で受け渡す型をコードに残すためです。 加算結果の15は、4、5、6を順に取得できた場合の結果です。 別の型や個数を受け取る呼び出しには、受け取る形式に対応した読み出し処理が必要です。 functionをCへ公開する場合も、利用者が渡す形式を別に定める必要があります。
extern "C-unwind"を選ぶ条件と、可変長引数を扱う条件は別です。 ABIを越えるunwindを許す境界と、許さない境界を区別する指定です。 VaListの型検査を追加する指定ではありません。 可変部分の読み出しに失敗する呼び出しを、unwind可能なABIへ変えるだけで正しく扱えるようにはなりません。 可変長引数の契約と、例外やpanicが境界を越える契約を、呼び出し規約に合わせます(RustonomiconのFFIとunwind)。
VaListを複製した位置から読み直す
走査位置の複製は、最初から引数を取り直す操作とは異なります。 最初の整数4を取得してからVaListを複製すると、元の値と複製した値の両方が、次の整数5の手前を指します。 元の位置は次の整数5へ進んでいるので、複製した位置も5の手前になります。
unsafe extern "C" fn cursors(_count: u32, mut values: ...) -> i32 {
    let first = unsafe { values.next_arg::<i32>() };
    let mut copied = values.clone();
    let second = unsafe { values.next_arg::<i32>() };
    let second_copy = unsafe { copied.next_arg::<i32>() };
    println!("cursors={first}/{second}/{second_copy}"); // => cursors=4/5/5
    first + second + second_copy
}

fn main() {
    let total = unsafe { cursors(3, 4_i32, 5_i32, 6_i32) };
    assert_eq!(total, 14);
}
5を2回読んでいるのは、同じ走査位置を2つの独立した状態から読んだからです。 元のvaluesから5を読んでも、複製したcopiedは5の手前に残ります。 可変長引数を数える処理と実際に処理する操作を分ける場合にも、必要なのは走査位置の複製であり、引数のbyte列を手作業で複製することではありません。
cursorsのbodyは_countを参照しません。 cursorsのbodyは先頭2個の整数だけを読み、残数を計算しません。 sumのように個数に従ってすべて読むAPIへ変える場合は、複製した位置から残り何個を読むかも実装で管理します。 複製した後に最初の個数を繰り返し回数に使うと、すでに消費した分を余計に読み出す場合があります。 走査位置の保存と、残数の管理は別の状態です。
新しい定義機能は、Rustで型の決まったsliceを受け取るfunctionを、可変長引数へ自動変換するものでもありません。 sliceには要素の型と長さが付随しますが、C variadic functionでは可変部分の型を共有する別の形式が必要です。 Rust同士の呼び出しだけで完結するAPIなら、sliceで表現できる情報を可変部分へ移す必然性はありません。 1.99の追加が直接埋めるのは、C側が要求する可変長引数のentry pointをRust側で定義する部分です(RustのfunctionとABI)。
NonNullで所有権を外へ移し、同じallocationを取り戻す
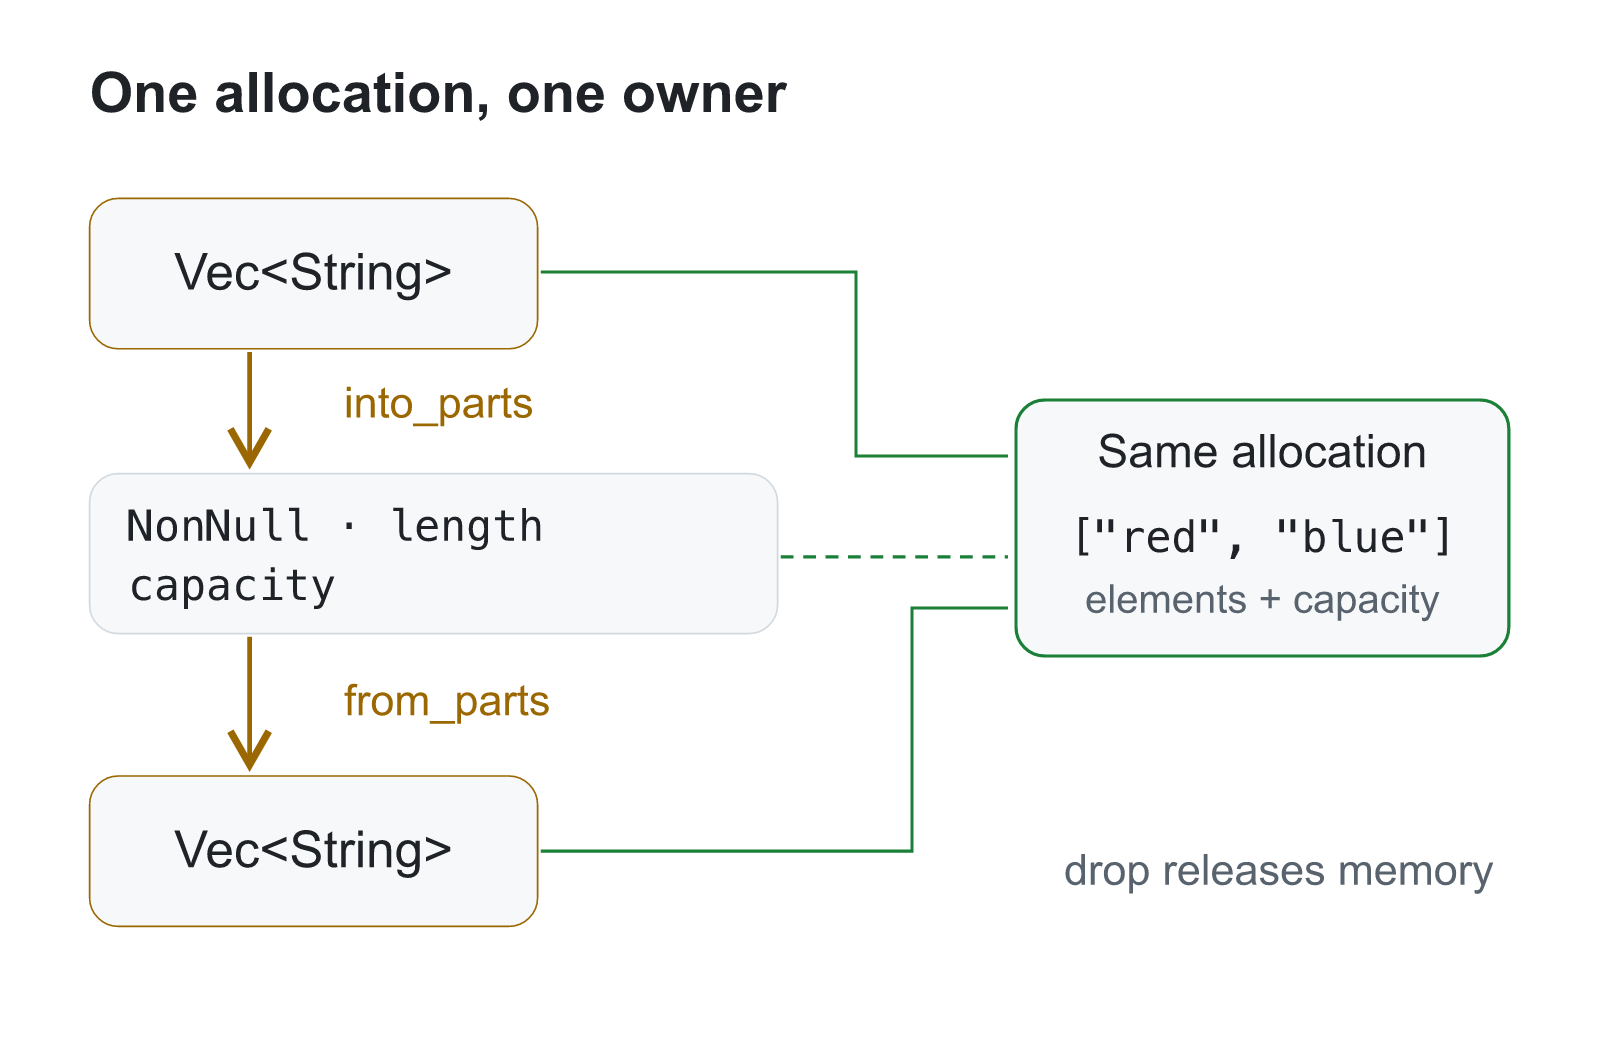
Vec::into_partsはVecを消費し、NonNull<T>、長さ、capacityを返します。 返された値をVec::from_partsに渡せば、同じallocationを所有するVecを再構築できます。 要素を再コピーせず、allocationの管理を移します(Vec::into_parts)。 以下の断片はmainのbodyへ置きます。
let values = vec![String::from("red"), String::from("blue")];
let (pointer, length, capacity) = values.into_parts();
let restored = unsafe { Vec::from_parts(pointer, length, capacity) };
println!("owned={restored:?}"); // => owned=["red", "blue"]
into_partsの後は元のVecが存在しないため、restoredの破棄で要素とallocationが解放されます。 from_partsを同じ値で2回呼び出すと、allocationを解放する所有者が重複します。 また、capacityや要素型を変えると、allocationと解放時のlayoutが一致しなくなり得ます。 NonNullが保証するのはnullではないことまでであり、所有権、初期化済みの要素数、allocationのlayoutは呼び出し側が維持します(Vec::from_partsのSafety)。
Boxにもinto_non_nullとfrom_non_nullが加わりました。 Box::into_non_null(boxed)はBoxを消費してNonNull<T>を返し、Box::from_non_null(pointer)は所有者を再構築します。 後で解放する値の所有権を渡す場合、Box::leakを経由せず往復できます(into_non_null、from_non_null)。
let boxed = Box::new(String::from("owned"));
let pointer = Box::into_non_null(boxed);
let restored = unsafe { Box::from_non_null(pointer) };
println!("box={restored}"); // => box=owned
Boxのallocationを保持したまま所有者だけを外し、最後にBoxへ戻しているため、値を意図的に残し続ける処理は含まれていません。
NonNullへ変えても、所有者の個数は別に管理する
Vec::into_partsの返り値にあるpointerは、要素の先頭を示します。 長さは初期化済みの要素数、capacityはallocationが確保している要素数です。 再構築する側では、破棄する要素数と、allocationの解放に使うlayoutを両方復元します。 長さだけを保存してcapacityを失うと、要素の境界は分かっても、元のallocationを正しい条件で解放できなくなります(Vecの保証)。
Vec<String>の場合は、allocationの区別がさらに必要です。 VecはStringを並べる領域を確保し、各Stringは文字列用のallocationを別に持ちます。 into_partsで外へ移すのは、並んだStringの所有権も含むVec全体の管理です。 再構築したVecを破棄すると、初期化済みのStringのdestructorが動き、各文字列のallocationも解放されます。 要素用の領域だけを解放して済む操作にはできません(Rustonomiconのdestructor処理)。
破棄時にcounterを増やす要素を使うと、所有権の移動と要素の破棄を分けて表せます。
use std::cell::RefCell;
use std::rc::Rc;

struct Tracked(Rc<RefCell<usize>>);

impl Drop for Tracked {
    fn drop(&mut self) {
        *self.0.borrow_mut() += 1;
    }
}

let drops = Rc::new(RefCell::new(0));
let values = vec![Tracked(drops.clone()), Tracked(drops.clone())];
let address = values.as_ptr();
let (pointer, length, capacity) = values.into_parts();
assert_eq!(*drops.borrow(), 0);
let restored = unsafe { Vec::from_parts(pointer, length, capacity) };
assert_eq!(address, restored.as_ptr());
drop(restored);
assert_eq!(*drops.borrow(), 2);
into_partsは要素を破棄せず、from_partsは元のallocationを再利用します。 counterが増えるのは、所有権を受け取ったrestoredを破棄する段階です。
NonNullのpointer値を複製しても、要素とallocationの所有権は複製されません。 複製したpointerを使って2つのVecを再構築してしまうと、要素とallocationを破棄する権限まで重複させます。 最初のVecを破棄すると、残ったVecはすでに解放した領域を保持します。 新APIがnullの扱いを型へ移しても、再構築を1回に限る契約はfrom_partsを呼ぶ側に残ります(NonNullの契約)。
Box::into_non_nullでも、pointerの値を保存することと、解放を担当する所有者を保存することを区別します。 Boxを消費した直後には、通常のscope終了で値を解放するBoxは残りません。 再構築しない経路を選べば、値を解放する処理も自動では復活しません。 たとえば外部のcallbackへpointerを渡す設計では、成功時だけでなく、callbackを登録できなかった経路でも所有権を回収する必要があります。 登録先に所有権を渡せた経路と、呼び出し元へ戻す経路を同時に成立させない設計にします(Box::from_non_nullのSafety)。
従来のManuallyDropを使った実装では、自動のdestructorを止めてからpointer、長さ、capacityを取り出す方法がありました。 ManuallyDropは内側の値のlayoutやbitの有効性を変えず、破棄を抑制する型です。 したがって、破棄済みの値を後から安全な参照として公開してよい状態へ変える型ではありません。 into_partsはVecを消費する呼び出しに管理の移動をまとめるため、破棄を止めたVecを別に持ち続ける必要を減らします(ManuallyDropのAPI)。
Box::leakから参照を得る使い方も、所有権を移す使い方とは状態が異なります。 leakはBoxが持っていた値を自動解放しない状態へ移し、参照を返します。 後から参照をraw pointerへ変換して所有者を復元する設計では、まだ利用できる参照を残していないかまで考える必要があります。 最初から外部へ所有権を移して戻す用途なら、参照を作る過程を挟まず、消費するAPIで管理の移動を示せます(Box::leak)。
空のVecとzero-sized typeはallocationの例外になる
空のVec<u32>では、長さとcapacityは両方0です。 ただし、返されるpointerの型はNonNull<u32>です。 要素を1個も確保していない状態でも、null pointerを返すAPIにはなっていません。 nullではないpointerを、実際のallocationや初期化済みの値が存在する証拠として扱うことはできません(Rustonomiconの空のVec)。
空のcollectionを外部へ渡す際に、長さ0ならpointerを使わない約束を設けるAPIはあります。 しかし、外部APIの空の状態をnullで表す契約なら、NonNullの値を渡すだけで同じ表現になるわけではありません。 Rust側の空collectionの表現と、外部APIが受け取る空の表現を接続する処理が必要です。 反対方向から受け取る場合も、nullをfrom_partsへ無条件で渡す操作にはできません。 受け渡す側の型が保証する状態を、相手側の表現へ変換します。
zero-sized typeでは、要素数と確保byte数の対応も変わります。 vec![(); 3]では、長さは3、capacityはusize::MAXになります。 ()を3個保持していても、要素用に3 byte以上のallocationを確保したことにはなりません。 sizeが0の型は、要素数を増やしても要素用のbyte数が増えないためです(Rustonomiconのzero-sized type)。
zero-sized typeを扱う実装では、pointerの数値を要素sizeだけ増やして反復位置を表す方法を流用できません。 要素sizeを掛けた移動量は0なので、異なる論理的な要素の間でもbyte addressは変わりません。 一方、要素数の上限やdestructorを呼ぶ回数は依然として管理する必要があります。 genericな所有権移動に新APIを使う場合も、要素数、capacity、allocationのbyte数を別に管理します。 zero-sized typeでは、要素数からallocationのbyte数を逆算できないためです(zero-sized typeの反復とcapacity)。
参照を作らずに動的なlayoutを取得する
Layout::for_value_raw、mem::size_of_val_raw、mem::align_of_val_rawもstableになりました。 いずれもraw pointerから、指している値のsizeやalignmentを求めます。 sliceなら長さ、trait objectならvtableなど、unsized typeに付随するmetadataを使って動的なlayoutを決めます(Layout::for_value_raw)。
use std::alloc::Layout;

let data = [1_u16, 2, 3];
let pointer: *const [u16] = &data[..];
let layout = unsafe { Layout::for_value_raw(pointer) };
println!("layout={}/{}", layout.size(), layout.align()); // => layout=6/2
u16が3個なのでsizeは6 byteであり、alignmentは2 byteになります。 &data[..]は有効なsliceを作りますが、raw版のAPIが任意のmetadataを受け付けるわけではありません。 たとえばsliceの長さが初期化されていることや、全体のsizeがisizeの範囲に収まることなど、API固有の条件を満たす必要があります(for_value_rawのSafety)。
raw pointerからの照会が必要になる位置
size_of::<T>()は、型だけでsizeが決まる場合に使えます。 [u16]のようなsliceでは長さが型名に含まれないため、具体的な値に付随するmetadataからsizeを求めます。 size_of_valは参照を受け取り、size_of_val_rawはraw pointerを受け取ります。 新APIは、raw pointerを扱う処理の途中で、照会のためだけに参照を作る必要を減らします(size_of_val_raw)。
たとえばallocationの管理を外へ移した後でも、unsizedな値のlayoutを保持しておく必要はあります。 再構築や解放で使うsizeとalignmentは、値の中身を読み取る処理とは別の情報です。 raw版のAPIはlayoutの照会を表現しますが、pointerが値を読み出せる状態にあると追加で保証するわけではありません。 照会できたlayoutから、参照を作れることや、参照を使って値を変更できることまで導くことはできません(align_of_val_raw)。
trait objectでは、長さの代わりにvtableから具体的な型のlayoutを求めます。 [u8; 12]を&dyn Debugとして扱う場合も、raw pointerに付随するvtableからlayoutを求めます。 dyn Debugという名前だけから12という値は決まらず、元の具体的な型に対応するmetadataが結果を決めています。
let value = [7_u8; 12];
let erased: &dyn std::fmt::Debug = &value;
let pointer = erased as *const dyn std::fmt::Debug;
let layout = unsafe { Layout::for_value_raw(pointer) };
println!("erased-layout={}/{}", layout.size(), layout.align()); // => erased-layout=12/1
erased as *const dyn Debugは、有効なtrait objectの参照をraw pointerへ変換します。 vtableを任意の整数値から組み立てる処理や、別の具体型のmetadataへ付け替える処理は含みません。 layout照会のためのmetadataが正しい経路で得られていることを、呼び出しの前提にしています。 raw pointerを受け付けるというAPIの形だけを根拠に、任意のbit列を入力できるとは解釈できません(Layout::for_value_rawの契約)。
sliceの例でsizeが6、alignmentが2だったのも、同じ分離を示します。 長さ3は要素数であり、sizeの6はbyte数です。 alignmentの2は、先頭addressに要求する境界です。 要素数、全体のbyte数、addressの条件は互いに別の数量なので、allocation APIへ渡す場合も、正しい役割の値を使います。
Layoutのsizeが求められても、allocatorから同じsizeだけ確保し直せば、既存の値を移動してよいとは限りません。 値の所有権、初期化状態、pinningの契約はlayoutとは独立して残ります。 1.99で追加された所有権移動のAPIとlayout照会のAPIを組み合わせる場合も、分解時の管理情報と、型やmetadataから得るlayout情報を混同しない構成にします。 前者は解放を担当する所有者の状態を表し、後者は確保領域に必要な形を表します。
collectionと文字列の小さな追加
VecDeque::retain_back(len)は、末尾からlen個を残して先頭側を削除します。 既存のtruncate(len)が先頭側を残すのに対し、直近の履歴を残す処理を1回の呼び出しで表現できます。 lenが現在の長さ以上なら変更しません(VecDeque::retain_back)。
use std::collections::VecDeque;

let mut queue = VecDeque::from([10, 20, 30, 40]);
queue.retain_back(2);
println!("tail={queue:?}");
出力はtail=[30, 40]です。 predicateを渡す既存のretainとは異なり、retain_backに渡す値は残す個数です。
末尾の履歴を残す処理と、要素ごとの選別を分ける
truncateは先頭側を残し、retain_backは末尾側を残します。
let mut head = VecDeque::from([10, 20, 30, 40]);
let mut tail = head.clone();
head.truncate(2);
tail.retain_back(2);
assert_eq!(head, VecDeque::from([10, 20]));
assert_eq!(tail, VecDeque::from([30, 40]));
同じ長さ2への短縮でも、保存したい履歴が古い側か新しい側かで呼び出す操作が変わります。 VecDequeを新しい要素を末尾へ追加する履歴として使う場合、retain_backは直近の要素を残す操作に直接対応します。 残す個数を調整するためだけにpredicateへ外部のcounterを持たせる必要がなくなります。
retainは、各要素について残すかを判定する操作です。 たとえば値が条件を満たす要素だけを残す処理と、直近2件を残す処理では、削除する条件が違います。 新APIのlenは条件に合う要素数の上限ではなく、末尾から保存する個数です。 retain_back(0)なら全要素を削除し、現在の長さ以上を指定した場合はすべての要素を残します(retain_backの境界条件)。
末尾を残した後は、論理的なindexも残った要素に対して振り直されます。 tailの操作前のindex 2にある30は、retain_back(2)の後でindex 0になります。 長さ2へ短縮する処理は、元のindexを保ったまま前半を空欄にする処理ではありません。 外部に元のindexを保存するAPIへ組み込む場合、保存したindexが短縮後にも同じ値を指すとは扱えません。
Boxに入った配列を移動しながら反復する
IntoIteratorの追加は、配列を持つBoxを所有した反復と、参照を借りた反復の両方に関係します。 &mut Box<[String; 2]>の反復は各文字列を変更でき、所有したBoxの反復は文字列自体を移動できます(Box<[T; N]>のIntoIterator)。
let mut array = Box::new([String::from("a"), String::from("b")]);
for value in &mut array {
    value.push('!');
}
let moved: Vec<String> = array.into_iter().collect();
assert_eq!(moved, ["a!", "b!"]);
借用した反復なら、元のBoxを後から使えます。 所有した反復なら、元のBoxを消費し、要素の所有権をiteratorへ移します。 要素がCopyでないStringでも、所有権を持つ経路なので値をcloneする必要はありません。 配列をheap上に置いたまま受け渡すAPIで、配列の要素を最後に消費する処理まで同じ型からつなげられます。
反復の途中でiteratorを破棄した場合は、取り出していない要素をiterator側が管理します。 元のBoxを消費した後にも、呼び出し元が元のBoxを別途解放する処理を持つ構成にはしません。 Vec::into_partsとは異なり、利用者がrawな管理情報を受け取るAPIではないためです。 同じ所有権の移動でも、safeなiteratorとして要素を消費する場合と、raw pointerで管理を引き継ぐ場合とで、呼び出し側に残る責任が変わります(IntoIteratorの契約)。
文字列では、Vec<u8>を消費するString::from_utf8_lossy_ownedと、FromUtf8Error::into_utf8_lossyが加わりました。 不正なUTF-8の部分は、replacement characterへ置き換えます。
assert_eq!(String::from_utf8_lossy_owned(vec![65, 255, 66]), "A�B");
所有しているbyte列を受け取るため、有効なUTF-8なら元のallocationを利用できます(String::from_utf8_lossy_owned)。
有効な入力のallocationを引き継ぎ、不正な入力では内容を変換する
借用した&[u8]を受け取るlossy変換の結果は、入力の借用か、新しい文字列になります。 所有したVec<u8>を受け取る新APIでは、入力のallocationを所有したまま変換を進められます。 有効なUTF-8では、入力と結果の先頭pointerが一致します。
let bytes = b"valid".to_vec();
let address = bytes.as_ptr();
let text = String::from_utf8_lossy_owned(bytes);
assert_eq!(address, text.as_ptr());
不正なUTF-8を含む入力では、結果の文字列のbyte数が元の長さと一致しない場合があります。 [65, 255, 66]は3 byteですが、置換後のA�BはUTF-8で5 byteです。 AとBが1 byteずつ、replacement characterが3 byteになるためです。 所有したbufferを受け取るAPIでも、元のcapacityで必ず変換を完了できるとは限りません。
lossy変換では、不正なbyteを文字として保持するのではなく、置換した文字列を作ります。 したがって、結果のStringを再びbyte列へ戻しても、元の255というbyteは復元できません。 from_utf8が返したエラーを記録して元のbyte列を保ちたい経路と、文字列として処理を続ける経路では、保持する情報が変わります。 新APIは後者を所有した入力から直接行うための追加です(FromUtf8Error::into_utf8_lossy)。
String::from_utf8は最初の不正なbyteの位置を返し、errorからlossy変換へ進めます。
let error = String::from_utf8(vec![65, 255, 66]).unwrap_err();
assert_eq!(error.utf8_error().valid_up_to(), 1);
assert_eq!(error.into_utf8_lossy(), "A�B");
エラーからbyte列を取り出し、借用のlossy変換を呼び、さらに所有した文字列へ変換する操作を、エラーを消費する呼び出しへまとめられます。
正常な入力だけを受け付ける契約なら、from_utf8の成功と失敗を区別する意味は残ります。 lossy版へ置き換えると、以前は失敗していた入力を、内容の変わった文字列として受け付ける動作になります。 既存の呼び出しを新しい所有版へ移す場合にも、allocationの扱いだけでなく、不正な入力を拒否するのか置換するのかを維持します。 文字列としての妥当性を回復することと、入力の情報を完全に保つことは異なる結果です。
ほかにも、Box<[T; N]>と参照に対するIntoIterator、StepBy<I>のFusedIterator実装が追加されています。 時刻設定にはfs::set_timesとfs::set_times_nofollowが加わりました。 後者はsymbolic linkの参照先をたどらず、link自体の時刻を変更します(1.99.0のAPI追加)。
Cargoの既定動作と互換性への影響
Cargoにはdebug profileが追加され、現時点ではdevと同じ設定になります。 CI環境ではincremental compilationが既定で無効になりました。 edition 2024では、継承したdefault-features = trueを上書きできます。 member側でdefault-features = falseを指定します。 edition 2024で従来は拒否されていた組み合わせを受け付けるため、workspace側の既定値を残したままmemberだけで無効化できます(Cargoを含む1.99.0の変更履歴)。
workspaceからの継承と、dependency graph全体のfeature解決
default-featuresの継承では、同じdependencyを指すmanifestの設定を採用する優先順位が変わりました。 edition 2024以降では、member側に値があればmember側を使い、なければworkspace側の値を使います。 両方で省略した場合は、通常のdependencyと同じく有効になります。 したがって、workspace側がtrueでも、member側のfalseによって当該dependency経路のdefault featureを外せます。 個別のmemberだけが小さい機能集合を必要とする場合に、workspace全体の既定値を変更せず指定できます(RFC 3945の設定の優先順位)。
depのrichをdefault featureへ含めたworkspaceを考えます。
[features]
default = ["rich"]
rich = []
offはworkspaceから継承しながらdefaultを無効にし、onは継承した既定値を使います。 dep::rich_enabled()はcfg!(feature = "rich")を返し、build時に選択したfeatureをbooleanへ変換します。
cargo run -p off
# => rich=false
cargo run -p on
# => rich=true
同じdependencyのsourceを継承した2個のmemberでも、個別に選択したbuildでは異なるfeature集合になります。
[workspace]
members = ["dep", "off", "on"]
resolver = "3"

[workspace.dependencies]
dep = { path = "dep", default-features = true }
offのmanifestでは、[dependencies]へdep = { workspace = true, default-features = false }を記述しています。 ただし、falseはdependency graph全体からfeatureを禁止する指定ではありません。 offとonを一緒にbuildすると、off側でもrichが有効になります。
cargo build --workspace --target-dir target
./target/debug/off
# => rich=true
onの経路が同じdepのdefault featureを要求し、feature unificationで要求を合わせたためです。 manifestの継承で採用する値と、複数のdependency経路から集まったfeature要求は、異なる段階で処理されます(Cargoのfeature unification)。
default-features = falseを追加しても、別のmemberやdependencyから同じfeatureへの要求があれば有効になります。 たとえばno_std向けmemberが単体ではbuildできても、別のmemberを同時に選択した結果、stdを使うfeatureが加わる構成はあり得ます。 新しい継承規則は、memberがdependencyを宣言する自由を増やしますが、featureを足し合わせるCargoの規則を、featureの減算へ変更してはいません。 不要な機能を確実に含めないbuildでは、実行するcommandが選択するpackage集合まで入力の一部になります。
resolverには、build-dependencyと通常のdependency、対象外のplatformのdependencyなどで、featureを不用意に共有しない規則もあります。 dependencyを分離する条件では、同じversionのcrateが異なるfeature集合で複数回buildされることもあります。 したがって、workspace内に同じcrate名が現れるという理由だけで、すべてのbuild単位のfeatureが同じになるとも限りません。 offとonからの通常のdependencyを同じtargetでbuildすると、depへのfeature要求が合流します(resolver version 2以降の分離条件)。
debug profileという名前と、debug情報の設定
cargo build --profile debugは1.99で組み込みprofileとして受け付けられます。 Cargoのbuild完了表示にも、選択したprofile名が現れます。
cargo build --profile debug
# => Finished `debug` profile [unoptimized + debuginfo] ...
1.99時点のdebugとdevの既定設定は同じです。 新しい名前を選んだだけで、実行時の最適化やdebug情報の量が従来のdevから変わるわけではありません。 Cargo側は、将来devを短い開発反復向けに調整する準備として、debugging向けの名前を分けています(debug profileを追加したPR #17214)。
profile名のdebugと、profile内のdebugという設定は別の対象です。 後者はrustcへ渡すdebug情報の量を制御します。 たとえばline-tables-onlyはbacktraceへfile名や行番号を残す用途を持ちますが、変数やparameterの情報までは含めません。 最適化の程度はopt-levelであり、整数overflowの実行時検査はoverflow-checksです。 profile名を変える操作だけでは、各設定を個別に変更した結果を代替しません(Cargoのdebug情報と最適化設定)。
workspaceのprofile設定は、rootのCargo.tomlから読み込まれます。 dependencyのmanifestへprofileを書いても、利用側workspaceのbuild設定を強制できません。 たとえばlibrary側でdebug情報を省略する設定を持っていても、利用側のrootで選ぶ設定がbuildに適用されます。 新しいdebug profileも、memberごとに分散せず、rootのmanifestへ設定します(profile設定を読むmanifestの範囲)。
CIではincremental compilationの保存先を使う前提が変わる
CIの既定値を変えた理由は、incremental compilationの状態を保存する処理にも時間と容量が必要だからです。 次回のbuildで状態を再利用しないrunnerでは、状態のserializationとdiskへの書き込みが、再利用による短縮へつながりません。 再利用するrunnerでも、増えたcacheを圧縮し、networkで転送する処理が追加されます。 Cargoの変更は、CIでの再利用率が低い場合にまで、incremental compilationを既定で有効にする構成をやめたものです(CIの既定値を変更したPR #17220)。
CIの判定にはCI環境変数を使います。 設定の優先順位では、CARGO_INCREMENTALとbuild.incrementalがCIの判定より上にあります。 したがって、継続して同じbuild状態を使う専用runnerなら、明示した設定で有効にする経路は残ります。 逆に、profileの既定値だけへ依存していたCIでは、1.99への更新によってincremental用の状態を生成しなくなる場合があります。 変更の対象はcompilerの中間状態であり、Cargo.lockを無視したり、dependencyのversion解決を変更したりする機能ではありません。
同じCIであっても、incrementalの保存量が減ったことと、build全体が速くなったことは同じ測定ではありません。 Cargoが変更したのは、再利用の見込みが不明な環境で選ぶ既定値です。 既存のCI設定でCARGO_INCREMENTAL=0を指定していた場合は、既定値の変更前から無効だったので挙動は変わりません。
compiler側では、generic itemへのno_mangleがhard errorになり、std::i32::MAXのような旧形式の整数定数はdeprecatedになりました。 整数定数にはi32::MAXのように型に属する定数を使えます。 transmute_copyは?Sizedに対応し、失敗時のpanicはunwindしなくなっています(1.99.0の互換性に関する変更)。
Pin::new_uncheckedでは、pointerに実装するsafe traitも安全性の条件に関わります。 DerefやDerefMutは常に同じobjectを指し、pointerの破棄時にも中身を移動させない必要があります。 Cloneによる複製先も、Pinとして安全に扱えるpointerでなければなりません(安全性の条件を変更したPR #156935)。
使い切ったRangeInclusiveのstartとendは、特定の値になる保証がありません。 反復終了後の境界値を読み、終了前の範囲や最後の値を復元する前提にはできません(標準libraryの変更)。
Pinの保証をpointer側のsafeな操作でも壊さない
Pin<P>は、pointer型Pの操作がpointeeを移動させないという条件にも依存します。 Pin::new_uncheckedを呼ぶ時点で、単にpointerが有効なallocationを指していれば済むわけではありません。 PのDerefが呼ぶたびに異なるobjectを返す実装なら、固定したつもりのobjectと、後で参照するobjectが一致しなくなります。 DerefMutやDropがpointeeを移動させる実装も、固定した位置へ依存する値の前提を壊します(Pin::new_uncheckedのSafety)。
Cloneの条件は、複製したpointerを再びPinとして使う場面に関わります。 複製先が、元のpointeeを移動するような所有者へ変わる実装であれば、複製する操作はsafeでも、構築したPinの保証は維持できません。 1.99の修正では、safe traitの実装もPinを成立させる契約の一部である点を明確にしました。 標準のpointerと独自のpointerを同一視せず、Pinを作るunsafeな境界で、後から呼べる操作まで保証に含めます(契約を整理したPR #156935)。
Pinは、pointeeの中の任意のfieldをすべて自動的に固定する構文でもありません。 固定の保証を引き継ぐstruct fieldの範囲は、projectionを公開する側の設計に依存します。 今回のpointerに関する条件を満たしても、別のunsafeなprojectionでfieldを移動させれば、field側の保証は壊れます。 反対に、Unpinな値は移動を禁止する必要がないため、すべてのPin利用に同じ制約を追加する説明も正確ではありません(Pinのstructural pinning)。
使用済みの範囲と、宣言した上限を同じ状態へ保存しない
RangeInclusiveは、両端を保持する値であると同時に、反復すると内部状態が進むiteratorです。 たとえば上限へ到達した後の値からstart()を読んで、最初に指定した下限を復元する使い方は、もともとの入力を別に保持する実装とは異なります。 反復の途中では残っている範囲を表し、反復後は使い切った状態になります。 1.99では反復処理を最適化した結果、使い切った後の境界値が以前と異なる場合があります(RangeInclusiveの終了後の状態)。
is_empty()とiteratorとしての終了状態を扱うこと、使い切った後の特定の境界値を期待することは別の契約です。 最初の下限や上限を後で記録する処理なら、反復前に元の値を保存した実装は、終了後の内部表現に依存しません。 sliceのindexとして使い切った範囲を再利用していた処理では、反復前の範囲と同じ対象を指すと仮定できなくなります。 最適化で変更されたのは、保証のなかった終了後の境界値です。 a..=bの範囲が上限を含む規則は変わりません。
pathから時刻を設定し、symbolic linkの追跡を選ぶ
File::set_timesは、すでに開いているfileへ時刻を設定するAPIです。 1.99で加わったfs::set_timesはpathを受け取り、対象のfileやdirectoryへ時刻を設定します。 fs::set_times_nofollowは、pathの最後がsymbolic linkなら、参照先ではなくlink自身へ適用します。 たとえばarchiveからlinkを復元する処理では、参照先の更新時刻を変えず、linkの時刻を復元する操作を選べます(set_times、set_times_nofollow)。
時刻の指定にはFileTimesを使います。 FileTimes::new()では変更する時刻が指定されておらず、set_modifiedだけを呼べば更新時刻を選んだ値にします。 最終アクセス時刻まで同じ値にしたい場合は、set_accessedも明示して組み立てます。 更新時刻を設定するためにfileの内容を書き直す操作ではないので、内容のbyte列と、変更するmetadataを別に扱えます(FileTimesの各fieldの指定)。
darwin/aarch64では、同じsymbolic linkのpathから、参照先とlink自身の更新時刻を別々に設定できます。 参照先の時刻はmetadata、link自身の時刻はsymlink_metadataで取得します。
use std::fs::{self, FileTimes};
use std::time::{Duration, UNIX_EPOCH};

fn main() -> std::io::Result<()> {
    let root = std::env::temp_dir().join(format!("rust199-times-{}", std::process::id()));
    fs::create_dir(&root)?;
    let target = root.join("target");
    let link = root.join("link");
    fs::write(&target, b"content")?;
    std::os::unix::fs::symlink(&target, &link)?;
    let first = UNIX_EPOCH + Duration::from_secs(86_400);
    let second = UNIX_EPOCH + Duration::from_secs(172_800);
    fs::set_times(&link, FileTimes::new().set_modified(first))?;
    fs::set_times_nofollow(&link, FileTimes::new().set_modified(second))?;
    assert_eq!(fs::metadata(&target)?.modified()?, first);
    assert_eq!(fs::symlink_metadata(&link)?.modified()?, second);
    assert_eq!(fs::read_to_string(&target)?, "content");
    fs::remove_file(link)?;
    fs::remove_file(target)?;
    fs::remove_dir(root)
}
新しいAPIは、pathへ指定した対象に対してOSの時刻設定機能を呼び出します。 UnixではAT_SYMLINK_NOFOLLOWを指定したutimensat、AppleではFSOPT_NOFOLLOWを指定したsetattrlistに対応します。 Windowsでの現在の実装はSetFileTimeに対応します。 権限が足りない場合やOSで操作を支えていない場合にはerrorを返します。 時刻設定を無視して成功するAPIではありません(set_times_nofollowのplatform別の動作とerror)。
時刻の解像度はfile systemに依存するため、任意の細かい値を指定すれば必ず同じ精度で保存されるとまでは言えません。 比較するtimestampは秒単位で、file systemが保持する精度を越える小数部は含みません。 APIのlink追跡の有無と、保存できる時刻の精度は別の条件です。 開いたhandleが表すobjectへ設定する処理と、pathを再解決して設定する処理では、対象を確定する時点が異なります。 解決するまでにpathの指す対象が変われば、設定先のobjectも変わり得ます。
compilerの診断で変更になる入力
no_mangleは、外部から参照するsymbol名をRustの通常のmanglingから外す属性です。 generic functionは、具体的な型やconst argumentごとに実装を生成するため、複数の実装へ同じ固定symbol名を与える契約とは合いません。 1.99では、generic itemへのno_mangleがwarningからhard errorになりました。 identity<T>は具体化した型ごとにsymbol名を分ける必要があるため、#[unsafe(no_mangle)]自体をerrorにします。 診断は、型またはconstのgeneric functionにmanglingを要求します。
#[unsafe(no_mangle)]
pub fn identity<T>(value: T) -> T { value }
// error: functions generic over types or consts must be mangled
呼び出しをidentity(1_u32)の1個に限っても、generic itemへ付けた属性は許可されません(hard error化したPR #154585)。
FFIへ公開するentry pointが固定された型を受けるなら、genericな内部実装と、具体的な型を持つ外部向けfunctionを分けられます。 属性を削除するだけで外部の呼び出し元が同じsymbolを発見できるようになるわけではありません。 外部向けの名前が必要な場所を、具体的なABIを持つfunctionへ限定する変更になります。 外部へ公開する実装を型と名前で確定させ、genericな内部実装を呼び出すwrapperを分けます。
unconditional_panicの診断対象には、sizeが0だと必ずpanicするchunksやwindowsの呼び出しも加わりました。 sliceを空にする操作と、chunkの大きさを0にする操作は異なります。 空のsliceをsize 1で分割する呼び出しなら、単に要素がない結果ですが、size 0は分割方法として許可されません。 1.99では、明らかにsizeが0になる呼び出しを、panicへ到達する前に診断できる範囲が広がっています(unconditional_panicを拡張したPR #153563)。
旧形式の整数moduleのdeprecated化は、定数の数値を変える変更ではありません。 std::i32::MAXという経路から、整数型自身のassociated constantであるi32::MAXへ移します。 型のassociated constantを選ぶことで、旧moduleをimportして定数を参照する形を減らせます。 deny(warnings)を設定するbuildでは、deprecatedの診断でbuildが失敗します。 数値の変更を伴わなくても、参照経路を修正する必要があります(std::i32のdeprecated属性)。
1.99.1で修正されたABIと配布物
1.99.1では、x86_64でCへboolを返す際のzero extensionが復旧しました。 1.99.0では戻り値のbit 1からbit 7が未規定になり、CのABIが求める値の表現を満たしていませんでした。 FFIの戻り値の表現に関わり、Rustの型検査では取り除けないregressionでした(1.99.1のbool ABI修正)。
残る2件は、LLVMのloop idiom認識で必要になったwcslenのfallbackと、macOS配布物のrust-lldです。 wcslenの欠落はUEFI向けのstdなどに影響していました。 macOSでは、rust-lldの直接起動時にlibLLVMを発見できない場合がありました。 rustup proxyを経由しない起動を修正するため、rpathが追加されています(1.99.1の修正内容)。
boolのregressionでは、Rust側のtrueとfalseの意味を変更したのではなく、返り値をABI上のbit列へ変換する処理が欠けていました。 x86_64の当該規約では、少なくとも低位8 bitのうちbit 1からbit 7を0にする必要があります。 bit 0だけが論理値に合っていても、呼び出し元が低位8 bitを返り値として使えば、期待する0または1と一致しない値になります。 Rustのfunction本文が正しくても、呼び出し境界の命令がABIを満たさなければ、外部のcodeへ不正な値を返します(ABI不一致を報告したissue #163911)。
wcslenの欠落では、元のRustコードがwcslenを直接呼んでいなくてもlink errorになり得ました。 LLVMが文字列の長さを数えるloopを認識し、library functionへの呼び出しへ置き換えるためです。 UEFIの報告では、release buildのlink時にundefined symbol: wcslenが現れています。 compilerが生成した呼び出しを受けるfallbackをtarget側に用意する必要があります。 fallbackの欠落は、型検査やobject fileの生成後、link段階の失敗として現れます(UEFIでのlink errorを報告したissue #163614)。
macOSのrust-lldは、tool自身が必要とするlibLLVMの探索経路に問題がありました。 rustup proxyを経由した起動では環境によってlibraryを発見できても、toolchain内のcompilerを直接起動すると探索に失敗する場合がありました。 修正版は配布するtoolのrpathを補い、rust-lldが自身の依存libraryを見つける経路を持たせています。 アプリケーション自身がlinkするlibraryを追加する修正とは異なり、linkerを起動するまでの配布物の依存関係に関わる修正です(macOS配布物を修正したPR #163954)。