Lean 4.35詳解——vcgen、kernelによる再検査、機械整数を扱うgrind
Lean 4.35のvcgen、lake check、grindのhomomorphism、Boolに基づくDecidable、libraryとcompilerの変更を、成功例と失敗例で解説します。
Lean 4.35.0は2026年10月12日に公開されました。 2026年10月24日時点では、次の系列の4.36.0-rc1も10月14日に公開されていますが、以下は4.35.0の変更を扱います。 状態を更新するprogramの検証にはvcgen、projectの証明を再検査する入口にはlake checkとlake comparatorが加わりました(4.35.0の変更履歴、公開版の一覧)。
grindは、UInt8やBitVecなどの演算を、NatやIntの演算へ写して扱う範囲を広げています。 Decidableの定義は、true側かfalse側の証明を持つinductive typeから、Boolと対応する証明を持つstructureへ変わりました。 コード例の対象はLean 4.35.0、Linux/x86_64です。
vcgenで、状態を更新するprogramの条件を証明する
vcgenは、programを含む証明目標を、成立に十分なverification conditionへ分解します。 たとえば現在の状態を読み、1を加えて保存し、変更前の値を返すprogramを考えます。 入力状態がnなら、返り値はn、終了状態はn + 1である、という条件を表せます。 状態を保存した結果だけでなく、返り値と終了状態の関係を同時に検証します(vcgenの仕様)。
import Std
import Std.WP
import Std.Tactic.Do

open Std.WP Lean.Order

set_option experimental.vcgen true

def bump : StateM Nat Nat := do
  let previous ← get
  set (previous + 1)
  return previous

theorem bump_spec (n : Nat) :
    ⦃fun s => ⌜s = n⌝⦄ bump
    ⦃fun result s => ⌜result = n ∧ s = n + 1⌝⦄ := by
  vcgen [bump] with finish
StateM Nat Natの最初のNatは状態、最後のNatは返り値の型です。 getは現在の状態を読み、setは新しい状態を保存します。 返すのは更新後の状態ではなく、previousへ保存した更新前の値です。 postconditionのresult = nとs = n + 1は、異なる2個の値へ条件を付けています。
⦃P⦄ program ⦃Q⦄は、preconditionとpostconditionでprogramを囲むHoare tripleです。 bump_specのpreconditionは、実行前の状態sが任意の自然数nに等しいという条件です。 postconditionは、返り値と実行後の状態を受け取ります。 nへ具体的な7や100を代入する有限の実行例だけではなく、宣言で量化したnを対象に証明しています。
vcgen [bump]は、bumpの定義を展開して、get、set、returnの仕様へ分けます。 with finishは、分解後に残る自然数の等式や連言を証明します。 依存するaxiomは、theoremの名前を指定して取得できます。
#print axioms bump_spec
-- => 'bump_spec' depends on axioms: [propext, Classical.choice, Quot.sound]
値を実行する代わりに、条件を後ろから変換する
programの通常の実行は、入力状態を出力状態へ変えます。 weakest preconditionの解釈は、実行後に必要な条件から、実行前に十分な条件を求めます。 たとえばset (previous + 1)の後で状態がn + 1なら、保存する式previous + 1がn + 1になる条件へ戻せます。 先行するgetの仕様と組み合わせれば、元の状態がnというpreconditionへ接続します(predicate transformerの定義)。
return previousの段階では、postconditionの返り値へpreviousを代入します。 返り値の条件はprevious = nです。 保存する状態への条件と、更新前に読んだ値への条件を合わせれば、両方の結論を導けます。 programを1個の不透明な呼び出しとして残すのではなく、operationごとの仕様を通じて証明目標へ移します。
verification conditionは、最終的に通常のLeanの証明目標です。 vcgenがprogramを分解しただけで、任意の条件を自動で真にするわけではありません。 たとえば保存する値がprevious + 1なのに、終了状態をn + 2と宣言すれば、残る算術条件は成立しません。 分解する仕組みと、得た条件を証明するsolverを、withの構文で接続しています。
monad以外のprogramにも解釈を与えられる
4.35のvcgenは、従来のmvcgenより、扱うprogramの型を一般化しています。 Std.WPのWP instanceでweakest preconditionの解釈を持てば、monadだけに限定されません。 独自の命令を表すinductive typeや、assembler、WebAssemblyのようなdeep embeddingも、解釈を定義する対象になります。 命令列を表すdataに対し、操作的な意味から条件を変換する規則を与える構成です(4.35のvcgenの採用範囲)。
同じ文字列をassemblerとして読んだだけで、任意のmachine上の実行まで検証できる意味ではありません。 WP instanceが解釈するprogramの型と、命令の意味が、対象となる実装を決めます。 具体的な命令をmodelへ対応させたうえで、preconditionからpostconditionへの含意を証明します。 bumpのmodelは自然数の状態とget、setで構成し、外部のfile systemやnetworkを含めません。
assertionの型も、常に単純な状態からPropへのfunctionに限りません。 Std.WPはcomplete latticeを基礎にし、含意、連言、選択などをlatticeのoperationとして扱います。 確率的なlogicやseparation logicのようなassertionへ、programの解釈を接続できる範囲を持ちます。 具体的なsolverが扱うassertionの性質と、programを分解する共通の仕組みを分ける一般化です。
⌜P⌝は、通常のPropをassertion側へ埋め込む記法です。 bump_specでは、状態からPropへのpredicateを使い、通常の等式をassertionとして記述しています。 assertionの型が抽象的な場合も、純粋な命題を同じ形式で扱えます。 precondition中の純粋な条件は、verification conditionを解く側の仮定へ移して使えます。
loopのinvariantと、終了するためのmeasureをsourceへ書く
4.35では、whileやrepeatへinvariantとtermination measureを付ける構文が加わっています。 invariantはloopの開始時と反復後に維持する条件です。 measureは、継続する反復ごとに小さくなる値を指定します。 状態の関係を保つ証明と、反復が終わる根拠を、別のannotationへ表します(loopの契約に関するPR #14703)。
set_option experimental.intrinsic true

def countDown (n : Nat) : Id Nat
    ensures result => result = 0 := do
  erased initial := n
  let mut i := n
  while i > 0
      invariant exit => i ≤ initial ∧ (if exit then i = 0 else True)
      decreasing i
      do
    i := i - 1
  return i
countDownは、公式例に検証用の初期値と上限の条件を加えた形です。 入力7に対する返り値は、#evalで表示できます。
#eval countDown 7 -- => 0
ensuresは返り値が0である条件です。 loopの終了時にi = 0が成立し、最後にiを返す処理と接続しています。
decreasing iは、単にiが0以上という条件ではありません。 loopを継続する場合に、次の反復でmeasureが減る根拠を要求します。 i > 0のbranchでi - 1へ更新するため、自然数の切り捨て減算でも、measureを減らせます。 0で同じ減算を繰り返す場合とは、loopを継続する条件が異なります。
invariantのexitは、loopの終了側か、継続側かを区別するbooleanです。 終了側ではi = 0を要求し、継続側では当該部分をTrueとしています。 上限のi ≤ initialは、両方へ共通する条件です。 4.35のWhileInvariantは、exit flagとloop stateを引数に取る専用の型です。 従来の直和を使う表現を置き換えています(WhileInvariantのPR #14845)。
erasedの変数は、実行する状態を増やさず検証へ残す
erased initial := nは、検証に使う初期値を記憶しています。 反復後のiだけでは、元の入力との関係を比較できないため、invariantが参照する名前を残しています。 4.35のerased stateは、検証上は値を持ち、compileしたcodeでは実際の値の代わりにdummyを保持します。 履歴や初期値を記述するために、実行時のprogramへ同じdataを保存し続ける構成を要求しません(erased stateのPR #15090)。
構文には、通常の束縛、変更可能な束縛、actionから得る値の形があります。 erased x := e、erased mut x := e、erased x ← actです。 invariantやassertionは検証上の値を参照できます。 消去した変数の値を、実行用の返り値へ自由に持ち出せる構文ではありません。
requires、ensures、assert、loopのinvariantやdecreasingは、intrinsicな検証構文としてexperimentalです。 countDownには、experimental.intrinsicとexperimental.vcgenが必要です。
呼び出し先が変更しない状態をframeとして保持する
呼び出すfunctionの仕様が、状態の一部だけを記述する場合があります。 たとえば状態が自然数のpairで、functionが先頭の値を返して1増やす仕様なら、末尾の値への条件はpostconditionへ現れない場合があります。 呼び出し元が末尾は7と知っていても、仕様の適用後に同じ情報を自動で保持できるとは限りません。 vcgen framesは、呼び出しの前後で保持するassertionを指定する入口です。
frameに末尾が7という条件を指定すると、vcgenは条件を維持する証明も要求します。 呼び出すfunctionが実際に末尾を書き換える場合まで、指定だけで元の値を保ったと扱いません。 仕様が触れる部分と、保持したい状態の部分を、両方の条件へ接続します。 complete lattice上の一般化したframe preservationが、変更しないassertionを呼び出し越しへ運ぶ根拠になります(frameの構文と条件)。
mvcgenとmvcgen?はdeprecatedになり、vcgenへの移行対象です。 ただしvcgen invariants?によるinvariantの自動提案は、移植されていません。 4.35は提案機能が利用できないwarningを出し、keywordの削除も予定しています。 古いtactic名だけを置き換えた場合でも、利用していた補助機能まで同じ実装へ移るとは限りません(移行とinvariant提案のPR #14870)。
lake checkは、生成した証明を別processのkernelへ渡す
Leanのtacticは、証明に相当するtermを作ります。 kernelは、termが宣言した型を持つかを検査します。 4.35のlake checkは、projectの既定targetをbuildし、結果をexportし、別processでkernelへ通す入口です。 同時に、使用するaxiomが許可された集合に含まれるかを検査します(lake checkのPR #14990)。
既定で許可する名前は、propext、Classical.choice、Quot.soundです。 当該3名以外のaxiomへ依存する宣言は、既定の判定では拒否します。
検査対象のprojectも、判定を返すprocessへ直接読み込むdataとは扱いません。 Lakeの設定はcodeとして評価でき、buildやelaborationでも処理を実行できるためです。 4.35は、projectの設定評価、build、exportをbubblewrapのsandbox内へ置きます。 判定を報告するprocessには、projectが作った.oleanを直接loadしない構成です(4.35.0のCheck.lean)。
sandboxは、利用者のhome directoryを隠し、書き込み先を限定します。 dependency解決の段階だけnetworkを許可し、証明のexportとkernelの実行は別の権限で扱います。 build中に外部へ接続できた事実から、検査対象のcodeがkernelの実行環境まで同じ権限で変更できる構成にはしません。 動作にはLinux namespaceが必要で、4.35の当該sandboxはLinuxを対象にしています。
--paranoidで、同梱の複数kernelへ通す
4.35の配布toolchainには、追加のcheckerが同梱されています。 leanchecker-paranoid、lean4lean、nanoda、con-leche、con-ronです。 lake check --paranoidは、通常のLean kernelに加え、同梱したcheckerを実行します。 1個だけ受け付けた結果を採用するのではなく、選んだcheckerがすべて受け付ける条件です(paranoidな検査のPR #15145)。
leanchecker-paranoidは、memory allocatorを強化したLeanのcheckerです。 ほかのcheckerには、kernelの実装が異なるものも含まれます。 同じ証明termを別の型検査実装へ渡し、単一の実装だけに存在する不具合を検出する構成です。 すべてのcheckerが同じruntimeを使わないことと、すべてのcheckerに共有するdependencyが一切ないことは、同一の保証ではありません。
たとえば4.35のreference countの修正では、Lean runtimeを使う経路と、使わないcheckerの影響範囲が分かれています。 kernelの論理規則が異なるかという観点に加え、runtimeやallocatorを共有するかも、不具合の対象を決める条件になります。 追加checkerを同梱する変更は、実装の異なる検査を利用者が個別installして接続する作業を減らします。 必要な検査対象とcheckerを、同じtoolchainの版へ固定して扱えます。
export済みのfileを再検査する
lake check --from-exportは、既存のNDJSON exportを受け取ります。 別machineやvirtual machineで作った証明を、再buildせずに検査する入口です。 exportを作ったsourceとtoolchainの対応は、生成したartifactへ結び付けて保持する情報になります(既存exportを受け取るPR #15157)。
leanchecker自身にも、--from-export file.ndjsonが加わりました。 状態を更新するbump_spec、machine integerの境界を扱う証明、modular power、booleanの等式など、8宣言をexportするcommandは次の形です。 ReleaseExamplesは、8宣言をまとめたmodule名です。
lake env /opt/lean/bin/leanexport ReleaseExamples -- \
  boundedIncrement boundedDouble modularPower decisionAnd decisionOr \
  bump_spec rewritten explicitConstructor > proofs.ndjson
/opt/lean/bin/leanchecker --from-export proofs.ndjson
# => Lean default kernel accepts the solution
/opt/lean/bin/lean4lean --import proofs.ndjson
# => checked 2222 declarations
/opt/leanは4.35.0を展開したtoolchainのpathです。 lean4leanの2222宣言には、指定した8宣言から参照する定義やtheoremも含まれます。 独立したcheckerによる再検査は、同じexportへ別の型検査実装を適用する処理です。
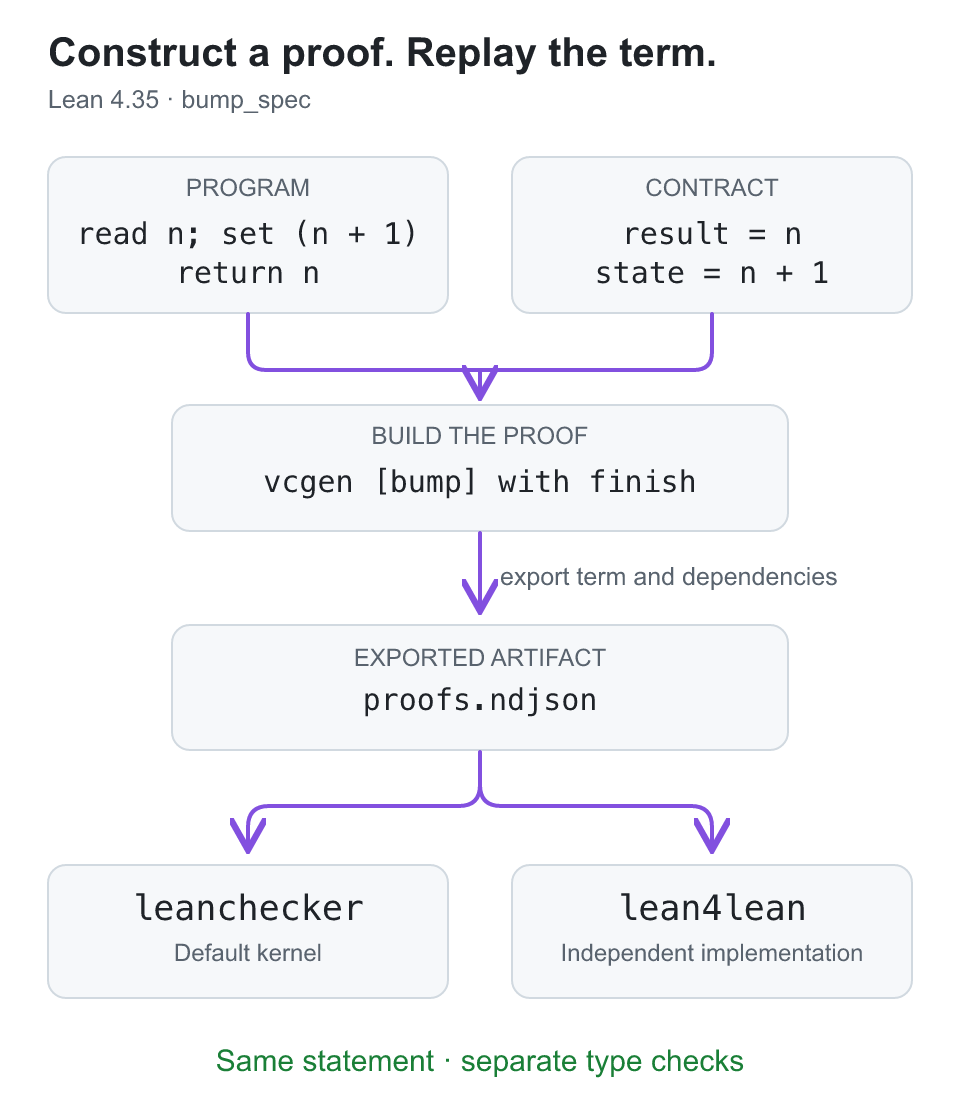
exportの先頭には、formatのversion、exporterのversion、Leanのversionとcommitが記録されます。 Lean 4.35.0に対応するexportのcommitは、eb6cafb7290e8bd5f2937522d8d804f58f02bafcです。 4.35のLakeも、exporterをtoolchainに同梱したものへ固定し、.oleanを作ったcompilerとの対応を維持します。
lake comparatorは、証明した命題も比較する
lake checkは、projectのtheoremがkernelで受け付けられるかを検査します。 lake comparatorは、challengeの命題とsolutionのtheoremを対応させ、同じstatementを証明しているかも比較します。 solutionにある簡単な別の命題の証明を、challengeへ回答した証明として採用する条件を除きます。 設定には、challenge module、solution module、対象のtheorem名、許可するaxiomを指定します(lake comparatorのPR #14885)。
たとえば要求したstatementが、任意の自然数nについてn ≤ n + 1だとします。 solutionの命題をn = nへ置き換えれば、正しい証明termでも、要求されたstatementとは一致しません。 comparatorは、指定したtheoremのstatementと、必要な定義の対応を検査します。 証明探索が終了した結果と、依頼した命題に合う結果を、異なる判定として扱うcommandです。
--challenge-from-exportと--solution-from-exportは、両側へ既存のexportを渡す入口です。 sourceのmoduleをbuildする場合と、すでに生成した証明dataを比較する場合で、入力artifactが異なります。 既定の設定fileはcomparator.jsonです。 --paranoidを使う場合には、solutionの証明へ追加のcheckerも適用します。
grindは、machine integerを自然数や整数へ写す
UInt8の足し算は、無制限の自然数の足し算とは異なります。 255へ1を加えると8 bitの範囲を越え、結果は0です。 4.35のgrindは、UInt8、BitVec、Finなどの演算を、専用solverが扱うNatやIntの式へ写す仕組みを強化しました。 overflowと値の範囲を、変換する規則の中へ含めます(homomorphismのPR #14727)。
theorem boundedIncrement (x : UInt8) (h : x.toNat < 100) :
    (x + 1).toNat = x.toNat + 1 := by
  grind
boundedIncrementの仮定は、UInt8の値を100未満へ制限します。 値を1増やしても256へ達しないため、UInt8側の加算結果を自然数へ移した値は、自然数側で1を加えた結果と一致します。 仮定の範囲と、machine側の演算の意味が、自然数側の等式を成立させています。
範囲の仮定を捨てると、255が反例になる
値を255へ固定すると、同じ形の等式は成立しません。 左辺はUInt8で1を加えてから自然数へ移すので0です。 右辺は先に自然数へ移して1を加えるため256です。
example : ((255 : UInt8) + 1).toNat = (255 : UInt8).toNat + 1 := by
  decide
-- error: Tactic `decide` proved that the proposition is false
machine integerを自然数へ写せることは、すべての演算を無条件で通常の整数演算へ置き換える許可ではありません。 加算や乗算には、modulusや値域に対応する条件が伴います。 boundedIncrementでは、入力の上限によってwraparoundを避けます。 単にcastの記法を消し、元の型が持つ有限幅を忘れた式を証明しているわけではありません。
BitVec 8でも、値を10未満へ制限すれば、2倍した結果が20未満であると証明できます。
theorem boundedDouble (x : BitVec 8) (h : x.toNat < 10) :
    (x * 2).toNat < 20 := by
  grind
値を2倍しても8 bitの範囲内へ収まるため、自然数側の上限を使えます。 同じ8 bitでも、型が持つbit operationと、自然数として得る値の範囲を、対応する変換規則へ分けて扱います。 solverへ手作業でtoNatの補題を何段も追加する処理を、新しいhomomorphismの仕組みがまとめます。
[grind hom]と[grind hom_pred]
[grind hom]を付けたtheoremは、source側の型のtermを、target側の型のtermへ変換する規則です。 [grind hom_pred]は、埋め込む値が持つ範囲の情報を供給します。 たとえばFin nから自然数へ写す値には、n未満という上限も伴います。 演算の変換と、型が保証する値域を、異なる属性のtheoremから得ます。
変換は、E-graphへinternalizeする前にfixpointまで適用します。 途中の表現をすべて同じgraphへ加える代わりに、正規化後の形を使います。 以前のLean.Grind.ToIntのtype classを中心とする構成では、同じ値の別の綴りとbridgeの等式が、ほかのsolverへ余計な情報として現れていました。 4.35では、当該type classの階層を削除し、変換規則と値域の情報へ整理しています。
当該変更に伴い、以前の変換と重複するBitVecやUIntNのE-matching lemmaも、既定の規則集合から外れています。 独自のmetaprogramが古いtype classや既定lemmaを前提にしている場合、単に同じtheorem名で探索する構成は移行対象です。 通常のgrindではhomomorphismの変換が既定で有効です。 trace.grind.homとtrace.grind.hom.predは、適用した変換と値域情報を追うためのtrace classです。
Decidableの判定値が、定義の簡約だけでBoolへつながる
Decidable pは、命題pが成立する側か、成立しない側の証拠を持ちます。 4.35より前は、isTrueとisFalseのconstructorを持つinductive typeでした。 4.35はBoolと、booleanの値に対応するpまたは¬pの証明を保持するstructureへ変えています。 真偽を計算する値と、命題が成立する根拠の対応を、構造の定義へ含めます(Decidableを変更するPR #8309)。
変更は、同じ結論を異なるtheoremで証明できるという差だけではありません。 decideで命題をbooleanへ変換した式が、通常のboolean演算と定義上等しくなる範囲を増やします。 たとえば2個のbooleanが両方trueである命題は、booleanの&&へ簡約できます。 補助lemmaを適用する代わりに、rflだけで等式を証明できます。
theorem decisionAnd (a b : Bool) :
    decide (a = true ∧ b = true) = (a && b) := rfl

theorem decisionOr (a b : Bool) :
    decide (a = true ∨ b = true) = (a || b) := rfl
左辺はPropの連言や選言を判定する式で、右辺はBoolの演算です。 同じ真理値になると外から証明するだけなら、両辺の内部の定義が一致する必要はありません。 rflが使える条件はより強く、定義を展開・簡約した値が一致します。 4.35の変更は、命題の判定とbooleanの計算を結ぶ際に、書き換えの証明を追加する必要を減らします。
LawfulBEqから提供するDecidableEqでも、decide (a = b)とa == bが定義上対応します。 booleanの等価比較と、命題としての等式を判定する実装を、同じ計算へ接続します。 ただし任意の独自BEqの返り値を、命題としての等式の証拠へ無条件に変える規則ではありません。 対応の根拠になるLawfulBEqの契約と、使用するinstanceが条件です。
独自のDecidable instanceでは、decidable_of_boolやdecidable_of_iffが新しい表現へ対応する構築用の入口です。 Decidable.isTrueとDecidable.isFalseはmatch_patternとして残り、従来のpattern matchingを継続できる範囲を持ちます。 しかし実体がinductive typeであるという前提へ依存したmetaprogramまで、同じ内部構造を維持しません。 constructorを直接解析する実装と、公開するpatternの形を使うsourceでは、変更を受ける境界が異なります。
新しいdecide tacticは、booleanを計算する間に証明まで運ぶ必要を減らします。 compiler側のDecidable専用の特別扱いも不要になりました。 一方、連言と選言の判定にはshort-circuitの評価順を保つ必要があります。 4.35は対応するinstanceへmacro_inlineを付けています。 booleanへ寄せた表現でも、不要な側を評価しないcompile結果を保ちます(short-circuitを保つPR #15430)。
rwaは、書き換えた仮定でmain goalを閉じる
4.35のrwa [rules]は、最初のgoalを書き換えた後、assumptionで同じgoalを閉じます。 rwa [rules] at hでは、仮定hの型を書き換え、書き換え後のhでmain goalを閉じます。 以前のように、後段のassumptionが関係のないgoalや別の仮定へ偶然一致する処理とは異なります。 書き換える場所と、結論を成立させる証拠の対応を限定しました(rwaの動作を変更するPR #14937)。
theorem rewritten (n m : Nat) (h : n + 0 = m) : n = m := by
  rwa [Nat.add_zero] at h
hを書き換えるとn = mになり、main goalの型と一致します。 一方、書き換えた仮定がn = nにしかならなければ、n = 0の証明としては使えません。 すでに別の仮定hp : n = 0が存在していても、at hqを指定したrwaはhpへ切り替えません。 指定した仮定を使う経路が成立していない事実を、型の不一致として報告します。
example (n : Nat) (hp : n = 0) (hq : n + 0 = n) : n = 0 := by
  rwa [Nat.add_zero] at hq
Type mismatch: The rewritten hypothesis hq has type
  n = n
but is expected to have type
  n = 0
書き換えの途中でside goalを生成した場合は、side goalにもassumptionを適用します。 閉じられない条件は残し、最初から存在した無関係な別のgoalには作用しません。 複数のgoalがある証明で、たまたま仮定と一致した別のgoalだけを消す動作を避けます。 移行後にerrorとなる証明では、main goalとatへ渡した仮定の型を対応付ける必要があります。
書き換えだけでreflexivityによってmain goalが閉じ、side goalもない場合は、rwaが不要なwarningを出します。 当該箇所はrwへ短くできます。 複数の場所を指定するrwa [rules] at h₁ h₂はdeprecatedになり、rw [rules] at h₁ h₂ <;> assumptionへ分けます。 複数の仮定のうち1個を暗黙に採用する操作から、書き換えと終了処理を明示する操作への移行です。
constructorの選択と、theoremの再記述を明示する
constructorは、適用可能なconstructorが複数あるとwarningを出すようになりました。 たとえば2 ≤ 3 ∨ 3 ≤ 2では、選言を作る入口のOr.inlとOr.inrの両方を、goalの外形へ適用できます。 左側の命題が成立するかは、constructorの適用後に残る証明です。 goalの外形へ合う入口が1個である条件とは異なります(constructorのwarningを追加するPR #14854)。
theorem explicitConstructor : 2 ≤ 3 ∨ 3 ≤ 2 := by
  left
  decide
leftならOr.inlを選び、残る2 ≤ 3をdecideで証明します。 以前の「最初に合ったconstructorを使う」動作を明示する入口はconstructor!です。 証明するbranchが分かっている場合は、leftやrightでbranchを指定できます。 warningの条件はconstructorの候補の数であり、元の命題がfalseであるという診断ではありません。
recallも、追加のimportなしで使えます。 既存のtheoremを、指定した名前とstatementで再記述できるか検査するcommandです。 たとえば自然数の加算の可換性は、次の形で再記述できます(recallのPR #14899)。
recall Nat.add_comm (n m : Nat) : n + m = m + n
右辺を誤ってn + mへ変えた再記述は、簡単に証明できる反射的な等式でも拒否します。 recallが求めるのは、書いた命題が単独で真であることではなく、指定した既存theoremとの型の対応です。 命題の内容を省略したrecall?には、検査に基づく再記述を提案する入口があります。 theoremの名前を覚えたままstatementだけを取り違える場合も、宣言の型で不一致を捉えます。
recursorの表示にも、定義上の計算規則が加わっています。 #print Nat.recなどで、zeroとsuccessorに対する簡約を対応付けられます。 recursorの引数の型だけでなく、constructorへ適用した際の計算も表示するため、生成された証明termを読む際の参照先が増えます(recursorの表示を変更するPR #14960)。
大きいmodular powerを、結果の大きさへ抑えて計算する
Nat.powMod b e mは、bのe乗をmで割った余りを求める追加APIです。 先に巨大な自然数の累乗を作ってから余りを計算する代わりに、square-and-multiplyの各段階で余りへ戻します。 指数を2進の桁へ分け、二乗と必要な乗算を重ねるため、指数の値だけ乗算を繰り返す定義にもなりません。 compiled codeでは、GMPを使う構成へ対応する実装もあります(Nat.powModのPR #13490)。
#eval Nat.powMod 2 1000000006 1000000007 -- => 1

theorem modularPower :
    (2 : Fin 1000000007) ^ 1000000006 = 1 := by
  decide
Fin 1000000007の値は、modulus未満の自然数と、上限の証拠を持ちます。 4.35ではFinの累乗もNat.powModを使うため、同じmodularな計算をkernelが簡約する経路へ接続します。 #evalの数値出力だけでなく、decideを含むtheoremも、kernelの型検査が受け付ける証明termになります。 大きい指数でも、余りを途中で取らずに累乗全体を構築する必要がありません。
#evalとdecideは、同じ記法の計算を別の目的で使います。 #evalはcompileしたprogramを実行し、値を表示します。 decideは、命題の判定を使って証明termを作ります。 modularPowerが依存するaxiomは、#print axiomsで名前を取得できます。
#print axioms modularPower
-- => 'modularPower' depends on axioms: [propext, Quot.sound]
4.35は、旧式のin-kernel native reductionも削除しました。 対象はLean.reduceBool、Lean.reduceNat、Lean.ofReduceBool、Lean.ofReduceNat、Lean.trustCompilerです。 kernelの内部からcompilerを動かして特定の式を簡約する旧経路は、2026年2月1日からdeprecatedでした。 native_decideとbv_decideは、native evaluationをaxiomとして明示する経路です。 内部ではLean.Meta.nativeEqTrueを使います(旧native reductionを削除するPR #14953)。
当該削除は、#print axiomsとlake checkが扱う依存関係にも関わります。 旧定義はbodyからLean.trustCompilerを常に参照し、単にimportした環境でも依存して見える問題がありました。 新しい検査では、実際の証明が許可されたaxiomだけへ依存するかを、宣言の依存関係へ沿って判定します。 native evaluationを許可する方針と、標準の3個だけを許可する方針は、同じaxiomの集合にはなりません。
ArrayとVectorを、kernelでも計算できる範囲が広がる
4.35はArray.ofFn、Array.map、Vector.mapなどへ、kernelが使える計算の定義を加えています(Array.ofFnのPR #14989)。 Array.mapには、以前からinlineとexposeが付いていました。 しかし、内部から呼ぶ参照実装のArray.mapMは、通常のdefのままでした。 Array.mapMのloopはlocalな再帰functionで、別moduleのkernelには展開できず、簡約が止まっていました。 4.35は参照実装と再帰helperの定義を公開し、import先でもloopを簡約できるようにします。 Array.mapへ委譲するVector.mapも、同じ経路で計算できるようになります(mapのPR #14996)。
zipWithとmodify、modifyMも、対応する追加の対象です。 配列の要素ごとの結合や更新が証明中へ現れた場合に、compiled codeだけを持つ入口で計算が止まる経路を減らします。 ただしkernelの簡約は、実行時と同じallocationやpointer操作を再現する保証ではありません。 証明が参照する論理上の定義と、compile後に使う効率的な実装を対応付ける変更です(zipWithのPR #15078、modifyのPR #15079)。
Vectorは、長さを型へ持つ配列です。 Vector.mapは要素の型を変えても長さを保ち、計算する値と型に現れる長さの対応を維持します。 Reprの表示も#v[...]になり、通常のArrayと区別できます。 長さ3の整数を10倍する表示例は、次の形です(Vectorの表示を変えるPR #14545)。
#eval #v[1, 2, 3].map (· * 10) -- => #v[10, 20, 30]
VectorのDecidableEqも改善されています。 要素の等しさを計算して配列の等式を判定する処理と、長さの証拠を扱う処理が、証明を含むdataの計算へ重なります。 外形を通常のlistとして表示し直すだけの変更ではなく、固定長という型の契約を残した計算です(Vectorの等式判定のPR #14988)。
bv_decideの内部では、CNFと証明の保持量を減らす
bv_decideはbit vectorの命題をbooleanの問題へ変換し、SATによる結果を証明へ接続します。 4.35では、AIGに表れたif-then-else、XOR、XNORを識別する処理が加わりました。 同じ回路をすべてAND gateの組み合わせへ分解してから変換するより、少ないCNF clauseへ直接変換できます。 当該patternでは、12個のclauseが必要だった構成を4個で表せます(AIGのpatternを識別するPR #13968)。
変換対象の回路へ該当するpatternが現れる場合に、solverへ渡す問題の表現が縮みます。 証明全体の時間には、回路を作る処理、SATの探索、得られた証明を検査する処理も含まれます。
LRATのcheckerも書き直されました。 clauseの表現でmemory使用量を減らし、entailment、unit propagation、RUP、RATなどの操作を公開するAPIへ整理しています。 探索するsolverと、返された証明を読むcheckerの役割を分け、検査側が扱うdataの構造を更新しています(LRAT checkerのPR #14842)。
証明をtrimする処理には、元の証明と削減中の証明を同時に保持し、非linearな使い方になる問題の修正もあります。 不要な証明を捨てる処理でも、捨てる前の構造を別の参照が保持し続ければ、memoryを再利用できません。 4.35は、LRATを削減する経路の参照の持ち方も修正し、論理上のclause削除と実装上の保持量を接続しています(LRAT trimのPR #15124)。
自然数をshift幅に使うbit vectorの式には、新しい符号化も加わりました。 BitVec.ofNatClampedを使って必要な幅へ制限し、SAT側では対応するbit vectorのatomとして扱います。 ただし、自然数のshift幅へ任意の算術条件を加えて解く機能ではありません。 bit vectorへの符号化で保持する情報と、自然数側で推論する情報の境界が残ります(symbolicなshift幅のPR #14928)。
bufferの変更を、uniqueな所有の条件へ対応付ける
LeanのArrayやByteArrayは、値として扱いながら、uniqueに所有されている領域を更新へ再利用できます。 同じ領域を別の値が共有していれば、元の値を維持するためにcopyが必要です。 4.35のmarkLinearは、共有している値を必要に応じてcopyしてuniqueにし、以後の書き込みがlinearかを動的に追跡します。 対象にはString、ByteArray、FloatArray、Arrayがあります(markLinearのPR #15052)。
LEAN_ABORT_ON_NONLINEARを設定すると、mark後の書き込みがlinearでない場合にprogramをabortします。 lean_internal_panicへbreakpointを置けば、書き込みの経路をdebuggerで追えます。 markLinearは共有copyを無料にする最適化の指定ではありません。 最初に共有を解くcopyが必要な場合も含め、以後の更新がuniqueな所有を保つという実装上の前提を検出するための機能です。
compilerのfloatLetInにも、side effectやreferenceのlinearityへ関わる修正があります。 EST.OutやST.Outのcaseを越えてletを移動すると、元の評価順序と参照の使い方を維持できない経路がありました。 4.35は移動してよい位置を制限し、値を早く計算する最適化がstateを扱う処理の意味を変える条件を除いています(letの移動を修正するPR #15089)。
ReduceArityでは、すべてのparameterを取り除く場合に、void parameterを残す修正があります。 functionとして呼ぶ値を、引数のない定数と同じ表現へ変えてしまう経路を避けます。 引数を削減できるという最適化上の性質と、呼び出し規約が保持するfunctionの区別を、変換後にも残す修正です(arityを修正するPR #15107)。
closureの引数の個数にも、crashを修正する変更が含まれます。 arityが16以下のclosureへ16を超える引数を適用する経路で、argumentの処理が破綻する問題です。 sourceのfunctionを何段かへ分けて適用する構文と、runtimeが引数を運ぶ経路を、compile後にも一致させます(closureの適用を修正するPR #14969)。
allocatorの設定では、mimallocのMI_MAX_ALIGN_SIZEを8へ設定しました。 List.consのような24 byteのobjectを32 byteのallocation classへ丸めていた余分な領域を減らします。 listの要素やconstructorの論理的な型を変更せず、allocatorが予約する領域の区切りを調整する変更です(mimallocのalignmentを変更するPR #14948)。
生成したC fileの書き込みも、temporary fileからrenameする構成になりました。 clangがC fileをmemory mappingして読む途中で同じfileを書き換えると、lexerが不整合な内容へ到達してcrashする場合があります。 4.35は完成した内容へatomicに置き換え、読む側へ書き込み途中のfileを渡す経路を減らします(C出力をatomicにするPR #14811)。
ST.Refでは、値を取り出すtakeと、値を戻すputを使うcritical sectionへAPIを整理しています。 putを使う前提には、対応する値を先にtakeした状態が含まれます。 takeとputの状態も、referenceを扱うAPIの条件になります(ST.RefのPR #14775)。 別の参照操作では、swapとgetのraceへcompare-and-swapを使う修正があります。 threadが一時的なnullの参照へ到達する経路を除きます(referenceのraceを修正するPR #14585)。
reference countのoverflowは、kernelのmemory safetyにも関わる
証明termの型検査も、objectの参照数や領域の寿命をruntimeで管理します。 4.35には、reference countがoverflowした場合の処理を修正する変更が含まれ、4.34.1にもbackportされています。 論理規則を変更する差分ではなく、規則を実行するkernelのdataが、解放後の領域を参照しないための修正です(4.35.0のruntime修正)。
1件目は、objectを連鎖的に解放するdeletion cascadeです。 overflowまたはunderflowでreference countを固定したobjectを、内部の解放経路が再び減算し、使用中に解放する可能性がありました。 18 GB以上の空きmemoryを持つmachineでは、official kernelのuse-after-freeへつながる可能性が修正対象です。 新しいguardは、persistentなobjectと、固定したsticky countの両方で解放を止めます(deletion cascadeを修正するPR #15241)。
2件目は、同じsubtermを共有するsharecommon_quick_fnのincrementです。 INT_MAXを超える参照数でcountが巻き戻り、まだ参照しているsubtermを解放する可能性がありました。 100 GBを超える入力では、official kernelのundefined behaviorを排除できない経路です。 4.35はcountのoverflowを検出するとpanicし、使用中の領域を解放する処理へ進ませません(maximal sharingを修正するPR #15289)。
3件目は、巨大な参照数を持つobjectをthread間で共有する処理です。 親のcountがoverflowしていると、子のobjectをthread-sharedへmarkしない経路がありました。 別threadが子のcountをnon-atomicに更新すれば、使用中に解放する可能性が生じます。 修正は、overflowした親からたどる子にも共有状態を伝え、参照数を更新する経路を合わせます(thread共有を修正するPR #15288)。
既定のofficial kernelはsingle-threadで動くため、3件目の条件は、同じruntimeで並列に動くcheckerとは異なります。 con-lecheのようにLean runtimeを使うcheckerは、同じruntimeの不具合を共有する範囲があります。 一方、nanodaやcon-ronは、Lean runtimeに基づかないため、参照数の実装も同一ではありません。 lake check --paranoidが複数の実装を使う理由は、theoremのstatementを変えることではなく、同じ証明termへ異なる実装の型検査を適用できる点にあります。
elaborationと構文の変更も、既存のmetaprogramへ影響する
instance searchは、要求された型との照合でmetavariableを割り当てられる範囲を修正しました。 instance transparencyで展開すれば一致する型を、表面の形の不一致だけで除外する経路を改善しています。 同時に、unificationでstuckした場合も、残るheuristicを試してから停止する変更があります。 instance searchでは、必要な展開を含む型の照合を改善します(instance searchのPR #14624)。 unificationでは、計算のstuckと、残る手法を試しても解けない結果を分けます(unificationのPR #14583)。
rangeの構文では、1+2...3を(1+2)...3として読むprecedenceへ変わりました。 a...b|>.toListも、range全体へpipelineを適用する読み方へ揃えています。 rangeを作る演算と、端の値を計算する演算の結び付きが変わるため、独自macroが受け取る構文木にも影響します(rangeのprecedenceを変更するPR #15054)。
singletonの記法にも、継続行のindentationを要素の開始位置より深くする条件が加わりました。 行の境界が式の継続か、外側の構文へ戻る位置かを決める入力になります。 見た目だけの整形ではなく、複数行の式をparserがまとめる範囲へ関わる変更です(singleton記法のPR #14350)。
syntaxの型では、TSepArrayをSepArrayへ統合し、separatorのSourceInfoを保持する構成になりました。 separatorを挟む要素の列へ、型情報のないSyntaxの配列を暗黙に流すcoercionも整理されています。 macroが生成する構文の位置情報と、型を持つsyntaxの容器を、明示したAPIへ合わせる移行です。 separatorの位置情報と容器の型を、新しい表現へ合わせます(syntaxの配列を変更するPR #15020)。 旧withPositionも削除されるため、macroで使う構築APIの名前も変更対象です(withPositionのPR #15019)。
Lakeは、失敗後のjobとdependencyの配置を選べる
lake build --fail-fastは、最初のrequired targetの失敗を受け、新しいbuild jobの開始を止めます。 すでに動いているjobはkillせず、完了するまで待ちます。 早い段階でerrorが出たworkspaceでも、未開始のdependency chainへ処理を広げ続ける必要を減らします(fail-fastのPR #14797)。
lake build --fail-fast
停止判定は、Job.mapMとJob.bindMのcontinuationをdispatchする位置で行います。 失敗を共有するcancel tokenが設定されていれば、当該continuationへ進みません。 開始を見送ったjobと、実際に失敗したjobを分けるため、cancelしたmoduleへ架空のbad importを追加しません。 後続の表示改善では、開始しなかったtargetにCanceledの状態も表示します(cancelの表示を改善するPR #14835)。
path dependencyには、copy = trueの設定が加わりました。 通常のpath dependencyは、指定した相対pathのpackageを直接読みます。 copyを有効にすると、packageをworkspaceのpackages directoryへ複製し、複製先から読み込みます。 隣のcheckoutを直接buildする構成と、workspace内にdependencyの実体を置く構成を選べます(path dependencyのcopyを追加するPR #15142)。
native codeの事前compileにも、粒度を分ける設定が加わっています。 precompileImportsはmoduleがimportする側をcompileし、module自身を対象に含めません。 precompileLibraryは、library全体をimportする利用者向けにcompileします。 library内部の各moduleが、elaboration時に自分のimportをcompileする設定ではありません。 より広いprecompileModulesだけでは同時に選んでいた処理を、必要な境界へ限定できます(precompileの設定を分けるPR #15015)。
dependency cacheでは、package単位のbuild記録を生成してuploadする入口が加わりました。 lake build -o build.json --package nameで、対象packageの記録を作ります。 lake cache put build.json --package=nameで、同じpackageを指定して記録を渡します。 projectの成果物を一括して扱う処理と、特定のdependency packageのcacheを供給する処理で、対象を指定できます。 cacheの記録とpackage名を合わせることで、別のpackageのbuild結果を同じupload対象へ混ぜる条件を減らします(package単位のcacheのPR #15141)。
lake lintにはcode qualityを扱う経路も加わっています。 elaboration中のlinterが収集したentryを.oleanへ保存し、build toolは再elaborationせずに各moduleのentryを取得できます。 通常のwarningとは別の情報として蓄え、CLIやeditorへ同じmessageを表示しません。 warningAsErrorの判定にも直接混ぜません(quality entryを保存するPR #14748)。
package側のpackage_code_quality_checkを登録する仕組みもあり、保存した指標へpackage固有の判定を加えられます。 moduleをもう一度compileして指標を取り直す処理と、既存のbuild結果から指標を集める処理を分けます。 build、証明のexportと再検査、保存したlinter情報の収集は、異なるcommandです。 同じworkspaceのartifactを、必要な検査や集計へ渡せます(Lakeのcode qualityを接続するPR #14933)。