Swift 6.4詳解——非同期のdefer、cancellation shield、noncopyableなcollection
Swift 6.4のcleanupとcancellation、UniqueArrayとIterable、borrow accessor、SwiftPMとdebug情報の変更をコード例から解説します。
Swift 6.4は2026年9月15日、6.4.1は10月13日に公開されました。 6.4では、defer内の非同期処理、cancellation shield、noncopyableな値を格納するcollectionが加わっています。 6.4.1は、optimizer、package解決、Foundation、testingの不具合を修正します(Swift 6.4、Swift 6.4.1の公開記録)。
コード例の対象は、macOS/arm64のApple Swift 6.4です。 compilerの識別文字列はswiftlang-6.4.0.34.1です。 言語modeは-swift-version 6です。 以下では、処理を終える順序、値の所有、参照のlifetime、生成物のdependencyへ分けて変更を説明します。
deferから呼んだ非同期処理を、戻る前に完了させる
従来のdeferは、scopeを出る際のcleanupを、準備した処理の近くへ書く構文でした。 複数のdeferがあれば、登録した逆順に実行します。 6.4では、周囲がasyncなcontextなら、body内でawaitできます。 呼び出し元へ戻る前に、非同期のdeferも完了するまでawaitされます(SE-0493)。
actor EventLog {
  private var values: [String] = []
  func add(_ value: String) { values.append(value) }
  func snapshot() -> [String] { values }
}

func process(_ log: EventLog) async {
  defer { await log.add("cleanup") }
  await log.add("body")
}
EventLogは、eventを順に保存するactorです。 processの通常の処理で"body"を加え、終了時に"cleanup"を加えます。 呼び出し元が"caller"を加える時点では、processのcleanupも完了しています。
let log = EventLog()
await process(log)
await log.add("caller")
print(await log.snapshot()) // => ["body", "cleanup", "caller"]
以前は、非同期cleanupをdefer { Task { ... } }へ包む方法が使われていました。 ただし独立したtaskを作るだけなら、元のfunctionが戻る際にtaskの完了を待つ関係を持ちません。 呼び出し元が次の処理へ進んだ後も、cleanupが実行中という順序になり得ます。 6.4のawaitを含むdeferは、scopeを抜ける制御の経路へ非同期処理の完了を含めます。
同じcleanupを、通常return、早期return、errorを投げる経路へ個別に書く必要も減ります。 ただしdeferのbodyからerrorを外へ投げる条件を、無制限に変えるproposalではありません。 非同期operationがthrowするなら、cleanup内部で失敗を扱う構成が必要です。 実行する時刻をscopeの終了へ結び付ける性質と、errorを処理する契約は、別の条件として残ります。
suspensionはdeferの実行時にも発生する
非同期のdeferは、登録した位置でただちに実行する処理ではありません。 scopeを出る際に呼び、含まれるoperationがsuspendすれば、終了処理の途中でtaskがsuspendします。 元のfunctionのbodyに見える最後のawaitより後でも、cleanupの非同期呼び出しによってsuspensionが生じます。 呼び出し元へ戻るまでが、最後の通常statementだけで決まる構成ではなくなります。
新しいdefer asyncというkeywordは導入していません。 実際の非同期呼び出しへ付けるawaitと、周囲のasyncなcontextで条件を表します。 closureなら、defer内のawaitがclosureのasyncを推論する根拠にもなります。 宣言したfunctionが同期のままなら、body内のdeferだけを非同期へ変えることはできません。
同期functionにasyncなdeferを置くと、6.4でもerrorになります。
func cleanup() async {}

func process() {
  defer { await cleanup() }
  print("body")
}
// error: 'async' defer must appear within an async context
scope終了時の暗黙のawaitも、同期functionの公開型からは実行できないためです。 新しい構文が許すのは、すでに非同期処理を表せるcontextでの終了処理です。
deferのbodyは、周囲のscopeのisolationを引き継ぎます。 非同期cleanupのためだけに、無条件で別actorやexecutorへ移る規則ではありません。 別actorのmethodを呼ぶなら呼び出し先の条件でsuspendし、同じisolation内の処理なら必要なaccessを維持します。 cleanupを独立taskへ移す従来の回避策と、元のscopeへ留める構文では、実行する文脈も異なります。
cancellation shieldの内部ではTask.isCancelledがfalseを返す
非同期のdeferを追加しただけでは、cancelされたtaskの状態は変わりません。 cleanupが呼ぶfunctionでTask.checkCancellation()を使うと、CancellationErrorをthrowし、必要な処理より先に終了する場合があります。 6.4のwithTaskCancellationShieldは、scope内でTask.isCancelledにfalseを返させます。 Task.checkCancellation()によるthrowも抑止します。 task自体のcancellationを取り消す操作ではありません(SE-0504)。
withUnsafeCurrentTask { $0?.cancel() }
let before = Task.isCancelled
let inside = withTaskCancellationShield { Task.isCancelled }
let after = Task.isCancelled
print(before, inside, after) // => true false true
shieldへ入る前はcancel済みで、shield内のstaticなTask.isCancelledはfalseを返します。 shieldを出た後のTask.isCancelledは、元のcancel済み状態に対応するtrueを返します。 途中でcancel要求を破棄してtaskを未cancelへ戻す処理なら、最後の値を説明できません。
shieldには、同期のclosureを受け取る版と、非同期のclosureを受け取る版があります。 同期のcleanupのためだけに、新しい非同期taskを作る必要はありません。 非同期版でも、元のtaskから独立したunstructured taskへ処理を移すことなく、shieldのscopeを実行します。 task-localな文脈とcleanupの完了を、元の実行経路へ保持できる構成です。
task handleから読む状態とは異なる
Task.isCancelledは、現在の実行scopeの状態を読むstaticな入口です。 一方、外部から取得したtask.isCancelledは、特定のtaskの実際のcancel状態を返します。 shield内で実行している途中でも、外部のhandleから読む値を未cancelへ反転しません。 taskの実行がshieldへ入ったり出たりするたびに、外部から状態が変わって見える動作を避けています。
withUnsafeCurrentTaskから得るhandleのisCancelledも、taskの実際のcancel状態を返します。 現在のtaskがshield内かを調べるhasActiveCancellationShieldも追加されました。 staticなTaskとUnsafeCurrentTaskの両方に、hasActiveCancellationShieldがあります。 isCancelledと組み合わせれば、taskへ届いたcancel要求と、shieldの有効期間を区別できます。
shield内から自分自身をcancelしても、同じscopeのTask.isCancelledはfalseを返せます。 要求を送るoperationと、要求を読むoperationが、同じ条件を使うわけではないためです。 shieldが終了すると、要求されたcancellationが残ります。 cancelの恒久的な取り消しを公開するAPIを追加したものではありません。
child taskとcancellation handlerの境界
shield内で作り、shield内でlifetimeを扱うstructured child taskには、外側からのcancelの自動伝播を遮ります。 async letやtask groupを使うcleanupでも、親がcancel済みという理由だけで、開始直後からcancel済みになる経路を避けられます。 ただしtask groupのcancelAll()など、child側を明示的にcancelする操作は有効です。 外側の要求から守るscopeと、child自身へ送る要求は、同じものとして消去しません。
task groupのaddTaskを同期のshieldで包むだけでは、childの実行scopeを覆いません。 追加したchildは、closureの呼び出しが終わった後も動くためです。 特定のchildでTask.checkCancellation()のthrowを抑止するなら、childのbody内へshieldを置きます。 scopeの字面がtaskを作る式へ接していることより、shieldが実際の計算を囲むlifetimeが意味を持ちます。
shieldが有効な間に登録したcancellation handlerも、shieldによる制御を受けます。 cleanupが呼ぶ下位のAPIで登録したhandlerも、shield内では外側のcancelを受けて即座に実行されません。 既存のすべてのtaskへhandlerの抑止を広げる操作ではなく、shieldで囲んだ現在のtaskのscopeが対象です。 下位の処理が自分で持つtimeoutや別のerrorまで、同じ成功条件へ変えるわけではありません。
deferとshieldを組み合わせると、cleanupの完了をawaitしながら、内部でcancelを理由にthrowする経路を抑止できます。 deferはcleanupを開始して完了を待つ順序を定め、shieldはcleanup内部でcancelを理由に短絡する条件へ作用します。 shieldはruntimeの変更も使うため、proposalは古いruntimeへのback deploymentを対象にしていません。 compilerだけを更新して古いOS上のruntimeまで同じAPIを使える条件にはなりません。
optionalなsomeとanyの括弧を減らす
6.4では、some P?を(some P)?、any P?を(any P)?と同じ意味で書けます。 以前はP?をconstraint側へ結び付け、protocolではないOptional<P>を指定するerrorになりました。 末尾の?が、opaque typeやexistential typeの全体へ適用される構文です。 protocol自体をoptionalにするという新しい型constructorを導入するわけではありません(SE-0521)。
protocol Label {
  var text: String { get }
}

struct Item: Label {
  let text: String
}

func make(_ present: Bool) -> some Label? {
  present ? Item(text: "ready") : nil
}

let first: any Label? = Item(text: "ready")
let second: any Label? = nil
print(first?.text ?? "absent", second?.text ?? "absent") // => ready absent
print(make(true)?.text ?? "absent", make(false)?.text ?? "absent") // => ready absent
someの返り値では、隠れた具体型はItemであり、callごとに任意の別実装へ切り替える契約ではありません。 anyはprotocolに合う値を格納するexistentialで、optionalという外側の容器を簡潔に書けるようになっています。
複数protocolを合成する場合には、括弧が残ります。 any (P & Q)?は書けますが、any P & Q?を同じ意味として無条件には受け付けません。 postfixの?が長い合成全体へ作用する範囲を、構文へ明示するためです。 括弧の削減は、任意の型式から括弧を外せる一般的な優先順位の変更ではありません。
既存の(any P)?や(some P)?は同じ型を表すため、ABI上の別の型へ変わりません。 新しいcompilerが出す.swiftinterfaceでは、古いcompilerが読めるよう、括弧付きの綴りを維持します。 開発者がsourceで選ぶ表記と、module interfaceを別versionのcompilerへ渡す表記を分けています。 単に新構文で書いた全公開型を、新構文の綴りで配布する構成にはなりません。
@diagnoseでwarningの適用範囲を宣言へ限定する
@diagnoseは、指定したdiagnostic groupを、宣言のscopeでerror、warning、ignoredへ設定するattributeです。 command lineのmodule全体の設定に対し、sourceの宣言単位でseverityを指定できます。 functionならbodyだけでなく、signatureも対象になります。 元からerrorとして出る診断を、warningの設定で無効化する機能ではありません(SE-0522)。
@available(*, deprecated, message: "Use modern()")
func legacy() {}

@diagnose(DeprecatedDeclaration, as: error)
func adapter() {
  legacy() // error: 'legacy()' is deprecated: Use modern()
}
adapter内のdeprecatedなfunction呼び出しは、errorになります。 診断groupはDeprecatedDeclarationとして表示され、attributeで指定した対象へ一致しています。 project全体をwarnings-as-errorsにしなくても、特定の宣言で同じgroupを厳しく扱えます。
内側の宣言へ同じgroupの設定を付けた場合は、外側のscopeから受けた設定を精密化できます。 groupにsubgroupがある場合は、subgroupだけを対象にする設定も可能です。 別のgroupに属するwarningまで、同じattributeへ巻き込まれるわけではありません。 reason:には文字列literalを付けられますが、string interpolationで動的な理由を生成する構文ではありません。
importへ付けたattributeは、import statement自身が出すwarningへ作用します。 import先のlibraryのすべての宣言へ、利用者のseverity設定を遡って適用する意味ではありません。 macroが生成する宣言に対する設定なども含み、attributeを付ける構文ごとに対象のscopeが定まっています。 診断を受けるsourceの位置と、既定のmodule設定との優先関係を、公開された規則で限定しています。
UniqueArrayは、配列と要素の所有を1個へ保つ
通常のArrayはcopyableで、複数の値がstorageを共有した後、変更時にcopy-on-writeで独立させます。 しかし要素がnoncopyableなら、共有したstorageから要素を複製して分離する経路を作れません。 6.4のUniqueArrayは、配列自体をnoncopyableにし、storageの所有者を1個へ保ちます。 要素にもCopyableを要求せず、所有を移すoperationで格納できます(SE-0527)。
struct Ticket: ~Copyable {
  var number: Int
}

func demo() {
  var tickets = UniqueArray<Ticket>()
  tickets.append(Ticket(number: 7))
  tickets.append(Ticket(number: 11))
  print(tickets.count)
  for ticket in tickets {
    print(ticket.number)
  }
}
demo()
2
7
11
UniqueArrayは追加のmoduleをimportせずに使えます。 appendは、新しいTicketの所有を配列へ移します。 loopは要素をcopyする代わりに借りて読むため、TicketにCopyableを要求しません。 通常のArrayは要素にCopyableを要求するため、同じTicketを格納できません。
let tickets = [Ticket(number: 7)]
// error: generic struct 'Array' requires that 'Ticket' conform to 'Copyable'
配列の代入もcopyとは異なります。 let second = firstでnoncopyableな配列を移すと、firstは消費されます。 移動後のfirst.countは、consume後の再利用として拒否します。
func invalid() {
  var first = UniqueArray<Ticket>()
  first.append(Ticket(number: 7))
  let second = first
  print(second.count)
  print(first.count)
}
// error: 'first' used after consume
所有権の診断を含むcompileには、swiftc -swift-version 6 -c UniqueFailure.swiftを使います。 単にruntimeで参照数がたまたま1になっている配列ではなく、sourceの所有関係をcompilerが制約します。
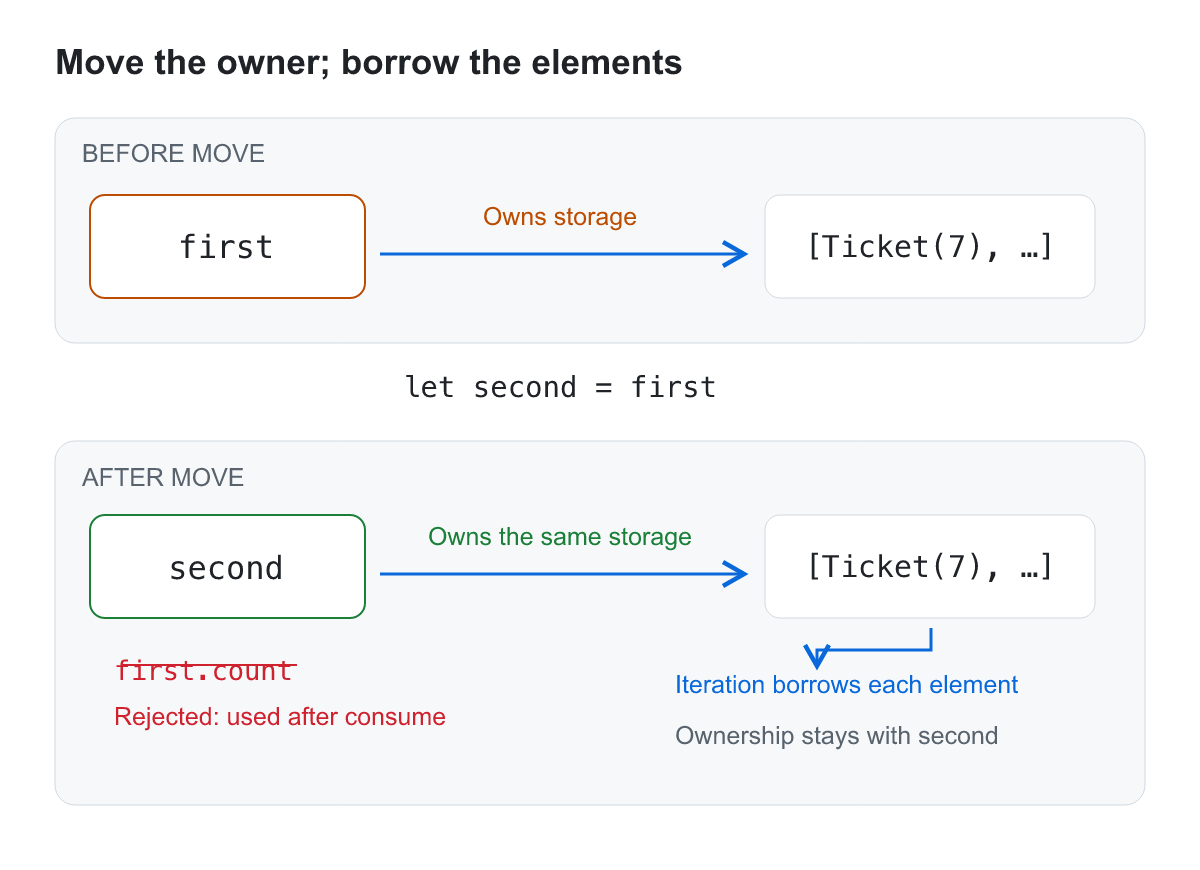
copy-on-writeの配列では、他の値がstorageを共有するかが、変更時にcopyする条件へ関わります。 UniqueArrayの代入は所有を移すため、代入後の共有storageを変更時にcopyして分離する経路を作りません。 一方、capacityを超える追加では、新しいbufferを確保して要素を移す処理が必要です。 所有がuniqueである条件と、追加時に常にallocationがない条件は独立しています。
capacityの成長と、実際のoperationの計算量
UniqueArrayは動的にcapacityを増やす配列です。 追加が必要なcapacityを超えた場合、既存の要素を含む新しいcontiguousなstorageへ移ります。 capacityを幾何的に成長させることで、連続する追加のamortizedな計算量を保ちます。 成長率は実装の詳細で、特定の倍率をsourceの契約として固定するAPIではありません。
したがって、copy-on-writeを外した配列でも、単発のappendが要素数に比例する場合は残ります。 sharedなcopyを分離するための移動と、capacityを増やすための移動は、発生する条件が異なります。 noncopyableな要素でも所有を新しい領域へ移せるため、動的な成長を実装できます。 各要素の独立したcopyを作れない性質は、所有を保った移動を禁止する性質ではありません。
従来のArrayを、要素がcopyableかによって条件付きでcopyableにする案もproposalで検討されています。 genericなcontextでは、実際の要素がcopyableかをruntimeで判定し、copy-on-writeの経路を選ぶ必要が生じます。 noncopyableを許す宣言だけでは、実際の型argumentが必ずnoncopyableとは決まらないためです。 UniqueArrayは別の型として所有の条件を固定し、既存のArrayの変更operationへ新しい判定を一括で加える構成を避けています。
配列を受け取るAPIも、所有の使い方を型へ反映します。 読むだけならborrowし、以後使わない所有を渡すならconsumeし、内容を更新するならmutatingなaccessを要求します。 noncopyableな要素を通常のcopyableな値として返すAPIへ、無条件には適合しません。 collectionの選択は、格納できる要素だけでなく、受け取った値を呼び出し側が使い続けられる条件も変えます。
UniqueBoxは、heap上の1値をuniqueに所有する
UniqueBoxは、heapへ置いた1個の値をuniqueに所有するsmart pointerです。 中身はnoncopyableでも格納できます。 box自体もnoncopyableで、使用が終わると中身の破棄と領域の解放を担当します。 手動のpointerで必要だったinitialize、deinitialize、deallocateの組を、所有する値のlifetimeへまとめます(SE-0517)。
var box = UniqueBox(Ticket(number: 42))
print(box.value.number) // => 42
box.value = Ticket(number: 43)
print(box.value.number) // => 43
valueへの読み取りは、中身を独立したTicketへcopyしません。 更新時は、元のpayloadを新しい値へ置き換えます。 classでboxを作る方法と異なり、複数のownerが同じboxを参照する契約を、既定の容器へ含めていません。
boxの値を別の変数へ移しても、heap上のpayloadのaddressは移動しません。 boxの所有を保持する側が変わることと、payloadの格納場所を変更することは独立しています。 ただしproposalは、raw pointerを取得する公開APIを同時には追加していません。 安定したaddressを内部で持つ性質から、任意のunsafe pointerを取り出して外へ保存する操作まで許可されたとは扱いません。
payloadの所有を取り出すconsume()は、boxを消費します。 copyableなpayloadには、明示的に別のboxを作るclone()もあります。 普通の代入が暗黙の共有copyになる構成と、明示的なcloneで新しい所有を作る構成を分けています。 大きい値をheapへ間接化する目的と、値を複数箇所で共有する目的は、別の容器で表せます。
Iterableは、要素を返す代わりにSpanを渡す
従来のSequenceは、iteratorのnext()がElement?を返します。 返り値として要素を所有する形では、noncopyableな要素を残したまま、独立した次の値を渡すことができません。 6.4のIterableは、連続した要素を参照するSpanをiteratorから受け取り、要素をborrowして走査します。 前述のUniqueArray<Ticket>のloopは、要素のcopyを要求しない走査の例です(SE-0516)。
Iterable自身も、noncopyableまたはnonescapableな型へ適合できます。 elementにもCopyableを要求しません。 makeBorrowingIterator()が返すiteratorは、走査対象のlifetimeへ依存します。 配列などのownerが使えなくなった後まで、iteratorだけを保存して読み続ける契約ではありません。
iteratorの中心になるoperationは、nextSpan(maxCount:)です。 最大の要素数を受け取り、次の連続領域を表すSpanを返します。 空のSpanは走査の終了で、終了後の呼び出しも空を返す必要があります。 1要素ずつ返すAPIと異なり、連続領域を持つcollectionでは、複数要素のaccessを1回の取得へまとめられます。
ring bufferのように物理的な領域が途中で折り返す場合は、複数のSpanを返せます。 最初は開始位置からbufferの末尾、次はbufferの先頭から最後の要素までです。 storage全体を常に1個の連続領域として公開する必要はありません。 rangeのように要素を都度生成する型なら、1要素のSpanを繰り返し返す構成も可能です。
次のSpanを取得すると、以前のaccessは終了する
返したSpanは、iteratorのexclusive accessへlifetimeが依存します。 nextSpanや別のmutating operationを再び呼ぶ前に、以前のSpanを使うaccessを終える必要があります。 iteratorが次の要素を生成する際、同じ一時storageを再利用する実装も表せるためです。 前のelementへの参照を保存したまま次へ進める構成を、一般のiteratorへ要求しません。
noncopyableな要素をloopの外へ保存する処理は、借りた値のlifetimeを越える場合があります。 一般的なfirst(where:)が単に要素を返せない理由も、内部で作ったiteratorのlifetimeへ結果が依存するためです。 copyableな要素ならcopyを作って返せますが、noncopyableまで許すgenericな実装へ同じ処理を拡張できません。 走査しながら読む契約と、選んだ値の所有を外へ渡す契約を分ける必要があります。
maxCountは、単なる性能上のhintではありません。 iteratorを別のfunctionへinoutで渡し、必要な個数だけ処理して返す用途で、取り出す上限を指定できます。 大きいSpanを無条件に返すAPIでは、呼び出し側に、使わなかった残りの位置を保持する処理が必要です。 bulkな走査と、途中で処理を区切るoperationを、同じiteratorのstateへ合わせるためのparameterです。
throwing iterationとFailure
IterableとBorrowingIteratorProtocolには、Failure: Errorというassociated typeがあります。 既定はNeverなので、単に格納済みの要素を読むcollectionなら、loopへtryを加えずに使えます。 生成やaccessで失敗するiteratorなら、for try element in iterableと書きます。 genericなalgorithmも、throws(Failure)で失敗する型を保持できます。
iteratorがerrorを投げた後の継続動作は、一般のprotocolが一律には保証しません。 呼び出し元が同じiteratorへ再びnextSpanを呼び、必ず次の要素から回復できる契約ではありません。 errorより前の要素を失わないよう、先行するelementのSpanはerrorを投げる前に返す規則があります。 走査の終了を示す空のSpanと、失敗を投げる経路の後状態は、別の契約として定義されています。
borrowとmutate accessorで、stored valueへのaccessを公開する
6.4は、computed propertyとsubscriptへborrowとmutate accessorを追加します。 getのように独立した値を返す代わりに、ownerが持つstored valueを借りて公開します。 mutateでは、更新可能なexclusive accessとして&を付けた値を返します。 payloadがnoncopyableでも、中身をcopyせずにproperty経由で読み書きできます(SE-0507)。
struct Wrapper<Element: ~Copyable>: ~Copyable {
  var storage: Element
  var value: Element {
    borrow { storage }
    mutate { &storage }
  }
}
Wrapperのpropertyを通じた更新は、保持するTicketの同じfieldを書き換えます。
var value = Wrapper(storage: Ticket(number: 21))
print(value.value.number) // => 21
value.value.number += 1
print(value.value.number) // => 22
利用側のproperty accessは通常の記法でも、accessorは独立したTicketをcopyして返していません。 値を読む式と、値の所有を別の変数へ移す式の差が、propertyの実装にも現れます。
borrowから返すのは、accessorが戻った後もstorageが有効な値です。 accessor内で作ったlocalな配列を返したり、temporaryなoptionalを構築して返したりする処理は許しません。 ownerの次のmutationまで有効なstorageを公開するという、lifetimeの条件があるためです。 任意の新しい値を計算して返せるgetのbodyを、keywordだけ変えて同じ契約にできるわけではありません。
yielding borrowやyielding mutateは、accessの前後へ処理を置けるcoroutineです。 temporaryな値を構成し、accessの完了後に片付ける用途も表せます。 新しいborrow accessorはcoroutineを使う必要を減らせますが、公開できるstorageの条件が強くなります。 temporaryを生成する柔軟さと、保存済みの値へ直接accessする仕組みで、使用できる実装が異なります。
borrowが有効な間は、ownerを矛盾する形で変更できません。 mutableなaccessが有効なら、同じownerへ別のaccessを重ねることも制限されます。 copyを避けるために内部の値を公開しながら、元のstorageを変更して参照を無効にする経路を防ぎます。 propertyへborrowを付ける意味は、単なるinline最適化の希望ではなく、accessとlifetimeの契約です。
RefとMutableRefは、1値への参照を値として扱う
Ref<Value>はsharedな読み取り、MutableRef<Value>はexclusiveな読み書きを表します。 両方ともnonescapableなので、参照先のlifetimeを越えて自由に保存する型ではありません。 Refはcopyableですが、copyしても参照先の所有を新しく作りません。 MutableRef自体はnoncopyableで、同じexclusive accessを無条件に複製しない構成です(SE-0519)。
var number = 10
do {
  var reference = MutableRef(&number)
  reference.value += 5
  print(reference.value) // => 15
}
print(number) // => 15
scope内ではreference.valueを通じて同じ整数を更新し、scopeを出ると元のnumberへaccessが戻ります。 更新した値を別のboxからコピーし直す処理ではありません。 inoutのfunction呼び出しの中だけに限定されていたexclusive accessを、lifetime付きの値として持てます。
dictionaryのentryへ何回も加算する用途なら、MutableRef(&dictionary[key, default: 0])でaccessを一度形成できます。 以降はreference.valueへ加算し、毎回同じkeyでlookupする式を繰り返さずに済みます。 ただし参照の有効期間中は、dictionary本体へ矛盾するaccessを重ねません。 hash tableを変更してentryのstorageを移す処理と、取得済みのentryを更新する処理を、同時に許す契約にはなりません。
noncopyableなOptionalの追加APIの公開範囲
Optionalへref、mutableRef、put()を加える機能は、SE-0532で提案されています。 2026年10月24日時点のstatusはAcceptedで、対応する実装PR #88505は未mergeでした。 Apple Swift 6.4のTicket?には、refが存在しません(SE-0532、実装PR #88505)。
func inspect(_ ticket: borrowing Ticket?) {
  if let reference = ticket.ref {
    print(reference.value.number)
  }
}
// error: value of type 'Ticket?' has no member 'ref'
提案するrefは、optionalが値を持つ場合だけ、payloadへの読み取り参照を返します。 mutableRefなら更新可能な参照で、optional自体を消費せずに中身を扱う目的です。 従来のif letでnoncopyableなpayloadを取り出すと、optionalを消費する経路になり得ます。 新しい参照の形は、値が存在する条件と、payloadを借りるaccessを同じ式で表すための追加です。
提案前の書き方では、noncopyableなoptionalのswitchでpayloadをborrowする方法があります。 読み取りでpayloadを消費せず、optionalを引き続き使用できます。 UniqueArrayの走査、propertyのborrow accessor、optionalのpayloadのaccessは、いずれもcopyを要求しない方向の機能です。 ただしUniqueArrayやborrow accessorと異なり、SE-0532の追加memberは6.4のApple toolchainには存在しません。
一時bufferの初期化と破棄をOutputSpanへまとめる
withTemporaryAllocationは、一時的な領域をOutputSpanまたはOutputRawSpanとして渡します。 未初期化の領域を持つraw pointerを直接渡す代わりに、初期化した要素数をspan側で追います。 closureが戻ると、初期化済みの要素を破棄し、領域のlifetimeを終えます。 throwする経路でも、初期化した部分だけを適切に片付ける構成です(SE-0524)。
let total = withTemporaryAllocation(of: Int.self, capacity: 3) { output in
  output.append(1)
  output.append(2)
  output.append(3)
  return output.span[0] + output.span[1] + output.span[2]
}
print(total) // => 6
capacity: 3は、最初から3個のIntを初期化する指定ではありません。 appendで初期化した部分が増え、output.spanは初期化済みの値を読む入口になります。 確保した領域の広さと、実際に有効な値を置いた範囲を、同じ整数として扱いません。
以前のwithUnsafeTemporaryAllocationでは、初期化したcountを利用者が追い、終了時のdeinitializeを合わせる必要がありました。 途中でthrowした場合、初期化済みの範囲を間違えると、破棄漏れや未初期化の値の破棄へつながります。 新APIは、追跡する初期化状態とcleanupを、容器のoperationへ含めます。 temporaryなallocationをstackへ置く最適化を使えることと、すべての入力でstack allocationを保証することは別の条件です。
raw byte用の版は、byte数とalignmentを受け取り、OutputRawSpanを渡します。 typedな版は要素型とcapacityを受け取り、要素数を単位にします。 同じ整数を引数へ渡しても、byteの個数と要素の個数では確保する範囲が異なります。 bufferへ有効な値を書き込むoperationと、初期化済みの領域を読み取るoperationを、型に沿って選びます。
RawSpanのsafeなloadは、任意の型の復元ではない
raw byteから値を読むAPIには、ConvertibleFromBytesという制約を使います。 任意のbit patternが有効な値になる型が対象です。 書き出す側のConvertibleToBytesは、strideに含まれるbyteがすべて初期化される条件を持ちます。 読める型と、全byteを安全に公開できる型を分けています(SE-0525)。
整数は、bit patternを有限幅の値として解釈できます。 一方、Range<Int>は2個の整数を持っていても、下限が上限以下という意味上の条件があります。 任意の2整数のbit列を読むだけで、有効なRangeになるとは決まりません。 fieldが整数だけという構造上の一致は、任意のbyte列から復元してよい条件と同じではありません。
書き出し側では、paddingを持つ型も問題になります。 stored propertyへ値が入っていても、stride全体のpaddingまで初期化済みとは限りません。 ConvertibleToBytesは、未初期化のbyteを公開する経路を排除するための条件です。 BitwiseCopyableだけで、任意の外部byte列の読み込みと、stride全体の書き出しを両方許可しません。
新しいload(fromByteOffset:as:)は、boundsを検査し、pointer alignmentの制約を要求しない読み込みです。 fixed-width integerには、ByteOrder.bigEndianや.littleEndianを指定する版もあります。 network formatやfile formatが定めるbyte順と、hostのnativeなbyte順を、APIへ渡せます。 safeなloadはatomic operationではないため、複数threadの同期まで同じ呼び出しへ含めるものではありません。
Subprocess 1.0は、streamと終了結果のAPIを確定する
Subprocess 1.0.0は2026年8月4日に公開された、processを起動するSwift packageです。 Swift 6.4の公開紹介でも、関連するlibraryの更新として取り上げられています。 compilerに組み込まれたstatementではなく、Package.swiftのdependencyとして追加して使います。 以下のコード例のdependencyはswift-subprocess 1.0.0です(Subprocess 1.0.0の公開記録)。
import Subprocess

let result = try await Subprocess.run(
  .path("/bin/echo"),
  arguments: ["release-demo"],
  output: .string(limit: 1024),
  error: .string(limit: 1024)
)
print(result.standardOutput, terminator: "") // => release-demo
print(result.terminationStatus.isSuccess)   // => true
1.0.0のstandardOutputは、optionalを外したStringです。 以前のAPIがString?を返していたため、古い例ではunwrapが必要でしたが、1.0.0では不要です。 decode時は不正なbyte列をUnicode replacement characterへ置き換えるため、不正なencodingをnilとして返す契約ではありません。
limit: 1024は、収集する出力のbyte数の上限です。 出力をmemoryへすべて貯める場合も、無制限のcollectionを既定の前提にせず、上限を指定します。 長い出力を順に処理する用途には、.sequenceでstreamとして受け取る入口があります。 全体を収集した文字列と、順に消費するstreamは、返す値の型とmemoryの使用条件が異なります。
processの起動・I/Oに関するerrorと、起動したprogramが非0のcodeで終了する結果も異なります。 /bin/shへexit 7を渡しても、processの終了結果を返り値として取得できます。
let failed = try await Subprocess.run(
  .path("/bin/sh"),
  arguments: ["-c", "exit 7"],
  output: .discarded,
  error: .discarded
)
print(failed.terminationStatus.isSuccess) // => false
tryが付いているという理由だけで、非0の終了codeがすべてSwiftのthrowへ変わるわけではありません。 終了codeを判定する処理には、返り値のterminationStatusを使います。
Unix系では、通常の終了とsignalによる終了を、異なるcaseで表します。 isSuccessは、成功した通常終了を簡潔に検査する入口です。 stdoutへ期待した文字列が出ていても、後からerrorで終了するprogramはあり得るため、出力の有無を終了結果の代わりにはしません。 standardOutputとterminationStatusは、出力された文字列とprocessの終了状態を別のpropertyで返します。
1個のExecutionから、必要なstreamへaccessする
1.0では、Executionがinput、output、errorの型をparameterに持ちます。 input: .inputWriterならstandardInputWriter、output: .sequenceならstandardOutputへaccessできます。 stdinだけ専用の別closure引数を使っていた以前の構成から、3個のstreamを同じExecutionへまとめています。 すべてのstreamを必ずpipeへするのではなく、設定に対応するpropertyを型の条件で公開します。
返り値も、ExecutionResultへ統合されています。 closureでstreamを読みながら、stderrだけは文字列へ収集する組み合わせを表せます。 closureの計算結果はclosureResultへ保持し、processの終了結果や収集した出力とは別のfieldになります。 streamを選んだために収集結果を返せないという、以前の返り値の分離を減らしています。
streamのSubprocessOutputSequenceは、OSのpipeを所有するsingle-passな値です。 同じstreamからiteratorを2回作る操作は許さず、複数のconsumerへ暗黙に同じbyte列を複製しません。 textへ変換する.strings()は、複数byteの文字がread bufferの境界で切れた場合も、つなぎ直してdecodeします。 個別のread結果を毎回独立した文字列へ変換する処理では、UTF-8の文字の途中を不正な入力として扱う経路が生じます(1.0のstreamとtext decodeの変更)。
executableの名前とpathは、異なる解決方法
.path(...)は、使用する実行fileの位置を渡します。 .name(...)は、PATHにあるdirectoryを順に探索して実行fileを選びます。 1.0では、subprocessへ渡す環境のPATHを優先し、current directoryや相対的なPATHのentryを暗黙の探索先へ含めません。 名前にpath separatorがある場合も、current directoryからの相対pathとして処理しない規則です。
Windowsでも、PATHが存在する場合は、applicationのdirectoryやsystem directoryへ無条件に探索を広げません。 applicationと一緒に配布したhelperを使うなら、場所をpathで指定する構成になります。 PATHEXTの扱いも揃え、拡張子を置換する代わりに付加する探索を使います。 同じprogram名でも、processへ渡す環境と探索規則が、起動するbinaryを決める条件になります。
SwiftPMはSwift Buildを既定にする
6.4のSwift Package Managerは、Swift Buildを既定のbuild engineとして使います。 --build-systemの既定はswiftbuildで、従来のnativeとxcodeはdeprecatedです。 Swift Buildは、targetのdependencyや実行するbuild operationを扱うengineです。 package manifestが表すdependencyを、platformに応じたcompileとlinkのjobへ移す層に関する変更です(SwiftPM 6.4の紹介)。
manifestを同じSwiftで書けることと、各OSで必要なtoolchainやSDKが同じであることは異なります。 Swift Buildを共通のengineへしても、C/C++のcompiler、platformのlinker、SDKのAPIはtargetの条件に従います。 AndroidもSwiftPMのSwift Buildから扱えるようになり、以前のpost-install scriptへ依存する設定を減らしています。 packageのgraphとplatformのbuild処理の接続を、同じengineで管理する範囲が広がっています。
package graphとbuild graphからSBOMを生成する
SwiftPMには、Software Bill of Materialsを生成する機能が加わりました。 swift build --sbom-spec cyclonedx --sbom-spec spdxで、対応する形式のJSONを生成できます。 productへ使われるcomponentの関係を、packageの名前だけでなく、productのdependencyまで含めて表せます。 manifestとlockfileを読むだけのtoolでは欠けていた、実際のproductが使う関係を得るための追加です(SE-0509)。
package graphは、解決されたdependencyを表します。 platform固有の条件はbuild時に評価されるため、package graphだけでは、target OSで使わないcomponentも残る場合があります。 Swift Buildのbuild graphを使う版は、条件の評価後に必要なcomponentを選びます。 同じlockfileから複数のproductをbuildする場合も、productごとの実際のdependencyを表す情報が増えます。
swift build --jobs 2 --sbom-spec cyclonedx --sbom-spec spdx
Swift 6.4のmacOS版が生成する形式は、CycloneDX 1.7とSPDX 3.0.1です。 schema bundleを含まない配布物では、JSONを生成してもschema validationを省略します。 当該条件で両方の形式に出るwarningは、次の診断です。
Bundle 'SwiftPM_SBOMModel' with schemas not found - skipping SBOM validation
SBOMは、再compileのないincremental buildでも生成します。 同じproductを異なるflagでbuildした場合の結果を残すため、file名へtimestampを付けます。 --productで対象productを選べますが、--targetとの組み合わせは対象にしません。 packageの部品であるtargetだけへ限定する指定と、配布するproductの構成を表す指定が異なるためです。
swift package generate-sbomは、buildせずにpackage graphから生成する入口です。 build graphのplatform条件を使った結果と同じ精度を持つ、という契約ではありません。 build後にdependencyを再解決すると、すでに作ったbinaryとは別のgraphになる可能性もあります。 --disable-automatic-resolutionは、lockfileが更新を必要とする場合に失敗させ、無条件の再解決を避ける指定です。
debug情報は、module名から正確なdependency参照へ移る
LLDBでstoredな値を表示する場合と、computed propertyを評価する場合は、必要な処理が異なります。 computed propertyの評価はfunction呼び出しなので、LLDBのexpression evaluatorがSwift codeをcompileして実行します。 型を定義したmoduleを、実際にprogramをbuildしたときと整合する形でimportする必要があります。 6.4は、明示的にbuildしたmoduleのdependencyを追う仕組みを使い、名前だけに基づく探索を減らします(module trackingの変更)。
以前は、Darwinのlink時に-add_ast_pathでbinary Swift moduleを列挙していました。 LinuxやWindowsでは、-modulewrapでmoduleの内容をobject fileへ包み、binaryへ含める方法がありました。 多数のmoduleを含むprogramでは、SDKの一部までdebug用の生成物へ入り、fileの大きさが増えます。 同じmodule名にprivate版、公開interface版、異なるtarget版があれば、名前だけで必要な実体を選ぶ問題も残ります。
新しい構成では、binary moduleがSwiftの明示的なdependencyを記録します。 object fileのdebug情報には、自分のmoduleのpathを渡す-debug-module-pathを使います。 Swift driverはcompile jobへpathを渡すため、SwiftPMやXcodeを使う通常の構成では、利用者がfileごとの指定を追加する必要を減らしています。 Swift frontendを直接呼ぶ独自build systemは、各jobへ同じ情報を渡す必要があります。
6.4以降のexplicit module buildでは、-modulewrapや-add_ast_pathへ依存する処理を外せます。 DarwinのdSYMにはbinary Swift moduleを格納しない構成になります。 binary moduleは作成したcompilerの正確なversionへ依存するため、長期保存するdebug情報と同じ安定した形式ではありませんでした。 moduleへの参照と、変数を読むためのreflection metadataを分け、debug情報を構成します。
function呼び出しなどの複雑なexpressionの評価には、binary moduleを引き続き使います。 同じmachineで直前にbuildしたprogramなら、元の位置やremap先からmoduleを探せます。 moduleを含めないdSYMを保存しただけで、任意の別machineへ必要なmodule一式まで自動で移す構成ではありません。 distributed buildでは、moduleのpathも既存のpath remappingの対象になります。
bridging headerのimportも、正確なexplicit moduleの情報を使います。 以前のLLDBはheaderをsourceからcompileし直していましたが、6.4ではprecompiledなheaderとdependencyを直接importする経路を持ちます。 headerの内容を評価時に再構築する処理を減らし、programをbuildしたときのmoduleへ接続します。 debug情報のサイズ削減と、expression evaluationが使う型の一致を、同じdependency管理の変更で扱っています。
C/C++との境界でも、pointerとlifetimeを型へ移す
CのAPIをSwiftから実装する場合は、@cと@implementationを組み合わせる形があります。 C headerの宣言に対する実装を提供する場合と、Swiftから新しくC向けの宣言を生成する場合を分けます。 @implementationを付けない@cのfunctionでは、compilerが生成headerへ宣言を出します。 pointerとcountを受け取るAPIには、Spanを使うsafeなwrapperを生成する構成もあります(6.4の相互運用の変更)。
pointerとcountを別の引数にすると、領域と長さの関係を守る責任が呼び出し側へ残ります。 pointerが指す領域よりcountが大きい場合や、領域の所有者が先に破棄された場合、引数のmachine型が一致しても有効なaccessにはなりません。 Spanは、領域と要素数、lifetimeの関係をSwift側の型へ移します。 境界で必要な情報をannotationから得られる場合に、安全なaccessを持つwrapperへ接続する構成です(safe interoperabilityの仕様)。
C++20のstd::spanと、SwiftのSpanの間にもbridgeがあります。 同じ連続領域を扱うviewを、手動でpointerとcountへ分解し直す処理を減らします。 viewは領域を所有するcontainerではないため、渡したstd::spanやSpanだけを、元のstorageのlifetimeより長く保持できる意味ではありません。 返り値が入力やthisに依存する場合は、依存を表すlifetimeの情報が必要です。
C++のtypeが所有する値と、内部の値への参照を返すmethodでは、Swift側が持つlifetimeの関係が異なります。 参照を返すmethodから得たviewは、元のC++ objectのmutationや破棄に影響されます。 safe interoperabilityは、条件を記述できるAPIをsafeな形へimportし、根拠を持たない参照を無条件に安全と扱う仕組みではありません。 sourceのannotationと生成するwrapperが、境界で維持する契約になります。
module名が型名で隠れる問題には、ModuleName::Declarationというmodule selectorがあります。 ModuleName.Typeでは、ModuleName自体が同名の型へ解決される場合がありますが、::はmoduleを選ぶ構文です。 SE-0491の実装版はSwift 6.3なので、6.4で初めて使える機能とは数えません。 6.4の公開紹介にも含まれる機能ですが、既存の6.3 codeから移行する際の新規構文とは異なります(SE-0491の採用版と名前解決)。
Java、WebAssembly、Androidの更新
Swift/Java interopは、asyncやthrowingなfunctionを、protocolとcallbackのwrapperから呼ぶ対応を広げています。 普通の直接呼び出しだけでなく、interface越しに呼び出すmethodのbridgeも対象になります。 closureとJavaのRunnableの自動対応、variadic parameterのimport、Java recordへの対応も加わりました。 言語ごとのcallableな値やrecordを、生成するwrapperの公開型へ対応させる変更です(Swift/Java interopの更新)。
WebAssemblyでは、JavaScriptKitを使うbridgeの実装が更新されています。 Swift codeをWasmへcompileする工程と、JavaScriptの値やoperationをWasm側から呼ぶ境界は別に存在します。 6.4のWasm SDKはSwift.orgの配布から追加でき、FoundationのFileManagerもWASIでの対応が改善されています。 FileManagerの追加は、WASIのfile system interfaceが対象です(WasmとWASIの変更)。
Android向けのSwift SDKは、LTSのNDK 30を使う構成になりました。 Swiftのruntime libraryと、既定のNDKを使うpackageへ、Androidのavailability attributeを提供します。 APIが存在するAndroidの版を表す情報と、host上でcompilerを実行できる条件は異なります。 SwiftPMのSwift BuildがAndroidを扱う変更も含め、target SDKの情報をbuildとimportへ伝える範囲を広げています(Android SDKの変更)。
Embedded Swiftは、existentialをclass以外へ広げる
Embedded Swiftは、専用のcompile modeでcode sizeとruntimeの使用量を抑える構成です。 6.4では、AnyObjectに制約したclassのexistentialだけでなく、一般のany PとAnyを扱えます。 structや整数などをprotocolのexistentialへ格納し、protocolのmethodを呼ぶ表現を広げています。 異なる具体型を共通のprotocolとして扱うcontainerも、使用できる範囲へ入ります(Embedded Swift 6.4の詳細)。
ただし、Embedded Swiftのgenericsは、最終的に具体型へspecialiseするcompile modelです。 any Pとしてしか具体型を知らない値へ、任意のgeneric methodを適用する操作まで同時に許可しません。 公式の例でも、existentialの値へgenericなinstance methodを適用する呼び出しは拒否されます。 protocolのnon-genericなmethodを動的に呼ぶ性質と、未知の型を使って新たなgenericな実装を具体化する性質が異なります。
throwsの対応も、existentialの追加へつながります。 従来のEmbedded Swiftは、throws(ParsingError)のような特定の型を投げる書き方を扱っていました。 型を限定しないthrowsはany Errorを投げる意味なので、一般のexistentialへ対応した結果、使用できるようになります。 任意のerrorをboxへ包む場合にはheap allocationが生じ得るため、typed throwsと同じ領域使用になる契約ではありません。
metatypeも、限定した型argumentの用途から、値として保持する用途へ広がりました。 any DefaultInitializable.TypeへInt.selfを格納し、protocolのinitializerを呼ぶ形が使えます。 型をcompile時のparameterとして渡すだけでなく、protocolの条件を持つmetatypeの値を扱います。 動的なdispatchやmetadataを使う機能は、実際に使用した箇所のcode sizeと実行経路へ反映されます。
浮動小数点の文字列parseも、Swiftによる再実装によってEmbeddedで利用できます。 concurrency libraryは、throwing taskやthrowing task groupを扱う範囲を広げています。 単にasyncなfunctionを呼べることと、child taskのerrorを回収することを、同じ追加として省略しません。 EmbeddedRestrictionsのwarning groupは、target全体で、Embedded向けの制約に関係する診断を選ぶ入口です。
Swift TestingとXCTestの失敗を取りこぼさない
ST-0021は、Swift TestingとCorelibs XCTestの相互運用を定めています。 以前は、Swift Testingのtestから既存のXCTAssert helperを呼ぶと、assertionの失敗を報告しない場合がありました。 移行後のtestが成功して見えても、検査の失敗が別framework側へ消える問題です。 6.4では、対応するassertionの失敗をtestのissueとして伝える処理が加わります(ST-0021)。
反対方向でも、XCTestのtestから呼ぶ#expectや#requireなどを、対応する失敗として扱います。 ただし、両frameworkのすべてのAPIを同じ意味へ変換する設計ではありません。 たとえばSwift TestingでXCTSkipを投げると失敗として現れるため、静かに失敗を失うassertionと同じ移行対象にはしていません。 XCTestExpectationやXCTWaiterも、Swift concurrencyのcontextへ無条件に持ち込む対象ではありません。
CustomTestReflectableは、期待が失敗したときに表示する値の情報を調整するprotocolです。 通常のdebug表示をprogram全体で変える代わりに、testのdiagnosticに必要な表示を提供します。 大きいdomain objectの内部全体を出すより、比較している値の意味へ沿った情報を出す入口になります。 表示する内容の変更と、期待を評価して成功・失敗を決める処理は分離されています(ST-0022)。
test caseごとの反復も加わりました。 suite全体を単純に同じ回数だけ再実行する代わりに、個別caseの反復条件を扱います。 6.4.1では、warningやknown issueをtest failureと誤って扱い、反復方針へ影響させる問題が修正されました。 失敗を再実行する条件を、報告されたissueの種類へ合わせる修正です(ST-0024、反復判定のPR #1924)。
Observationでは、fine-grainedな変更の追跡とcontinuousな通知を扱うAPIが増えています。 1回の変更後に追跡を張り直す処理に加え、値の変化を継続して受け取る処理を表します。 FoundationのProgressManagerにも、Swift concurrencyのasync/awaitへ接続するAPIが追加されています。 非同期の処理と進捗・変更の通知を、callbackだけに限定せず扱う範囲の追加です(SE-0506、SF-0023)。
6.4.1で修正する生成codeとruntimeの経路
6.4.1では、pointerを通じたlocal variableへの書き込みを、alias analysisが誤って削除するmiscompileを修正しました。 MutableSpanのようなviewから値を書いた場合も、元のlocal variableと同じstorageへaccessしている関係が必要です。 書き込み先を別の領域だと誤認すると、後続の読み取りへ必要な値を、生成codeへ残せない場合があります。 sourceの所有検査とは別に、optimizerが表現するaliasの関係を修正しています(optimizerのPR #92631)。
-Osizeとcross-module optimizationで、複数の[weak self] closureがSIL verificationの失敗を起こす問題も修正されました。 LoopInvariantCodeMotionがassignmentを誤った位置へ動かし、release buildのcompilerを失敗させる問題も対象です。 最適化を有効にしたcompileで、closureの表現や代入の位置を変える経路へ関わります。 構文を新しく採用したsourceだけに限定する修正ではありません(weak captureのPR #92707、代入の移動に関するPR #92506)。
Linuxのbacktracerには、libcのsymbolがinstallされているときのDWARF parseでcrashする問題の修正があります。 SwiftPMでは、PubGrubがdecision nodeを修復する際の無限loopと、既定のpackage traitの扱いによる解決失敗を修正しました。 FoundationではDTDやnamespace nodeのproperty、URLSessionが送るConnection: keep-alive headerの扱いを更新しています。 Swift Testingには、exit testが非有限の浮動小数点値をcaptureする対応も入っています(6.4.1の修正範囲)。
6.4の新しいcleanupや所有のAPIは、sourceに表す契約を増やします。 6.4.1のoptimizerやdependency resolverの修正は、同じ契約を持つsourceをbuildする実装へ反映されます。 noncopyableなcollection、lifetime付きのview、非同期の終了処理を採用したprogramでは、型検査と生成codeの両方が動作の条件になります。