NLLB-200をLoRAで日英翻訳に特化させた話

Share

はじめに

言語処理100本ノック 2025 (Rev 1)は、東北大学の乾・鈴木研究室が公開している自然言語処理(NLP)の演習問題集である。UNIXコマンドによるテキスト処理、正規表現、形態素解析、単語ベクトル、ニューラル機械翻訳など、全100問を通じてNLPの基礎から応用までを体系的に学ぶことができる。

言語処理100本ノック
言語処理100本ノックは、実用的でワクワクするような課題に取り組みながら、自然言語処理、大規模言語モデル、プログラミング、研究のスキルを楽しく習得することを目指した問題集です。

本記事では、第10章の課題であるニューラル機械翻訳モデルの構築について、実装の詳細と得られた知見を記録する。

💡
事前学習済み翻訳モデル NLLB-200 に LoRA(Low-Rank Adaptation)を適用し、KFTTデータでファインチューニング。Google Colab(A100 GPU)で約3.5時間の学習により、テストデータで BLEU 22.09 を達成した。

課題「自分だけの翻訳エンジンを作る」

KFTTデータセット

手元にあるのは、京都フリー翻訳タスク(KFTT)のデータセットだけである。KFTTはGraham Neubig氏が整備した日英機械翻訳の評価用データセットで、NICTが制作した「Wikipedia日英京都関連文書対訳コーパス」をベースとしており、CC BY-SA 3.0ライセンスで公開されている。京都関連のWikipedia記事を対象とした日本語と英語の対訳がセットになっている。

データの規模は以下のとおりである。

  • 学習データ 約44万文(日本語12.0M単語、英語11.5M単語)
  • 開発データ 1,166文
  • テストデータ 1,160文

このデータセットを用いて翻訳モデルを構築するのが本課題の目的である。対象が京都関連の百科事典テキストであるため、歴史・文化に関する専門用語、固有名詞の翻字、日本語特有の概念の意訳など、一般的な翻訳タスクと比較して難易度が高い。

制約と目標

  • 実行環境 Google Colab(NVIDIA A100-SXM4-40GB)
  • 学習時間 3〜4時間以内
  • 目標 BLEUスコア15以上

NLLB-200の選択

翻訳タスクには翻訳に特化したモデルを

ベースモデルとして、Meta社の NLLB-200(No Language Left Behind)を選択した。NLLBは200以上の言語に対応した多言語翻訳モデルであり、Fairseqフレームワーク上で構築されている。

GitHub - facebookresearch/fairseq at nllb
Facebook AI Research Sequence-to-Sequence Toolkit written in Python. - GitHub - facebookresearch/fairseq at nllb

モデル選択の動機はシンプルで、翻訳タスクであれば翻訳に特化したモデルを使うべきだという判断である。汎用的な大規模言語モデル(LLM)をファインチューニングするアプローチもあり得るが、NLLBは最初から翻訳のために設計・訓練されているため、少ないデータと短い学習時間でドメイン適応が可能になる。なお、NLLBは2022年公開のモデルであり、変化の激しいこの分野においては最新とは言えない。ファインチューニング前提であれば、より新しい汎用モデルを選ぶアプローチも有効である。

Dense, MoE, Distilled

NLLB-200にはいくつかのバリエーションが公開されている。

  • MoE(Mixture of Experts) は、複数の専門家ネットワーク(サブネットワーク)を持ち、入力に応じて一部だけを選択的に使用するアーキテクチャ。精度は高いが、モデルサイズが大きい
  • Dense(密結合モデル) は、通常のTransformerで、全パラメータが毎回の計算に参加する。シンプルで安定しているが、MoEと比較するとメモリ効率は相対的に劣る
  • Distilled(蒸留モデル) は、大規模モデルの知識をコンパクトなモデルに転写したもの

今回選択したのは NLLB-200-distilled-600M、すなわちDense構造の蒸留版(約6億パラメータ)である。6億パラメータの全てが毎トークンの処理に使われる。Colab環境で学習可能なサイズでありながら、蒸留により大規模モデルの翻訳知識を引き継いでいる。

NLLBはエンコーダ・デコーダ構造(Seq2Seq)を採用しており、入出力の言語は言語コードトークン(日本語 jpn_Jpan、英語 eng_Latn)で明示的に指定する。

日本語テキスト
    ↓
SentencePiece トークナイザー
    ↓
NLLB-200 エンコーダ
    ↓
NLLB-200 デコーダ (+LoRA)
    ↓
ビーム探索
    ↓
英語テキスト

GPUメモリとの戦い

A100のメモリアーキテクチャ

今回使用したNVIDIA A100は、プロセッサ(GPU)の隣にHBM2eメモリを80GB搭載している。モデルの学習では、このメモリにモデル本体だけでなく、オプティマイザの状態や勾配も保持する必要がある。限られたメモリに「できるだけコンパクトに、でも精度は落とさずに」モデルを収めることが課題になる。

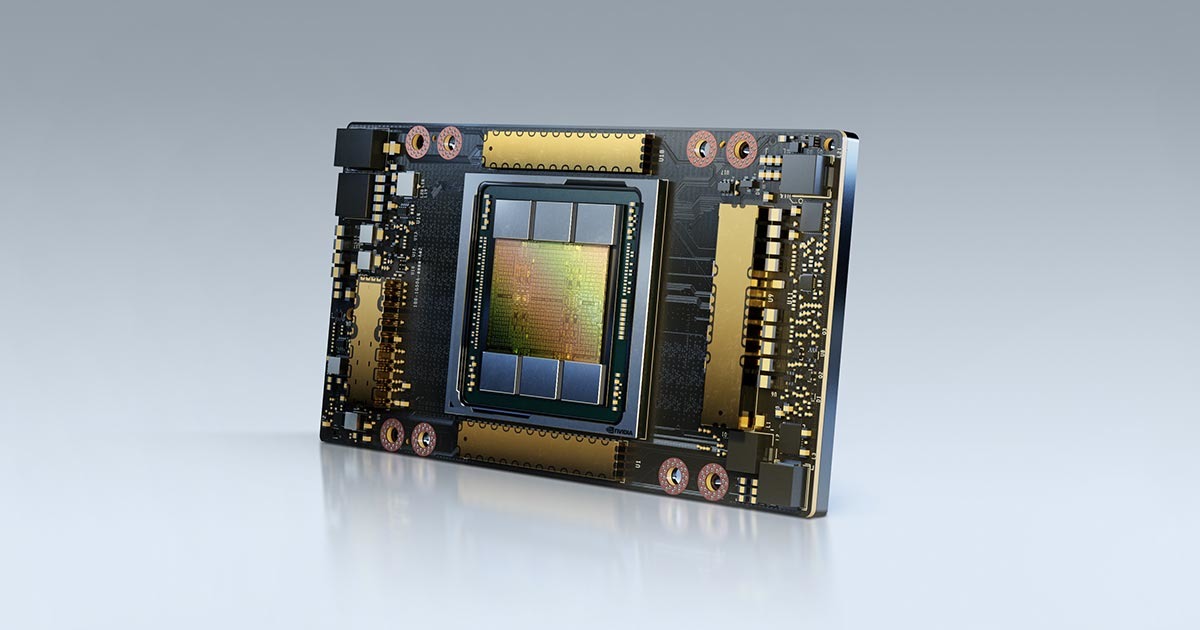
NVIDIA A100 GPU は最新式のデータ センターにパワーを与える
AI および HPC 用として最速のデータ センター プラットフォーム。

混合精度訓練(FP16)

計算精度を保ちつつ高速に処理するために、混合精度訓練(FP16)を使用した。通常のFP32(32ビット浮動小数点)の代わりにFP16(16ビット)で計算することで、メモリ使用量を半減させ、A100のTensor Coreによる高速演算を活用できる。精度を維持しつつ低いビット数で計算する手法は広く確立されており、現在のディープラーニング訓練では標準的な設定である。

LoRA(パラメータの効率的な更新)

6億パラメータの全てをFP16で格納しても約1.2GBだが、学習時にはオプティマイザの状態(Adamの場合、各パラメータにつき2つの追加変数)や勾配の保持が必要になり、メモリ消費は数倍に膨れ上がる。ここで導入するのがLoRA(Low-Rank Adaptation)である。

LoRAはMicrosoft Researchが論文で提案した手法で、元の重み行列 \(W_0\) を固定し、低ランクの更新行列 \(\Delta W = BA\) のみを学習するというアイデアである。 \(B\) と \(A\) はランク \(r\) の行列であり、 \(r\) を元の次元より十分に小さく設定することで、更新パラメータ数を劇的に削減できる。推論時は \(W_0 + BA\) を事前に統合しておけば、追加の計算コストは発生しない。
LoRA: Low-Rank Adaptation of Large Language Models
An important paradigm of natural language processing consists of large-scale pre-training on general domain data and adaptation to particular tasks or domains. As we pre-train larger models, full fine-tuning, which retrains all model parameters, becomes less feasible. Using GPT-3 175B as an example -- deploying independent instances of fine-tuned models, each with 175B parameters, is prohibitively expensive. We propose Low-Rank Adaptation, or LoRA, which freezes the pre-trained model weights and injects trainable rank decomposition matrices into each layer of the Transformer architecture, greatly reducing the number of trainable parameters for downstream tasks. Compared to GPT-3 175B fine-tuned with Adam, LoRA can reduce the number of trainable parameters by 10,000 times and the GPU memory requirement by 3 times. LoRA performs on-par or better than fine-tuning in model quality on RoBERTa, DeBERTa, GPT-2, and GPT-3, despite having fewer trainable parameters, a higher training throughput, and, unlike adapters, no additional inference latency. We also provide an empirical investigation into rank-deficiency in language model adaptation, which sheds light on the efficacy of LoRA. We release a package that facilitates the integration of LoRA with PyTorch models and provide our implementations and model checkpoints for RoBERTa, DeBERTa, and GPT-2 at https://github.com/microsoft/LoRA.

今回の設定は以下のとおりである。

  • ランク(r) 32
  • スケーリング係数(alpha) 64
  • 適用対象 Attention層のQuery, Key, Value, Output射影行列
  • ドロップアウト率 0.05
from peft import LoraConfig, get_peft_model

lora_config = LoraConfig(
    r=32,
    lora_alpha=64,
    target_modules=["q_proj", "v_proj", "k_proj", "out_proj"],
    lora_dropout=0.05,
    bias="none",
    task_type="SEQ_2_SEQ_LM"
)

model = get_peft_model(model, lora_config)
💡
訓練対象パラメータは約940万個(全体の 1.51%)に限定。LoRAアダプターのファイルサイズは約36MBで、ベースモデル本体(約2.5GB)と比較して運用面でも効率的である。

残りの98.5%のパラメータは固定されるため、事前学習で獲得した汎用的な翻訳知識が保持される。

コサイン減衰スケジューラーによる学習戦略

学習率の制御

学習率のスケジューリングにはコサイン減衰(Cosine Annealing)を採用した。調整可能なハイパーパラメータは主に3つである。

  • \(\eta_{max}\)(最大学習率)はコサインカーブのピークとなる学習率で、今回は \(3 \times 10^{-4}\)
  • \(\eta_{min}\)(最小学習率)はコサインカーブの底の学習率で、デフォルトは0
  • \(T_{max}\)(周期の長さ)は、何ステップでコサインカーブを1周するかを指定する
CosineAnnealingLR — PyTorch 2.10 documentation
CosineAnnealingLR# class torch.optim.lr_scheduler.CosineAnnealingLR(optimizer, T_max, eta_min=0.0, last_epoch=-1)[source]# Set the learning rate of each parameter group using a cosine annealing schedule. The learning rate is updated recursively using: ηt+1=ηmin⁡+(ηt−ηmin⁡)⋅1+cos⁡((Tcur+1)πTmax)1+cos⁡(TcurπTmax)\eta_{t+1} = \eta_{\min} + (\eta_t - \eta_{\min}) \cdot \frac{1 + \cos\left(\frac{(T_{cur}+1) \pi}{T_{max}}\right)} {1 + \cos\left(\frac{T_{cur} \pi}{T_{max}}\right)} ηt+1​=ηmin​+(ηt​−ηmin​)⋅1+cos(Tmax​Tcur​π​)1+cos(Tmax​(Tcur​+1)π​)​This implements a recursive approximation of the closed-form schedule proposed in SGDR: Stochastic Gradient Descent with Warm Restarts: ηt=ηmin⁡+12(ηmax⁡−ηmin⁡)(1+cos⁡(TcurπTmax))\eta_t = \eta_{\min} + \frac{1}{2}(\eta_{\max} - \eta_{\min}) \left( 1 + \cos\left(\frac{T_{cur} \pi}{T_{max}}\right) \right) ηt​=ηmin​+21​(ηmax​−ηmin​)(1+cos(Tmax​Tcur​π​))where: ηt\eta_tηt​ is the learning rate at step ttt TcurT_{cur}Tcur​ is the number of epochs since the last restart TmaxT_{max}Tmax​ is the maximum number of epochs in a cycle Note Although SGDR includes periodic restarts, this implementation performs cosine annealing without restarts, so Tcur=tT_{cur} = tTcur​=t and increases monotonically with each call to step(). Parameters: optimizer (Optimizer) – Wrapped optimizer. T_max (int) – Maximum number of iterations. eta_min (float) – Minimum learning rate. Default: 0. last_epoch (int) – The index of the last epoch. Default: -1. Example >>> num_epochs = 100 >>> scheduler = CosineAnnealingLR(optimizer, T_max=num_epochs) >>> for epoch in range(num_epochs): >>> train(...) >>> validate(...) >>> scheduler.step() get_last_lr()[source]# Get the most recent learning rates computed by this scheduler. Returns: A list of learning rates with entries for each of the optimizer’s param_groups, with the same types as their group[“lr”]s. Return type: list[float | Tensor] Note The returned Tensors are copies, and never alias the optimizer’s group[“lr”]s. get_lr()[source]# Compute the next learning rate for each of the optimizer’s param_groups. Scales the group[“lr”]s in the optimizer’s param_groups such that their learning rates approximate eta_min+12(base_lr−eta_min)(1+cos⁡(π⋅last_epochT_max))\texttt{eta\_min} + \frac{1}{2} (\texttt{base\_lr} - \texttt{eta\_min}) \left(1 + \cos\left(\pi \cdot \frac{\texttt{last\_epoch}}{\texttt{T\_max}}\right) \right) eta_min+21​(base_lr−eta_min)(1+cos(π⋅T_maxlast_epoch​)) Returns: A list of learning rates for each of the optimizer’s param_groups with the same types as their current group[“lr”]s. Return type: list[float | Tensor] Note If you’re trying to inspect the most recent learning rate, use get_last_lr() instead. Note The returned Tensors are copies, and never alias the optimizer’s group[“lr”]s. load_state_dict(state_dict)[source]# Load the scheduler’s state. Parameters: state_dict (dict) – scheduler state. Should be an object returned from a call to state_dict(). state_dict()[source]# Return the state of the scheduler as a dict. It contains an entry for every variable in self.__dict__ which is not the optimizer. Return type: dict[str, Any] step(epoch=None)[source]# Step the scheduler. Parameters: epoch (int, optional) – Deprecated since version 1.4: If provided, sets last_epoch to epoch and uses _get_closed_form_lr() if it is available. This is not universally supported. Use step() without arguments instead. Note Call this method after calling the optimizer’s step().

ウォームアップ

学習の最初から学習率を全開にすると、重みが大きく壊れてしまうことが知られている。そこで、全ステップの5%(約1,700ステップ)をウォームアップ期間とし、学習率を0から \(\eta_{max}\) まで線形に増加させた。ウォームアップの後は、コサイン関数に従って学習率を \(\eta_{min}\) に向けて滑らかに減衰させる。

学習が進むにつれてモデルが覚えるべきことは減っていき、微細な調整のフェーズに移行する。コサイン減衰はこの過程を自然に表現しており、後半では小さな学習率で精密な最適化が行われる。

その他の設定

  • バッチサイズ 64
  • エポック数 5(データセット全体を5周)
  • 重み減衰 0.01(L2正則化として機能し、過学習を抑制する)
  • 総ステップ数 約34,400

訓練には約3.5時間を要した。

実験結果

翻訳品質

BLEUスコア(ビーム幅5で評価)は以下のとおりである。

  • 開発データ BLEU 21.01
  • テストデータ BLEU 22.09
💡
目標のBLEU 15に対し、テストデータで BLEU 22.09 を達成。BLEUスコアの一般的な目安で「実用的な品質」(15〜25)の範囲に到達した。

以下に翻訳例を示す。

入力:道元(どうげん)は、鎌倉時代初期の禅僧。
正解:Dogen was a Zen monk in the early Kamakura period.
出力:Dogen was a Zen priest in the early Kamakura period.

「僧」を "monk" ではなく "priest" と訳している差異はあるが、文構造は正確であり自然な英語が生成されている。"monk" と "priest" はいずれも禅僧の英訳として用いられることがあり、文脈依存の翻訳揺れである。

入力:曹洞宗の開祖。
正解:The founder of Soto Zen
出力:He was the founder of the Soto sect.

前文の文脈を引き継いで主語 "He" を補い、完全な文として出力している。正解が名詞句であるのに対し、モデルは主語付きの文を生成しており、翻訳としてはより自然ともいえる。

ビーム探索の最適化

デコード時のビーム幅を変化させ、翻訳品質への影響を調べた。計算コストを抑えるため、二段階方式を採用した。

  1. 第一段階 200文のサンプルで6パターン(ビーム幅1, 2, 3, 5, 7, 10)を評価し、候補を絞り込む
  2. 第二段階 上位3つ(ビーム幅10, 7, 2)を全開発データ(1,166文)で検証

全開発データでの結果は以下のとおりである。

  • ビーム幅2 BLEU 21.05
  • ビーム幅7 BLEU 21.15
  • ビーム幅10 BLEU 21.31(最良)

ビーム探索は、各タイムステップで上位 \(k\) 個(ビーム幅)の候補を保持しながらデコードを行う手法である。ビーム幅1の場合は各ステップで最も確率の高いトークンだけを選ぶ貪欲探索(Greedy Search)になる。ビーム幅を大きくすると、より多くの候補を並行に探索するため翻訳品質が向上する傾向がある一方、計算時間もビーム幅に比例して増加する。

今回の実験では、ビーム幅を2から10に増やしても改善幅は0.26ポイントにとどまっており、このモデルとデータにおいてはビーム探索による追加の改善余地が限定的であることを示している。

学習曲線の分析

Training LossとValidation Lossはいずれも学習を通じて安定的に減少し、5エポック終了時点でValidation Lossは約1.51に収束した。後半のエポックにおけるValidation Lossの減少が緩やかであることから、5エポックはこのモデルとデータ規模において十分な学習量であったと判断できる。Training LossとValidation Lossの乖離は限定的であり、重大な過学習は観察されなかった。

実際の学習データから得られた学習率のグラフも、ウォームアップからコサイン減衰への滑らかな遷移を確認でき、設計どおりの学習が行われていた。

サブワード分割について

NLLBのトークナイザーはSentencePieceベースのBPE(Byte Pair Encoding)によるサブワード分割を採用している。形態素解析器(MeCabなど)に依存せずに日本語テキストを分割できるため、言語固有の前処理が不要になる。

「京都御所は日本の歴史的建造物です。」(17文字)を分割すると、以下の10トークンが得られる。

▁ / 京都 / 御 / 所は / 日本の / 歴史的 / 建造 / 物 / です / 。

「京都」や「歴史的」のように意味的にまとまった単位で分割される場合もあれば、「所は」のように助詞が先行する名詞と結合される場合もある。形態素解析とは異なる分割基準だが、翻訳タスクにおいてはデータ駆動で最適化された分割が有効に機能する。

サブワード分割の利点として、未知語を既存のサブワードの組み合わせで表現できる点がある。辞書にない固有名詞であっても文字単位まで分解すれば表現可能であり、語彙外(OOV)問題を回避できる。また、複数言語間で共通のサブワードを共有できるため、多言語モデルとの親和性が高い。

今後の改善の方向性

  • モデルスケール NLLB-1.3Bなど大規模モデルの使用による品質向上。ただしColab環境ではメモリ制約があるため、量子化(4bit/8bit)との併用が必要になる
  • 汎用LLMの活用 NLLBのような翻訳特化モデルではなく、最新の汎用LLMをファインチューニングするアプローチも検討に値する。事前学習で獲得した広範な言語理解能力が、翻訳品質の向上に寄与する可能性がある
  • データ拡張 バックトランスレーション(英日の逆翻訳で擬似的な学習データを生成する手法)によるデータ増強
  • 評価指標の多様化 BLEUは表層的なn-gram一致を測定するため、意味的な翻訳品質を十分に捉えられない場合がある。COMETなどのニューラル評価指標を併用することで、より信頼性の高い品質評価が可能になる
  • Detokenization 本実験ではトークン化済みデータをそのまま評価に使用したが、適切なdetokenization処理を追加することで、BLEUスコアの正確性を改善できる

実行環境

  • ハードウェア Google Colab(NVIDIA A100-SXM4-40GB, HBM2e 80GB)
  • Python 3.12
  • 主要ライブラリ PyTorch 2.8.0, Transformers 4.57.0, PEFT, Datasets 4.0.0, sacrebleu
  • ベースモデル facebook/nllb-200-distilled-600M
  • データセット KFTT v1.0
  • 参考教材 言語処理100本ノック 2025 (Rev 1)

Read more

Dependabotの対応が面倒なのでRenovateを導入する

Dependabotくんはある程度の依存関係の更新を通知してくれるが、山のようにprojectを抱えているとなんとも痒いところに手が届かない。 ということで、Renovateを使ってみる。 Build software better, togetherGitHub is where people build software. More than 150 million people use GitHub to discover, fork, and contribute to over 420 million projects.GitHub ここからGitHub Appを入れる。 あとは、指示に従ってポチポチするだけで、超かんたんだった。 感想 自動化最高。

By Sakashita Yasunobu

nodejsのバグを見つけたのでPRを投げてみた

概要 要するに、node --testで特定のバイナリを標準出力に書くと、テストランナーが固まったり、異常終了したりするバグです。 バグ自体は既知のものだったようで、修正がされていました。 test_runner: infinite loop in FileTest#drainRawBuffer when child stdout contains FF 0F followed by large size bytes · Issue #62693 · nodejs/nodeVersion v25.9.0 (also reproduced on v24.14.1 LTS, v22.21.0 LTS, v23.4.0) Platform Darwin 25.

By Sakashita Yasunobu
青空文庫のParser

青空文庫のParser

青空文庫のParserを作ってます。 GitHub - P4suta/aozora: Pure-functional Rust parser for 青空文庫記法 (Aozora Bunko notation): ルビ, 傍点, 縦中横, 外字, 返り点, indent containers, page breaks.Pure-functional Rust parser for 青空文庫記法 (Aozora Bunko notation): ルビ, 傍点, 縦中横, 外字, 返り点, indent containers, page breaks. - P4suta/aozoraGitHubP4suta Rustで作ってますが、配布物はcargoのほかにnpm/pypiでも入手できます Documentation * Playground — try it in

By Sakashita Yasunobu